Introducción
Cuando un modelo de IA prepara una respuesta extensa, esperar a recibir el resultado completo puede hacer que una aplicación parezca bloqueada. El streaming permite que la aplicación reciba pequeños fragmentos en cuanto están listos. Es parecido a leer un mensaje mientras la otra persona todavía lo está escribiendo: la respuesta completa requiere aproximadamente el mismo trabajo, pero el texto útil aparece antes.
En este laboratorio usará Server-Sent Events (SSE), un formato de texto para enviar una secuencia de eventos en una única respuesta HTTP. Cada evento de Workers AI comienza con data:. Los eventos de texto contienen una parte de la respuesta generada, y un evento final data: [DONE] indica que el stream terminó correctamente. Una pausa entre eventos solo significa que el modelo sigue trabajando; sin una señal de finalización, la aplicación no puede distinguir entre una respuesta lenta y una conexión que nunca terminará.
Creará POST /help, transmitirá una respuesta de Llama alojada en Cloudflare a un cliente de línea de comandos proporcionado y probará dos formas de finalización: una finalización normal y una cancelación deliberada después del primer fragmento útil. Cancelar significa que el cliente ya no necesita el resto de la respuesta y cierra el trabajo en lugar de dejar abierta una conexión que no utiliza. También usará pruebas deterministas para demostrar que un fallo al iniciar el modelo se convierte en un error limitado y que un stream interrumpido termina en lugar de quedar bloqueado.
Este es el segundo laboratorio del curso. Se supone que ya sabe que un Cloudflare Worker es código de aplicación que se ejecuta en la red de Cloudflare y que un binding AI expone Workers AI como env.AI. Si accedió directamente a este curso, complete primero Conectar LabEx a su cuenta de Cloudflare para aprender a usar la terminal de la VM, autorizar Wrangler, confirmar su cuenta de aprendizaje y guardar su ID de cuenta.
El laboratorio usa @cf/meta/llama-3.3-70b-instruct-fp8-fast y preguntas sintéticas pequeñas. Actualmente, las cuentas gratuitas de Workers reciben una asignación diaria compartida de 10.000 Neurons. La inferencia local también se conecta con Cloudflare y consume esa asignación. Si la asignación se agota o el modelo no tiene capacidad disponible, deténgase en lugar de enviar solicitudes repetidas; la aplicación debe informar de un error terminal en vez de quedar bloqueada.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0 local del proyecto en /home/labex/project/help-stream. También proporciona el cliente SSE, fixtures deterministas y comprobaciones independientes. La configuración no inicia sesión, no invoca un modelo, no implementa un Worker ni crea recursos en la nube. Mantenga abierta esta VM hasta eliminar el Worker desechable y verificar el cierre de sesión.
Autorizar la VM y configurar el Worker de streaming
En este paso autorizará esta VM nueva y configurará el Worker de streaming desechable. Haber iniciado sesión en el Dashboard no concede automáticamente permiso a los comandos de la terminal para administrar la cuenta de aprendizaje.
Acceda al proyecto preparado y confirme la versión fijada de Wrangler:
cd /home/labex/project/help-stream
npx wrangler --version
Debe aparecer 4.132.0. Solicite únicamente los permisos necesarios para este laboratorio. El acceso de escritura a Workers Scripts permite administrar el Worker desechable; el acceso de escritura a Workers AI permite que su binding invoque el modelo; y los dos ámbitos de lectura identifican la cuenta seleccionada. Wrangler 4.132.0 también inspecciona las dependencias de los bindings de KV al eliminar un Worker, por lo que el ámbito limitado de escritura de KV permite que ese comando de limpieza termine aunque este laboratorio no cree datos de KV.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Abra el enlace que se muestra, introduzca el código del dispositivo actual, revise la cuenta y los permisos, y autorice la cuenta de aprendizaje. También puede aparecer Background Access porque Wrangler continúa después de cerrar el navegador. Vuelva a la terminal y espere el mensaje de éxito. Después, consulte los datos estructurados de identidad:
npx wrangler whoami --json
Confirme loggedIn: true y lea los valores name e id de la cuenta correcta. Genere un nombre único para el Worker desechable:
RUN="labex-c07-a02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Sustituya YOUR_ACCOUNT_ID por el ID real de esa cuenta:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["enable_request_signal"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
El binding AI estará disponible como env.AI. remote: true significa que el desarrollo local seguirá usando el modelo real en la nube. enable_request_signal hace que request.signal indique cuándo el cliente se desconecta, lo que permite al Worker registrar y gestionar la señal de cancelación. Observability guarda los eventos del ciclo de vida que consultará más adelante. Todavía no se ha implementado ningún Worker ni se ha ejecutado ninguna inferencia.
Inspeccionar el binding de IA y el cliente SSE
En este paso conectará el binding de IA al cliente SSE proporcionado antes de escribir el Worker. El modelo es el productor, el Worker reenvía los bytes y client.mjs es el consumidor. Mantener estos roles separados deja claro qué componente debe cerrar el trabajo.
Genere los tipos del entorno del Worker:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Busque AI: Ai. Esto significa que el binding configurado estará disponible para el controlador como env.AI; no es una clave de API almacenada en el código fuente.
Ahora revise los resultados finales que puede producir el cliente en la terminal:
grep -nE 'chunk:|complete chunks=|cancelled after|stream_error:' client.mjs
El cliente lee la respuesta fragmento a fragmento. Una línea chunk: muestra el texto recién generado. complete aparece únicamente después de recibir data: [DONE]. El modo de cancelación cierra el lector después del primer fragmento no vacío. stream_error indica un fallo terminal, incluido un tiempo de espera de 45 segundos; ese tiempo de espera es un límite de seguridad, no una predicción de que todas las respuestas del modelo deban tardar tanto.
Un evento SSE es texto simple separado por una línea en blanco. Un stream correcto típico tiene este aspecto:
data: {"response":"First piece"}

data: {"response":" and another piece."}

data: [DONE]
Los límites de los fragmentos son detalles del transporte: un evento puede contener una palabra, signos de puntuación o un fragmento más largo. La lógica de la aplicación debe combinar las cadenas response y esperar a [DONE]; no debe suponer una cantidad ni un tamaño fijo de fragmentos.
Crear un endpoint de streaming monitorizado
En este paso creará el endpoint de streaming y su supervisión del ciclo de vida. El Worker solicitará al modelo un stream con stream: true y expondrá ese mismo protocolo SSE al cliente. No recopilará primero toda la respuesta en memoria. Un pequeño wrapper supervisa el ciclo de vida del stream: la finalización lo cierra normalmente, la cancelación cancela el reader ascendente y un error del stream termina la respuesta.
Cree el punto de entrada del Worker:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_QUESTION = 800;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readQuestion(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "question_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) {
    return { error: json({ error: "invalid_question" }, 400) };
  }
  if (question.length > MAX_QUESTION) {
    return { error: json({ error: "question_too_large" }, 413) };
  }
  return { question };
}

function monitor(upstream, details) {
  const reader = upstream.getReader();
  let terminal = false;

  return new ReadableStream({
    async pull(controller) {
      try {
        const { done, value } = await reader.read();
        if (done) {
          terminal = true;
          console.log(JSON.stringify({ event: "help_stream_completed", ...details }));
          controller.close();
          return;
        }
        controller.enqueue(value);
      } catch {
        terminal = true;
        console.error(JSON.stringify({ event: "help_stream_failed", ...details }));
        controller.error(new Error("model stream interrupted"));
      }
    },
    async cancel(reason) {
      if (!terminal) {
        terminal = true;
        console.log(JSON.stringify({ event: "help_stream_cancelled", ...details }));
      }
      await reader.cancel(reason);
    }
  });
}

async function streamHelp(request, env) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };
  request.signal.addEventListener("abort", () => {
    console.log(JSON.stringify({ event: "help_client_disconnected", ...details }));
  }, { once: true });

  try {
    const upstream = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Answer the support question in at most four short sentences. Give safe, practical steps and do not invent account details."
        },
        { role: "user", content: parsed.question }
      ],
      stream: true,
      max_tokens: 160,
      temperature: 0.2
    });

    if (!(upstream instanceof ReadableStream)) {
      throw new Error("stream unavailable");
    }

    console.log(JSON.stringify({ event: "help_stream_started", ...details }));
    return new Response(monitor(upstream, details), {
      headers: {
        "content-type": "text/event-stream; charset=utf-8",
        "cache-control": "no-store",
        "x-request-id": requestId
      }
    });
  } catch {
    console.error(JSON.stringify({ event: "help_stream_start_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/help") {
      return streamHelp(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
El código registra los ID de solicitud y los eventos del ciclo de vida, pero nunca registra la pregunta ni la respuesta generada. Un ID de solicitud relaciona una respuesta de cliente con una entrada de registro sin copiar el contenido de soporte en los datos de observabilidad. La respuesta de error también oculta los detalles internos del proveedor; los operadores pueden usar el registro del ciclo de vida mientras los clientes reciben el contrato estable model_unavailable.
Ejecute las pruebas deterministas. Su binding de IA simulado emite eventos controlados, falla antes del streaming, admite la cancelación e interrumpe un stream sin consumir Neurons:
node --test test/worker.test.mjs
Deben aprobarse seis pruebas. Después, compile el Worker real sin implementarlo:
npx wrangler deploy --dry-run
Las pruebas demuestran el comportamiento de la aplicación con tiempos controlados. La ejecución en seco demuestra que el código fuente y la configuración se pueden empaquetar juntos. Ninguna de las dos pruebas demuestra que el modelo en la nube esté disponible en ese momento; el siguiente paso utiliza un stream real.
Observar un stream local real
En este paso observará un stream real mediante un proceso de Worker que se ejecuta desde la VM. “Local” describe el controlador de solicitudes; la inferencia del modelo sigue ejecutándose en la cuenta seleccionada y consume su asignación diaria.
Inicie Wrangler en segundo plano y guarde su ID de proceso:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Espere a que esté disponible la ruta de estado que no usa IA:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
Ahora use el cliente proporcionado para enviar una pregunta sintética pequeña:
node client.mjs http://127.0.0.1:8787 \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
Debería ver una o más líneas chunk: seguidas de una línea terminal similar a esta:
complete chunks=18 chars=238
El texto, el número de fragmentos y el número de caracteres serán diferentes. La evidencia importante es recibir contenido incremental no vacío seguido de [DONE], que el cliente convierte en complete. Si aparece stream_error, consulte .labex/dev.log. Un fallo de cuota, autorización o capacidad es una inferencia fallida, no un motivo para esperar indefinidamente.
Por último, demuestre que la validación de la aplicación sigue ejecutándose antes de la inferencia:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/help \
  --header 'Content-Type: application/json' \
  --data '{"question":""}'
Debe obtener {"error":"invalid_question"} y HTTP 400. Un stream solo es útil después de que una solicitud normal supera las comprobaciones de límites.
Implementar, completar y cancelar un stream
En este paso implementará el Worker, completará un stream y cancelará otro después de su primer fragmento útil. Primero, detenga únicamente el proceso de desarrollo guardado y espere a que termine:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Implemente el mismo código del Worker:
npx wrangler deploy
Guarde la URL exacta de workers.dev que muestra Wrangler:
WORKER_URL="https://YOUR_WORKER_URL"
Primero observe una finalización normal:
node client.mjs "$WORKER_URL" \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
La línea final complete significa que el modelo envió [DONE]; recibir solamente el primer fragmento no demostraría que la respuesta está completa.
Ahora inicie un segundo stream y deténgalo deliberadamente después del primer fragmento no vacío:
node client.mjs "$WORKER_URL" \
  "Explain four checks to make before retrying a failed file upload." \
  --cancel-after-first
Debe aparecer una línea chunk: seguida de cancelled after 1 chunk. La cancelación no es un error del modelo: el cliente decidió intencionadamente que ya no necesitaba el resto. Cerrar el reader propaga la cancelación al stream ascendente, mientras que la señal de la solicitud entrante permite al Worker registrar la desconexión.
Abra el Cloudflare Dashboard y vaya a Workers & Pages → Overview → su Worker labex-c07-a02-... → Observability → Logs. Busque las solicitudes recientes. El resumen siguiente corresponde a una ejecución de aceptación desechable: 14 Success y 0 Errors indican que el Worker gestionó sus comprobaciones de estado, los streams completados y las desconexiones deliberadas sin ninguna invocación fallida. Sus totales y marcas de tiempo serán diferentes.
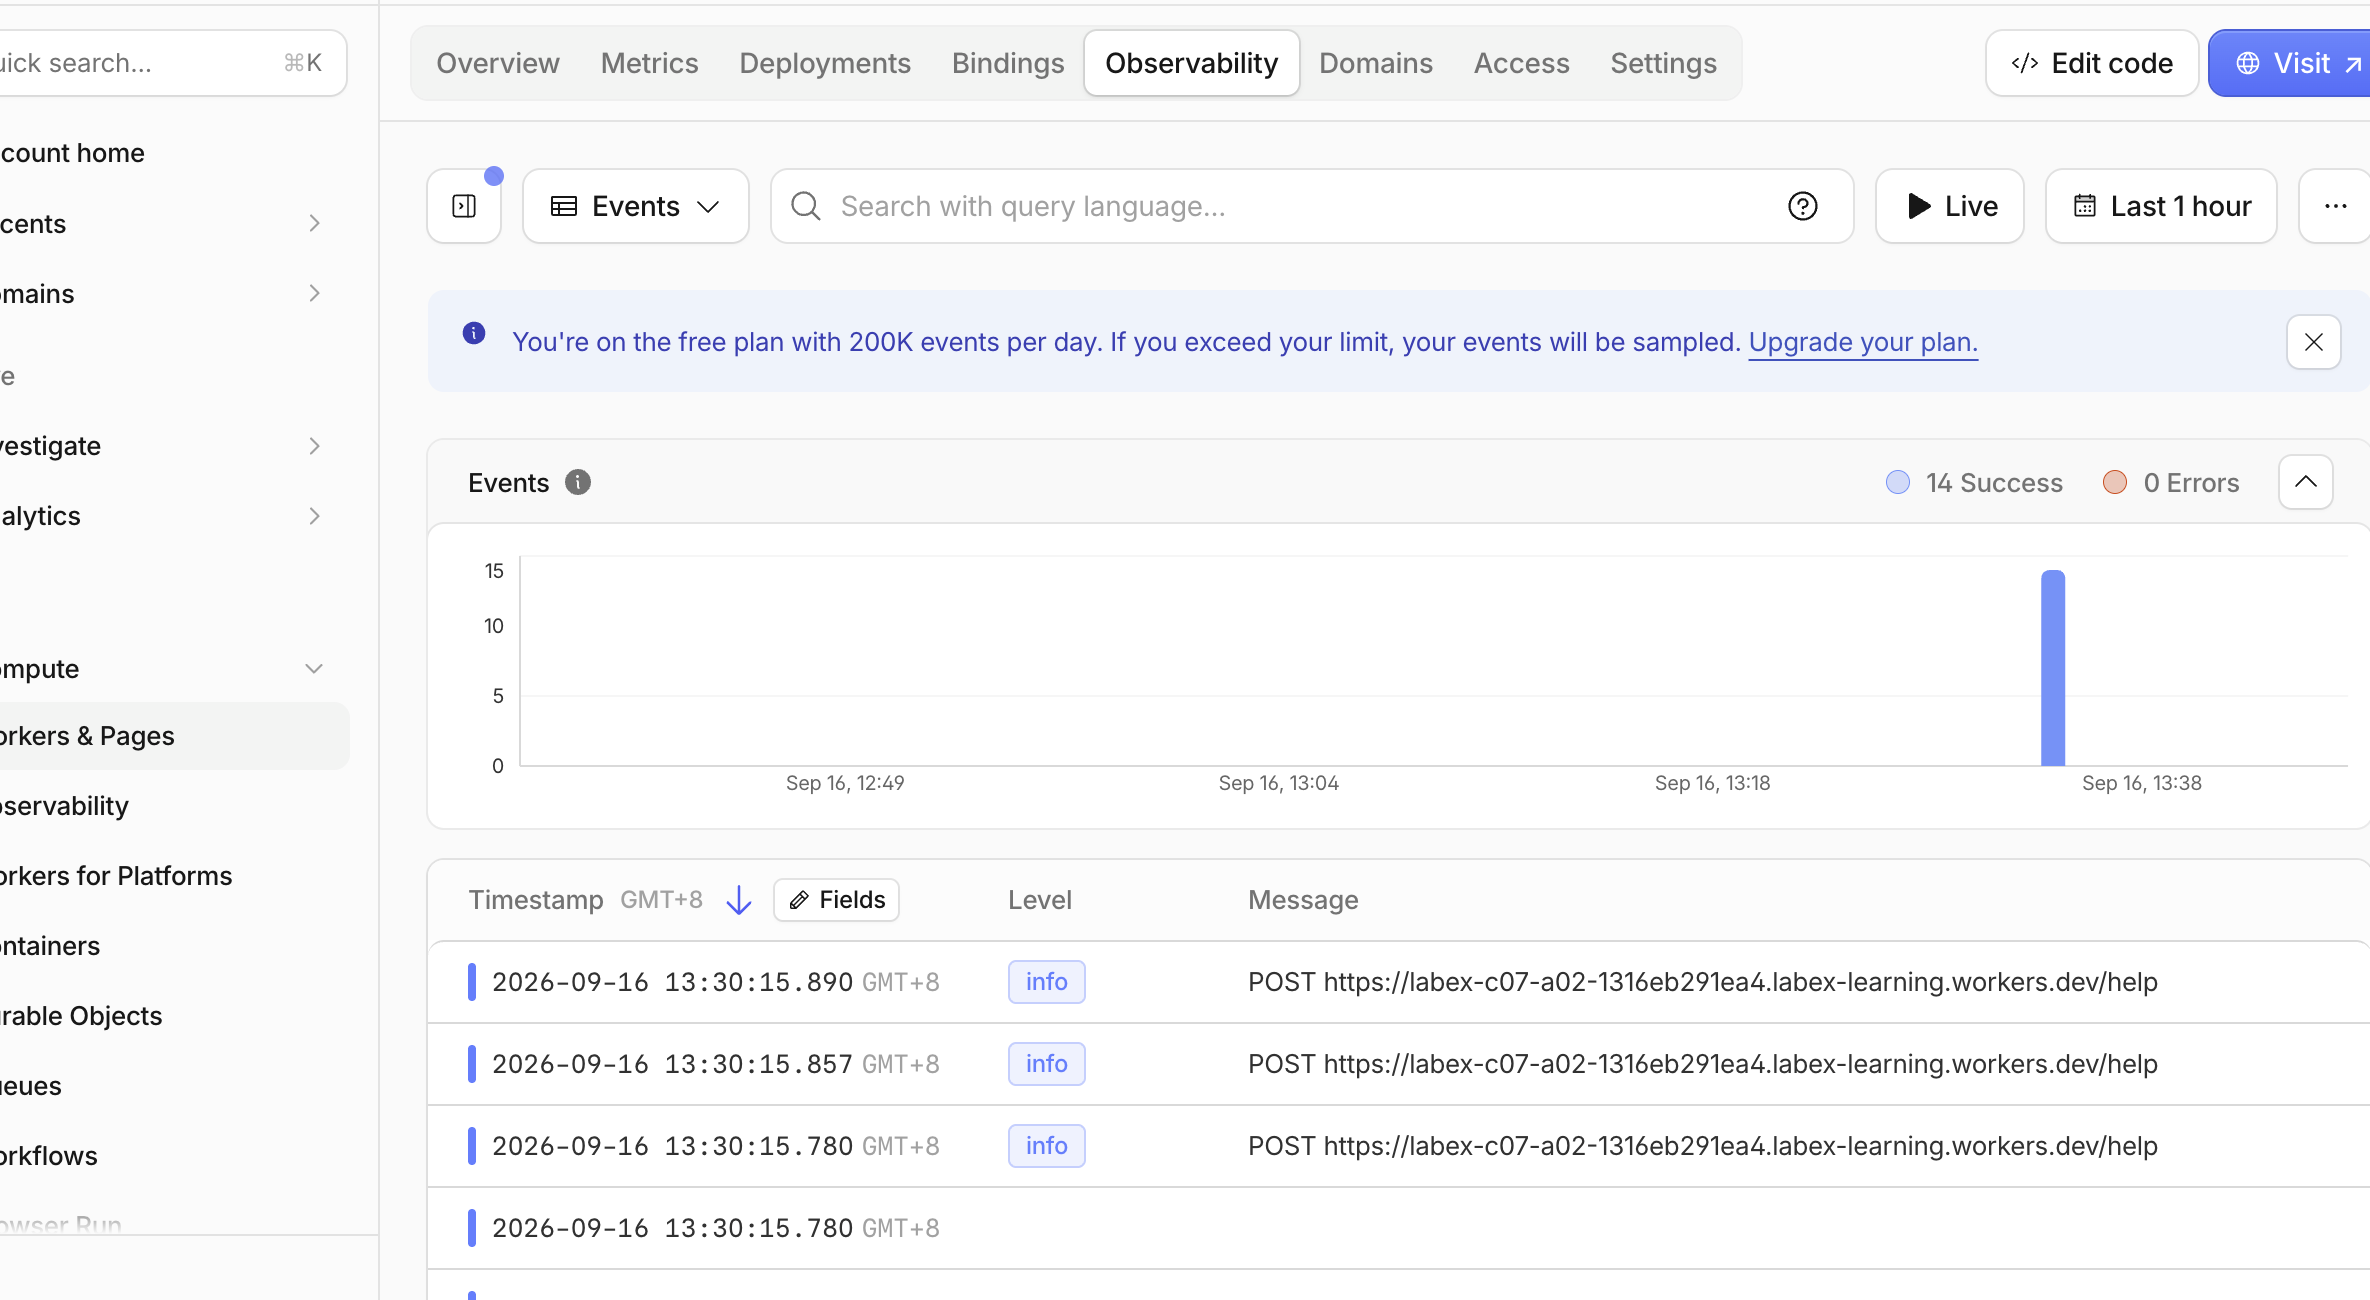
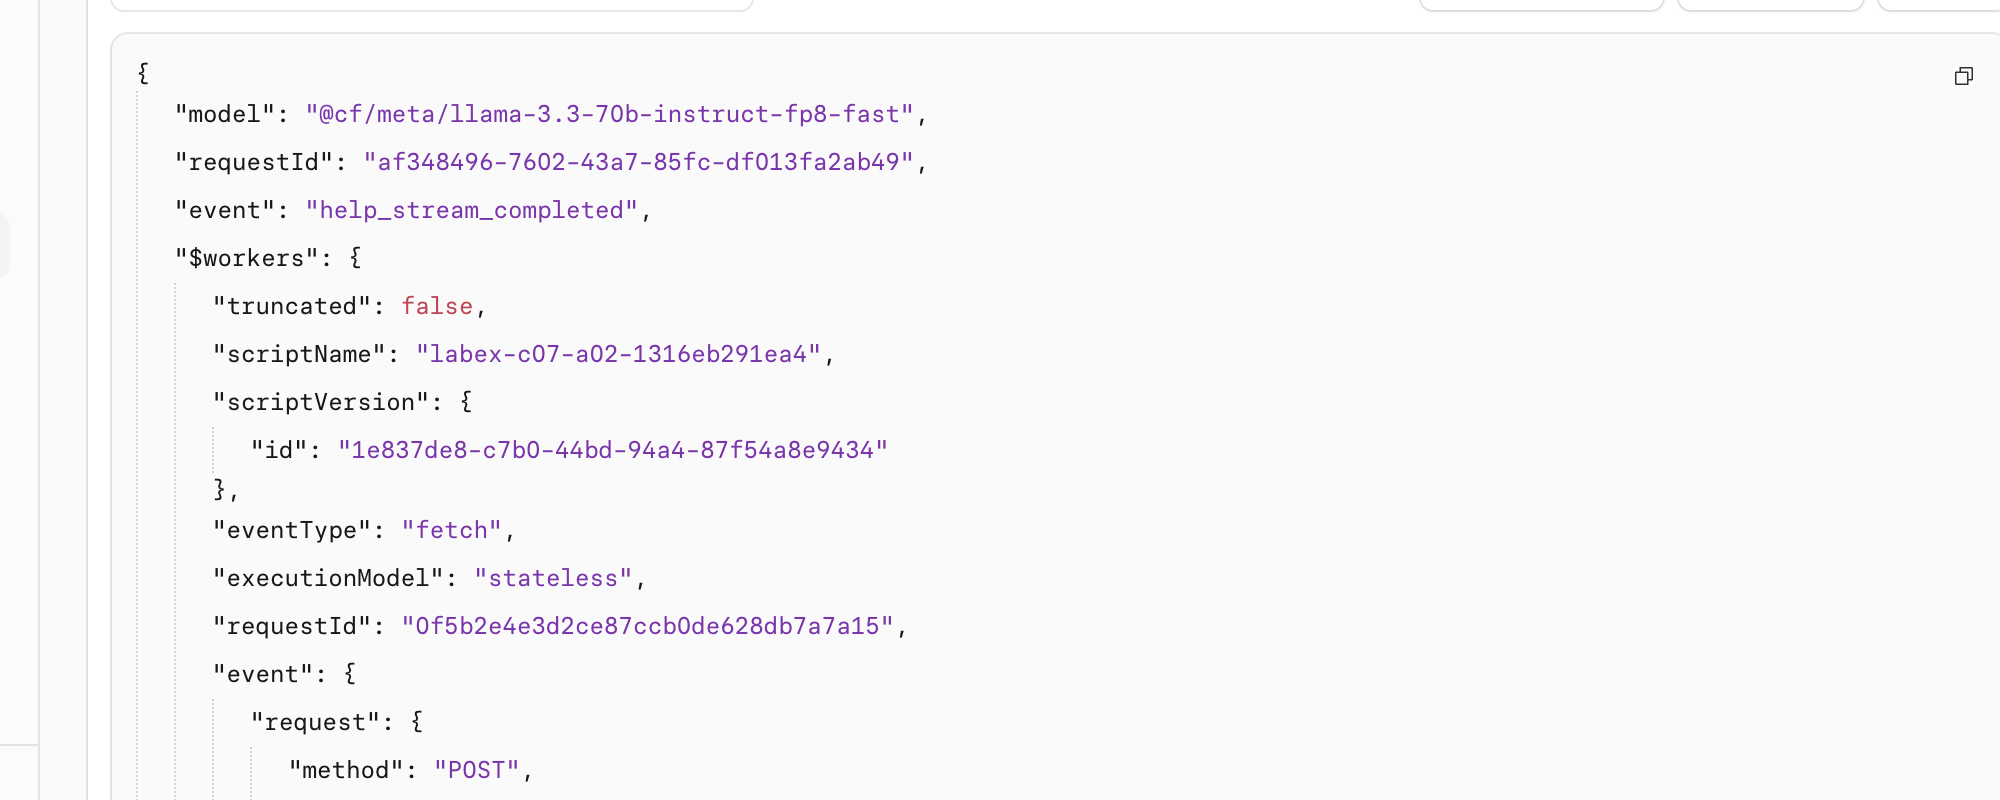
Busque help_stream_completed, expanda uno de los resultados y confirme sus valores model, requestId y event. El ID de solicitud es un valor de correlación seguro: ayuda al operador a relacionar los registros del ciclo de vida sin almacenar la pregunta del estudiante ni la respuesta generada.
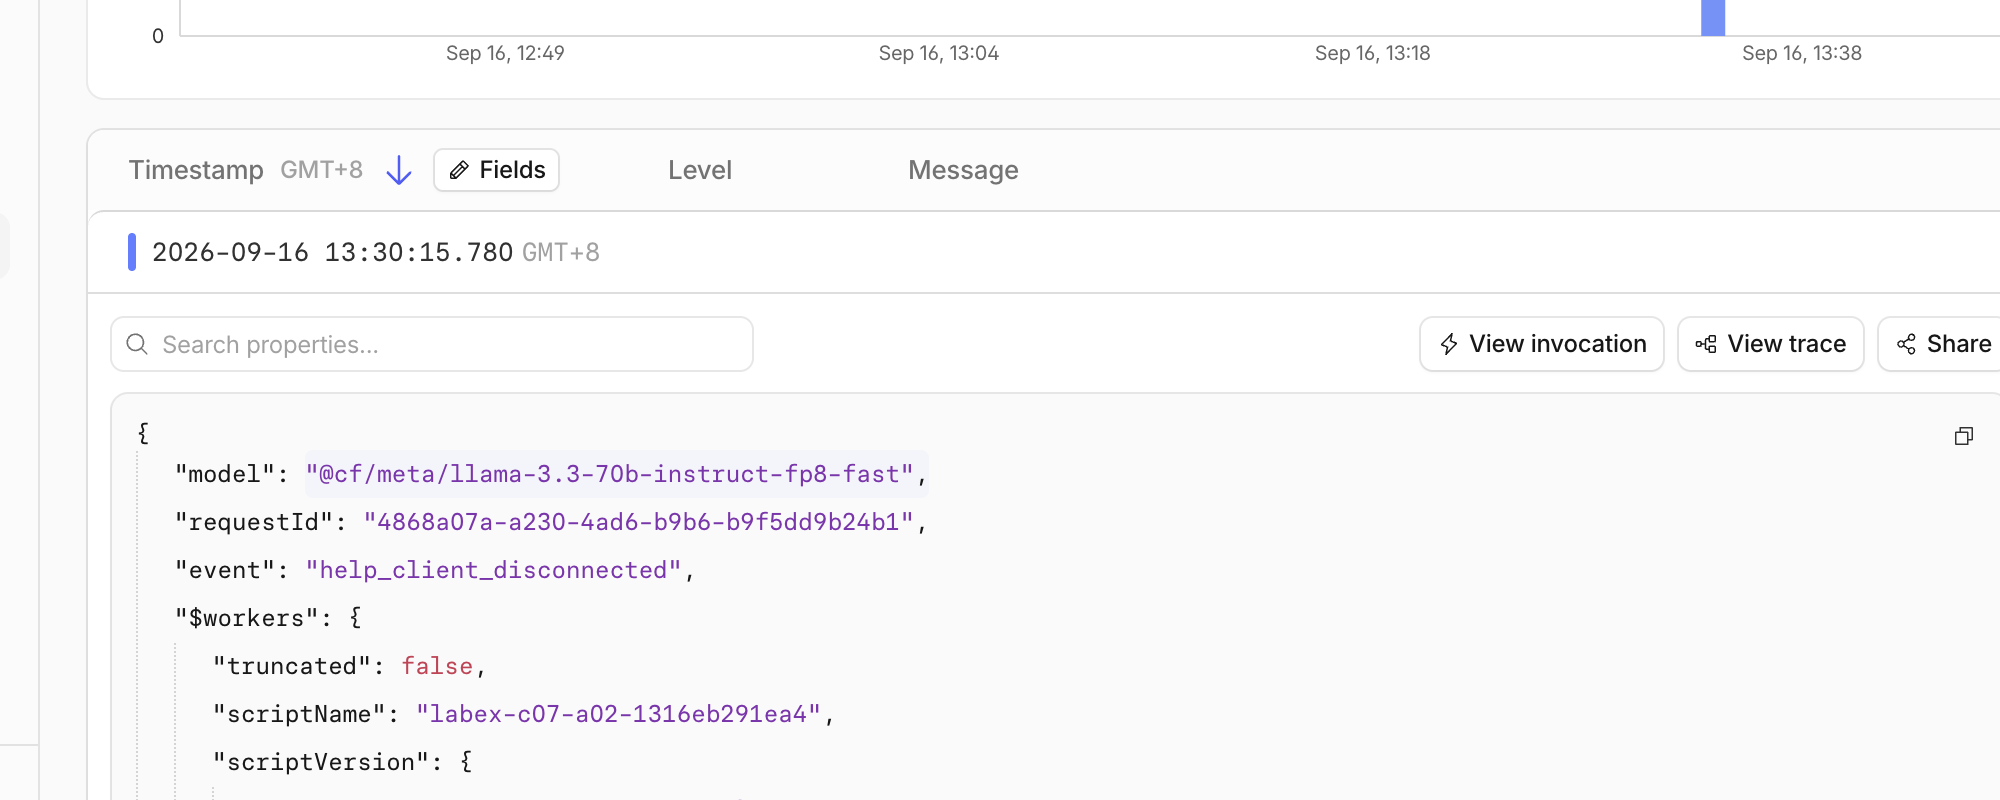
Para la solicitud pública cancelada deliberadamente, busque help_client_disconnected. Con enable_request_signal, ese evento demuestra directamente que el cliente entrante se desconectó. La prueba determinista del paso 4 demuestra por separado que cancel() descendente llega al fixture del modelo y registra help_stream_cancelled; el momento de la red real puede hacer que el evento de señal de solicitud sea el registro visible en la nube. Los registros guardados pueden llegar después de la respuesta, así que espere brevemente y realice como máximo una solicitud de cancelación adicional y limitada si fuera necesario.
Después, abra Workers AI y revise el uso del modelo de hoy. Busque el modelo Llama 3.3 y confirme que los ejercicios pequeños siguen dentro de la asignación gratuita de 10.000 Neurons. En el ejemplo siguiente, todo el trabajo de la cuenta de aprendizaje utilizó 158.03/10k Neurons; esto incluye otros ejercicios de esa cuenta, por lo que su número será diferente. No se necesita un plan Workers Paid para este laboratorio mientras la cuenta permanezca dentro de la asignación gratuita. El uso puede tardar en actualizarse; no repita la inferencia solo para forzar una actualización del gráfico.
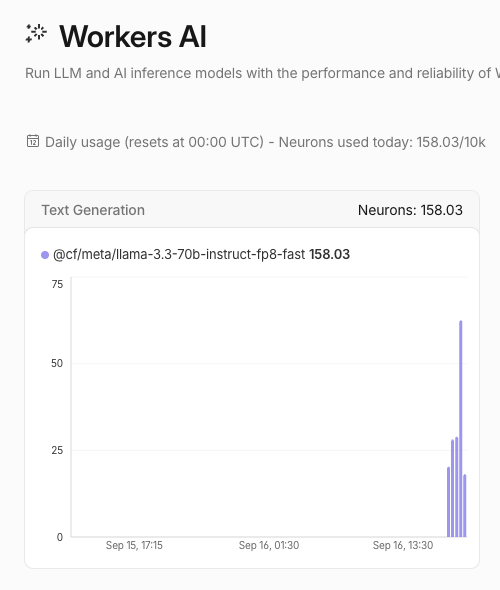
El nombre del Worker, los ID de solicitud, las marcas de tiempo y el uso que aparecen en estas capturas son ejemplos de una ejecución desechable. Los objetivos didácticos son los nombres de los eventos y la relación entre los estados del ciclo de vida, no los valores exactos.
Eliminar el Worker y cerrar la sesión
En este paso eliminará el Worker desechable y cerrará la sesión de esta VM. Los registros de uso de Workers AI son históricos y pertenecen a la cuenta, por lo que eliminar el Worker quita su endpoint público, pero no borra esos registros históricos ni cambia el plan de la cuenta.
Elimine exactamente el Worker cuyo nombre aparece en wrangler.jsonc:
npx wrangler delete
Confirme únicamente cuando Wrangler muestre el nombre único de este laboratorio, labex-c07-a02-.... El comando debe terminar con Successfully deleted. En el Dashboard, actualice Workers & Pages → Overview y confirme que ese nombre exacto ya no aparece.
Mientras la VM siga autorizada, ejecute la comprobación de administración independiente:
python3 .labex/verify.py deleted
Solo después de que muestre PASS: deleted, elimine la autorización almacenada de esta VM:
npx wrangler logout
npx wrangler whoami --json
Debe obtener loggedIn: false. La ausencia de un archivo local, una pestaña del navegador cerrada o un error de red no demostrarían la eliminación en la nube ni el cierre de sesión.
Resumen
Creó un endpoint de Workers AI que reenvía la salida SSE incremental en lugar de almacenar en un búfer una respuesta completa. Aprendió por qué el cliente necesita una señal [DONE] explícita, cómo un tiempo de espera evita una espera indefinida, en qué se diferencia la cancelación deliberada de un fallo y cómo los errores del stream terminan correctamente. Verificó inferencias reales, tanto locales como implementadas, relacionó los eventos del ciclo de vida con la observabilidad del Dashboard, eliminó el Worker desechable y cerró la sesión de la VM nueva.