Introducción
La colección Riverside necesita un índice consultable de seis documentos HTML de historia oral. La herramienta de contenedor proporcionada analiza realmente su HTML y cuenta palabras Unicode, pero su lote de cuatro trabajadores supera un presupuesto de memoria de 160 MiB. Diagnostica ese fallo con evidencia vinculada al contenedor exacto y después produce el índice completo sin aumentar el límite ni eliminar documentos.
Debes conocer los conceptos básicos de Docker run, las rutas de terminal y la finalidad de los montajes enlazados. Este laboratorio explica las opciones de memoria, los ID reales de usuario, las rutas entre comillas, la sustitución de comandos y la pequeña tubería para leer evidencia antes de usarlos. No se requiere programación Python, creación de HTML ni implementación de algoritmos de búsqueda. Docker, la imagen de indexación y Search Desk de solo lectura están preparados.
El corpus es explícitamente sintético: cada documento contiene 10.000 fragmentos didácticos ampliados para hacer observable la presión real de memoria del analizador. El resultado es un índice real de esos bytes, no una asignación simulada ni una garantía de capacidad en producción. Calcula unos 60 minutos, incluidos la lectura y los errores habituales; es una estimación del autor.
Construye el índice completo dentro de su presupuesto
En este paso, establecerás un resultado normal de búsqueda, reproducirás un fallo de memoria limitada, relacionarás evidencia nativa y completarás toda la colección con un lote limitado.
Usa primero un índice normal pequeño
Empieza en Search Desk y selecciona Explore sample. Esta muestra preparada separada contiene dos documentos pequeños. Busca café con Search one word y Search. Ambos registros comparten el título Riverside memories, pero tienen ID distintos que comienzan por sample-oral-. Abre cada registro e inspecciona su hash fuente y los recuentos de palabras seleccionadas; después usa Back to collection. Usa Download index para inspeccionar el archivo JSON real de muestra y después Back to Search Desk.
Los dos paneles separan la muestra preparada de tu colección asignada. Tu índice comienza no disponible:
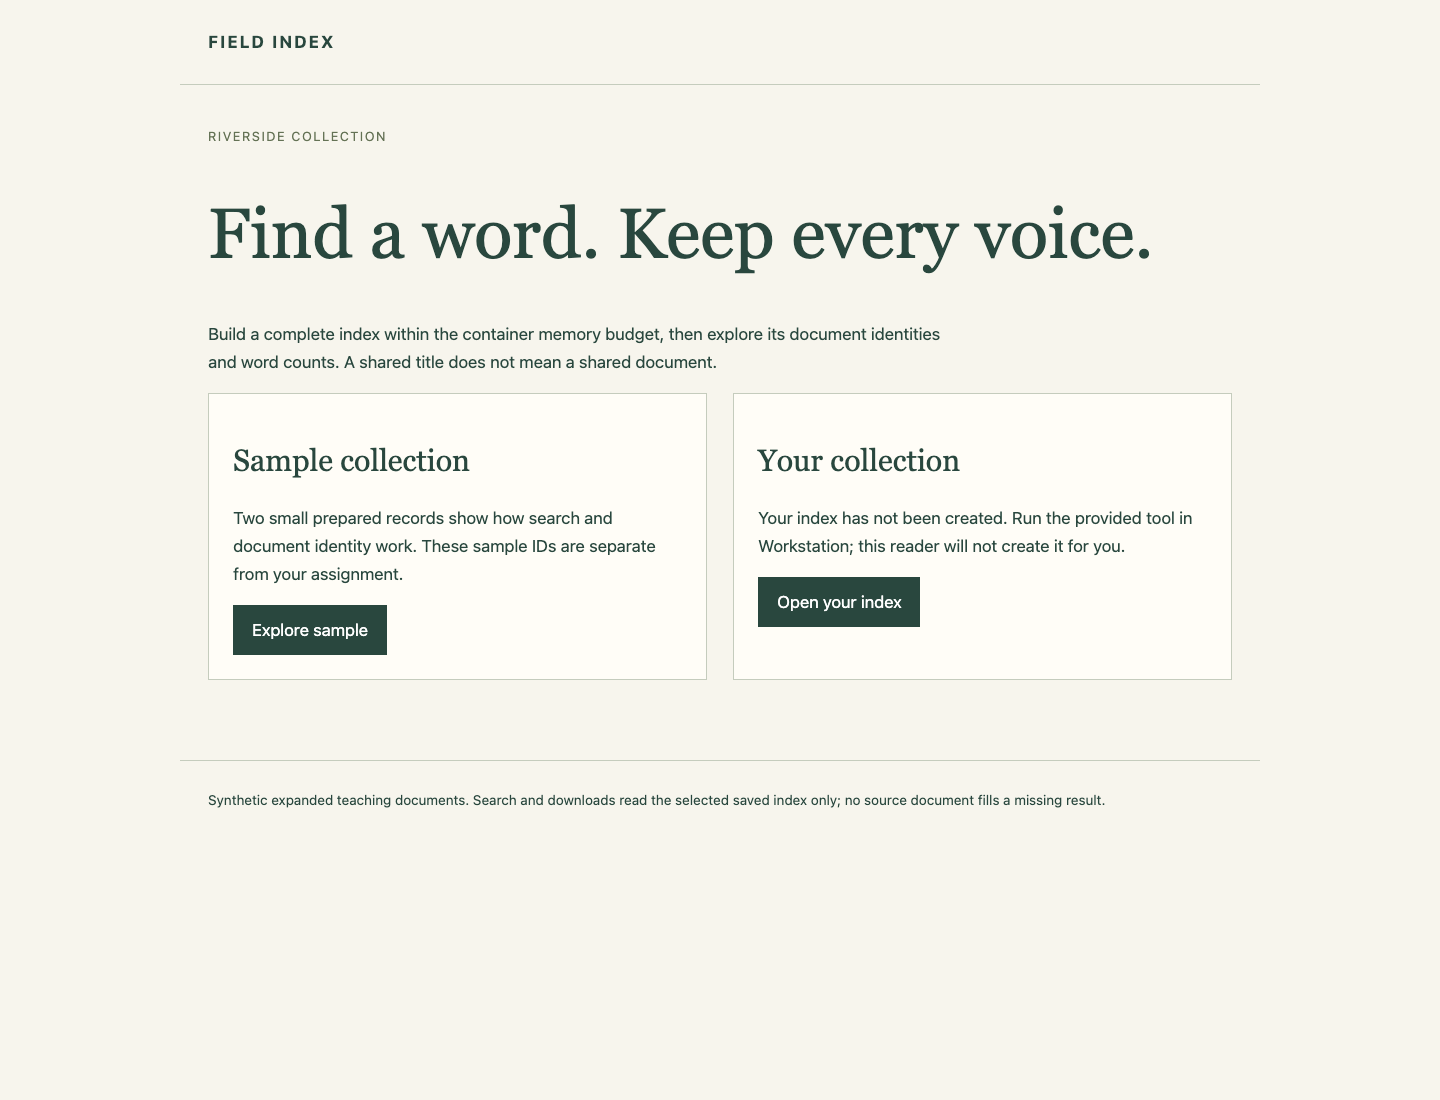
Un índice invertido conecta una palabra con ID de documentos y recuentos de apariciones. Sus metadatos documents registran cada ID, título y SHA-256 fuente, una huella de los bytes originales. Dos registros con el mismo título no deben reducirse a una identidad. El lector usa solo el índice guardado seleccionado; nunca completa trabajo ausente a partir del HTML fuente.
Selecciona Open your index. Actualmente indica Collection not indexed con HTTP 503. La muestra pequeña no es tu resultado de seis documentos.
Comprende las rutas y el límite de memoria
Cambia a Workstation, que comienza en /home/labex/project/collection-index. cd vuelve allí y ls enumera archivos:
cd /home/labex/project/collection-index
ls source output
source/ contiene seis archivos HTML originales. output/ es tu directorio de entrega modificable. Conserva intactos los originales, la imagen preparada dk06-indexer:1 y el lector separado de muestra. Solo crearás contenedores del curso y salida del índice.
El entrypoint de la imagen ya ejecuta su programa de indexación. --source /input, --output /output/attempt.json y --workers 4, después del nombre de la imagen, son argumentos del programa, no opciones de Docker. Los trabajadores analizan HTML real y crean árboles de documentos. Un lote retiene sus árboles seleccionados mientras extrae palabras y luego los libera. Más trabajadores pueden necesitar más memoria; no prometen mayor velocidad.
Las opciones Docker antes del nombre de imagen establecen el límite operativo:
| Opción | Significado aquí |
|---|---|
--name |
Conserva un contenedor con nombre claro para inspección nativa |
--memory 160m |
Impone un presupuesto de RAM de 160 MiB |
--memory-swap 160m |
Fija el total de RAM más swap en la misma cantidad, sin margen adicional de swap |
--network none |
El trabajo de procesamiento de archivos no necesita red |
--user |
Escribe la salida con tu cuenta normal real |
Dos opciones --mount |
Lee solo la entrada original; escribe en la carpeta de salida separada |
id -u e id -g muestran tus ID numéricos reales de usuario y grupo; no supongas 1000. $(...) sustituye la salida de un comando dentro de este comando. Las comillas dobles mantienen el usuario/grupo combinado y cada valor completo de montaje como un argumento, permitiendo a la vez expandir $PWD, el directorio actual. Una barra invertida final une la siguiente línea física al mismo comando.
La entrada source/ del host aparece como /input dentro del contenedor; output/ del host aparece como /output. readonly protege la entrada a través de ese montaje. No añadas otro alias modificable del origen. Conserva ambas opciones de memoria sin cambios y no desactives el terminador OOM ni cambies ajustes de la plataforma.
Reproduce y atribuye el fallo
Ejecuta el intento proporcionado de cuatro trabajadores. Se espera deliberadamente que termine con estado nativo 137 antes de completar su índice:
docker run --name index-attempt \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/attempt.json --workers 4
Puede que solo veas una línea inicial Parsing batch antes de detenerse. Conserva el contenedor detenido: no hay --rm porque importan su identidad y sus ajustes efectivos.
docker inspect lee campos nativos del contenedor. Las comillas simples mantienen literal cada pequeña plantilla de formato. Lee primero el código de salida y la marca OOM de Docker y después ambos límites en bytes:
docker inspect index-attempt --format '{{.State.ExitCode}} {{.State.OOMKilled}}'
docker inspect index-attempt --format '{{.HostConfig.Memory}} {{.HostConfig.MemorySwap}}'
docker logs index-attempt
Los valores de límite configurados son ambos 167772160, es decir, 160 × 1024 × 1024 bytes. La salida 137 por sí sola no distingue este fallo de memoria de una terminación forzada. Debe registrarse la marca OOMKilled de Docker, pero el Engine probado de este laboratorio a veces puede dejarla en false aunque el kernel informe una terminación genuina por memory-cgroup. Contrasta la evidencia real del kernel en lugar de tomar cualquiera de los campos por separado como explicación.
Lee el ID completo del contenedor en una variable del shell. La asignación no lleva espacios alrededor de =; la sustitución de comandos captura el resultado de inspect:
container_id=$(docker inspect --format '{{.Id}}' index-attempt)
La variable pertenece a este shell de Workstation. Cambiar de pestaña del navegador no la cambia; si abres un shell nuevo, repite la asignación. sudo dmesg lee el registro protegido del kernel sin vaciarlo. Una tubería | pasa esa salida a grep; -F selecciona líneas que contienen el ID exacto como texto normal y las comillas conservan su valor como un argumento:
sudo dmesg | grep -F "$container_id"
Busca la línea que contiene CONSTRAINT_MEMCG y una ruta oom_memcg que nombra este ID completo de contenedor Docker. Identifica una acción de falta de memoria en el grupo de control de memoria de este contenedor, en lugar de un proceso ajeno o una escasez de toda la plataforma. Compárala con el intento detenido y sus límites reales. No crees registros falsos ni sustituyas este intento por un proceso terminado manualmente.
Reduce el lote y conserva todo el trabajo
El presupuesto es fijo. Reducir el lote a un trabajador mantiene un árbol de documento realmente analizado cada vez y conserva los seis documentos y el mismo algoritmo de recuento de palabras. Es una opción viable para este corpus, no una afirmación de que un trabajador sea siempre óptimo. Se aceptan otros valores viables de trabajadores si el trabajo completo termina realmente con los mismos límites.
Crea un contenedor separado de entrega que se conserve. Mantén ambos montajes, el entrypoint preparado y las opciones de memoria; cambia el nombre del archivo de salida y la cantidad de trabajadores:
docker run --name index-delivery \
  --memory 160m --memory-swap 160m --network none \
  --user "$(id -u):$(id -g)" \
  --mount "type=bind,src=$PWD/source,dst=/input,readonly" \
  --mount "type=bind,src=$PWD/output,dst=/output" \
  dk06-indexer:1 --source /input --output /output/index.json --workers 1
Espera todos los lotes seguidos de Indexed 6 documents and ... terms y el estado de salida normal 0. El total de términos es una observación, no una prueba por sí sola:
docker inspect index-delivery --format '{{.State.ExitCode}}'
ls -l output/index.json
La salida pertenece a tu usuario/grupo normal y sigue siendo editable después de terminar el contenedor. Conserva ambos contenedores detenidos. Si escribes mal una ruta de entrada, Docker informa que falta el origen del montaje antes de procesar: vuelve al directorio de trabajo indicado, inspecciona ls source output, corrige la ruta entre comillas y repite. No crees una entrada sustituta para ocultar el error.
Usa el índice real entregado
Cambia a Search Desk, selecciona Back to Search Desk si hace falta y después Open your index. Debe mostrar seis documentos indexados, no los dos ID de muestra. Busca café: deben aparecer los seis documentos con 10.000 apariciones cada uno. Abre ambos registros Riverside memories por sus ID distintos oral-0 y oral-1. Sus hashes fuente y relaciones de palabras deben permanecer separados.
La colección entregada contiene los seis ID originales, incluidos ambos registros con el mismo título:
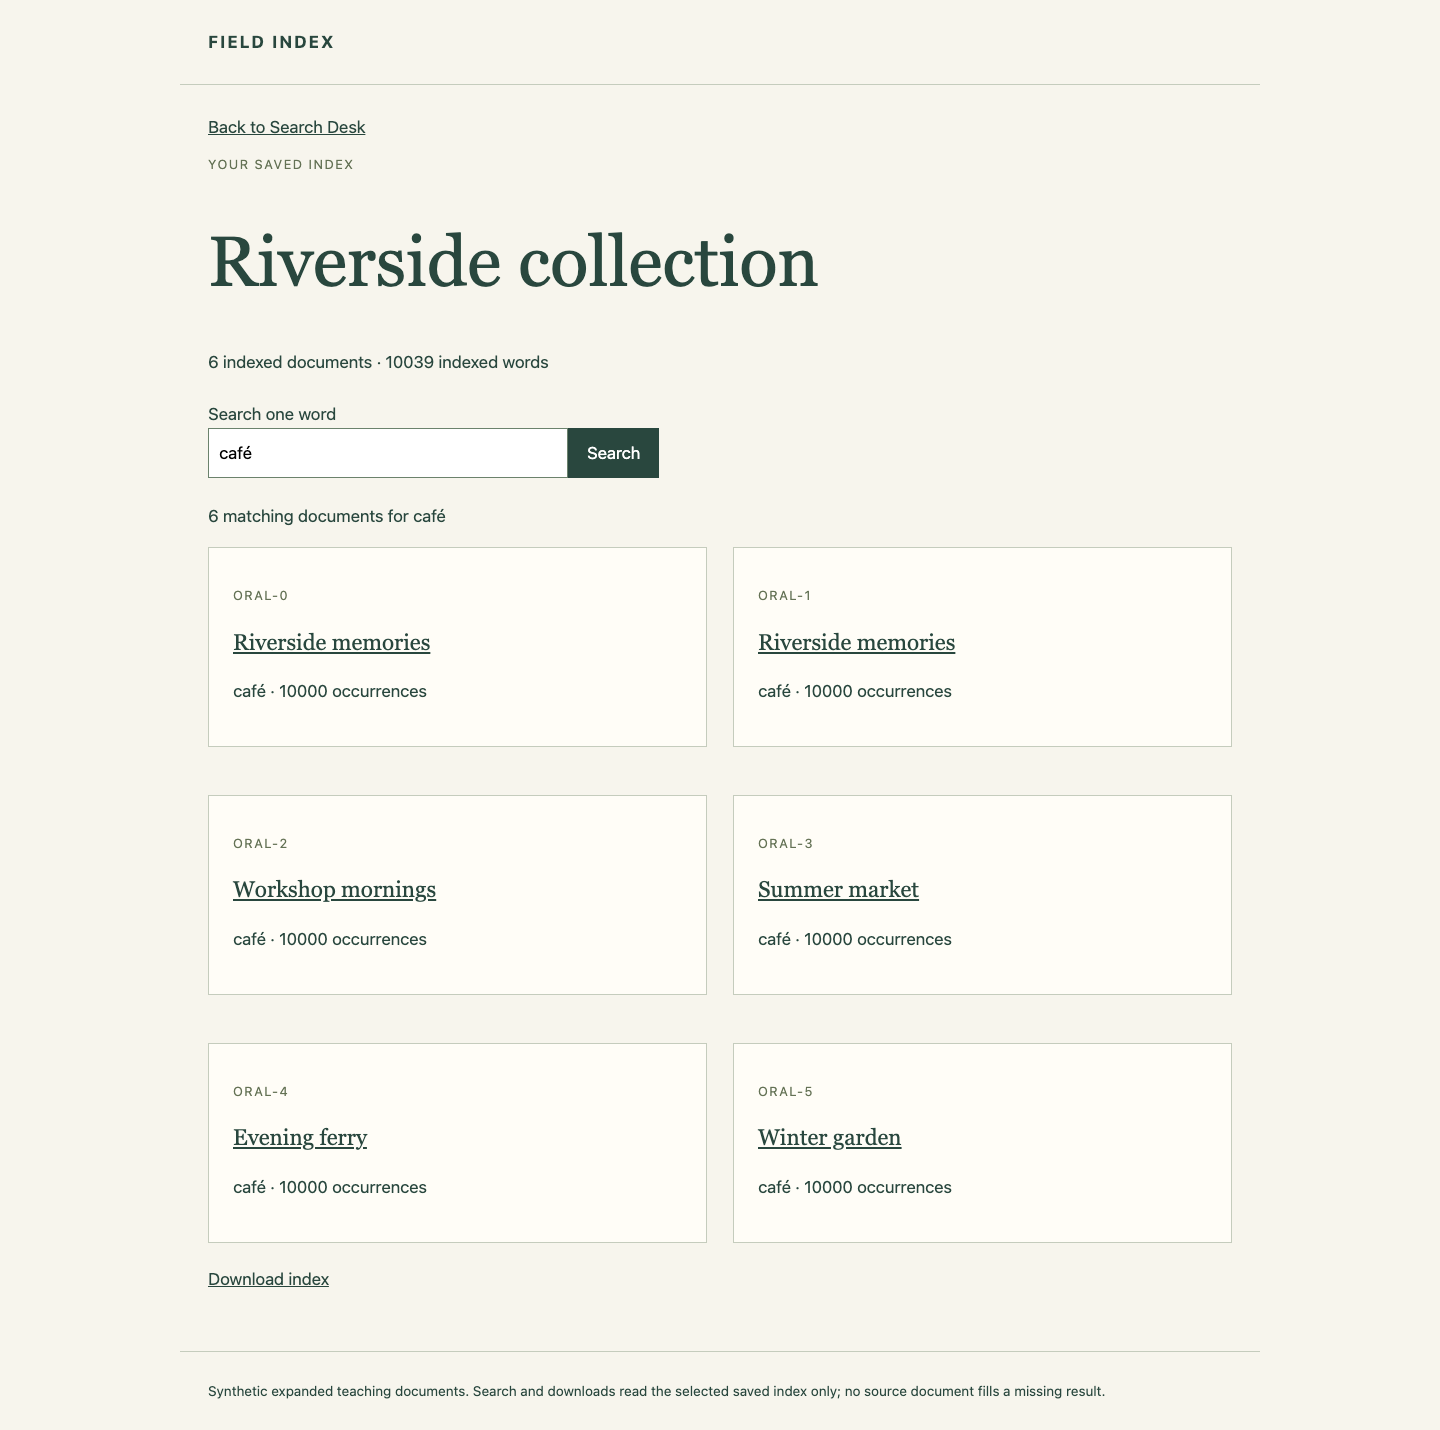
Vuelve con Back to collection, busca résumé y después naïve y confirma que los seis registros siguen pudiendo buscarse con sus recuentos reales. Busca notawordinthiscollection: no debe coincidir ningún documento. Usa Download index e inspecciona el JSON real entregado; sus documentos, hashes fuente y listas de apariciones corresponden a todas las entradas originales. El lector no regenera resultados que falten.
Las comprobaciones relacionan el evento exacto de memory-cgroup de esta ejecución con su contenedor, inspeccionan el presupuesto efectivo y los montajes de la entrega correcta y leen independientemente todos los bytes HTML originales en flujo para verificar todos los recuentos Unicode de palabras por documento. No repiten tu trabajo real ni escriben el índice por ti.
Recupera solo una entrega fallida
Si tu intento de entrega también agota la memoria, inspecciona su estado detenido y registros, elige un lote viable y elimina solo ese contenedor index-delivery fallido con docker rm index-delivery antes de reintentar el comando de entrega mostrado. Conserva index-attempt y todos los HTML originales como evidencia. Una repetición correcta sobrescribe su propia salida con un índice completo; no edites recuentos a mano ni copies la muestra pequeña en la entrega.
Resumen
Vinculaste una acción OOM real de memory-cgroup con su contenedor exacto y sus límites efectivos y después redujiste la concurrencia real de lotes HTML para terminar todo el índice con el mismo presupuesto de 160 MiB. El índice guardado conserva las seis identidades, los títulos duplicados, los hashes fuente originales y los recuentos de palabras Unicode y sigue siendo utilizable después de terminar su contenedor.