



Introducción
El monitor de estado de un equipo de soporte necesita dos formas de ejecutar la misma comprobación breve: después de que un usuario la solicite y periódicamente, sin una solicitud de usuario. Implementará ambas formas, distinguirá entre el acuse de recibo y la finalización, probará localmente la duración de los eventos y observará una invocación programada real en la nube.
Esta VM independiente se inicia en /home/labex/project/task-monitor con Node.js 22.22.0, Wrangler 4.131.1 local del proyecto, Miniflare 4.20260730.0 para la evaluación aislada y un accesorio sintético de servicio interno de estado. Reutilizará las habilidades anteriores de enlaces de servicio y autorización de dispositivos, pero no una VM ni un recurso de un laboratorio anterior. Utilice su propia cuenta de aprendizaje; no se necesita ningún dominio, producto de almacenamiento ni mejora de pago. Las solicitudes y las invocaciones programadas cuentan para el uso normal de la cuenta.
Mantenga un terminal abierto. La programación breve de un minuto está destinada a pruebas desechables. Termine deteniendo los flujos de registros, eliminando ambos Workers mientras mantiene la autorización, confirmando su ausencia y cerrando la sesión. El trabajo en segundo plano de este laboratorio tiene una duración limitada y no es persistente; no lo utilice como promesa de entrega fiable en cola.
Responder antes de que finalice el trabajo en segundo plano
En este paso, un endpoint público confirmará la recepción de una pequeña solicitud de comprobación de estado mientras un servicio interno proporcionado realiza el trabajo asíncrono. Esta es una VM independiente; el servicio es un accesorio nuevo, no un recurso de un laboratorio anterior.
cd /home/labex/project/task-monitor
node --version
npx wrangler --version
cat health/index.js
El accesorio espera 250 milisegundos y devuelve JSON sintético. No realiza solicitudes externas ni almacena datos. Genere un nombre base único y configure el Worker público y su servicio interno HEALTH. Estos son los enlaces de servicio estándar que utilizó anteriormente.
WORKER_NAME="labex-tasks-$(openssl rand -hex 6)"
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": []
  }
}
CONFIG
cat > health/wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME-health",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false
}
CONFIG
cat > src/index.js <<'JS'
async function checkHealth(env, details) {
  const url = new URL('https://health.internal/health');
  url.searchParams.set('probe', details.probe);
  const response = await env.HEALTH.fetch(url, {signal: AbortSignal.timeout(3000)});
  if (!response.ok) throw new Error('health_service_unavailable');
  const data = await response.json();
  if (data.status !== 'ok' || data.service !== 'labex-health-fixture' || data.probe !== details.probe) {
    throw new Error('unexpected_health_response');
  }
  console.log(JSON.stringify({event: 'health_check', ...details, status: data.status, service: data.service}));
}

export default {
  async fetch(request, env, ctx) {
    const url = new URL(request.url);
    if (url.pathname === '/health' && request.method === 'GET') {
      return Response.json({status: 'ok'}, {headers: {'Cache-Control': 'no-store'}});
    }
    if (url.pathname !== '/checks') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'POST') {
      return Response.json({error: 'method_not_allowed'}, {status: 405, headers: {Allow: 'POST'}});
    }
    const probe = url.searchParams.get('probe') || '';
    if (!/^[a-z0-9-]{1,48}$/.test(probe)) {
      return Response.json({error: 'invalid_probe'}, {status: 400});
    }
    ctx.waitUntil(checkHealth(env, {source: 'request', probe}).catch(() => {
      console.error(JSON.stringify({event: 'health_check_failed', source: 'request', probe}));
    }));
    return Response.json({accepted: true, probe}, {status: 202, headers: {'Cache-Control': 'no-store'}});
  }
};
JS
checkHealth valida la respuesta real de la dependencia y emite un resultado estructurado breve. Su señal de cancelación de tres segundos limita la duración de la solicitud. El controlador público pasa su promesa a ctx.waitUntil y devuelve HTTP 202 inmediatamente. El código 202 confirma este intento de corta duración; no promete una entrega persistente. El bloque catch registra un error sin imprimir excepciones, solicitudes ni credenciales sin procesar. Utilice únicamente los valores de prueba sintéticos que se muestran aquí.
npx wrangler dev -c wrangler.jsonc -c health/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
Espere al prompt y, después, inspeccione el registro. Continúe cuando el servidor de desarrollo público esté listo en el puerto 8080. Si todavía se está iniciando, espere brevemente y vuelva a leer el registro.
cat dev.log
curl -i http://127.0.0.1:8080/health
curl -i -X POST "http://127.0.0.1:8080/checks?probe=manual-one"
cat dev.log
La ruta de estado en primer plano devuelve 200 y el estado ok. La solicitud POST devuelve 202 con accepted igual a true y probe igual a manual-one. Cuando finaliza la dependencia, el registro incluye el evento health_check, source igual a request, la misma prueba y el estado ok. Si lee el registro demasiado pronto, vuelva a leerlo después de un momento. Que la respuesta llegue antes que un registro posterior es una observación, no una medición precisa de rendimiento.
Utilice la verificación mientras el servidor esté en ejecución. Un entorno de ejecución aislado mantiene su propio accesorio de estado detrás de una puerta controlada, exige que la respuesta en primer plano llegue antes de abrir esa puerta y, después, exige que finalice el trabajo en segundo plano. También comprueba la ruta pública de estado y los casos de método o prueba rechazados. Ninguna parte de esa prueba llama a Cloudflare.
Invocar localmente el controlador programado
En este paso, reutilice la operación de comprobación de estado desde un controlador activado por Cron. Inspeccione y detenga el trabajo de desarrollo real antes de cambiar el código. Sustituya el número de trabajo actual si difiere del ejemplo.
jobs
kill %1
cat > src/index.js <<'JS'
async function checkHealth(env, details) {
  const url = new URL('https://health.internal/health');
  url.searchParams.set('probe', details.probe);
  const response = await env.HEALTH.fetch(url, {signal: AbortSignal.timeout(3000)});
  if (!response.ok) throw new Error('health_service_unavailable');
  const data = await response.json();
  if (data.status !== 'ok' || data.service !== 'labex-health-fixture' || data.probe !== details.probe) {
    throw new Error('unexpected_health_response');
  }
  console.log(JSON.stringify({event: 'health_check', ...details, status: data.status, service: data.service}));
}

export default {
  async fetch(request, env, ctx) {
    const url = new URL(request.url);
    if (url.pathname === '/health' && request.method === 'GET') {
      return Response.json({status: 'ok'}, {headers: {'Cache-Control': 'no-store'}});
    }
    if (url.pathname !== '/checks') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'POST') {
      return Response.json({error: 'method_not_allowed'}, {status: 405, headers: {Allow: 'POST'}});
    }
    const probe = url.searchParams.get('probe') || '';
    if (!/^[a-z0-9-]{1,48}$/.test(probe)) {
      return Response.json({error: 'invalid_probe'}, {status: 400});
    }
    ctx.waitUntil(checkHealth(env, {source: 'request', probe}).catch(() => {
      console.error(JSON.stringify({event: 'health_check_failed', source: 'request', probe}));
    }));
    return Response.json({accepted: true, probe}, {status: 202, headers: {'Cache-Control': 'no-store'}});
  },
  async scheduled(controller, env) {
    await checkHealth(env, {
      source: 'scheduled',
      probe: `cron-${controller.scheduledTime}`,
      cron: controller.cron,
      scheduledTime: controller.scheduledTime
    });
  }
};
JS
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": [
      "* * * * *"
    ]
  }
}
CONFIG
La expresión de cinco campos * * * * * significa cada minuto, en UTC. Esta programación deliberadamente frecuente solo sirve para un experimento breve y desechable. scheduled espera a que termine la operación de estado para que el resultado de la invocación refleje la finalización; no devuelve una respuesta HTTP. El registro anota la expresión Cron real del disparador y la hora programada.
npx wrangler dev -c wrangler.jsonc -c health/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
Espere al prompt y, después, inspeccione el registro. Continúe cuando el servidor de desarrollo público esté listo en el puerto 8080. Si todavía se está iniciando, espere brevemente y vuelva a leer el registro.
cat dev.log
curl -i "http://127.0.0.1:8080/cdn-cgi/local/scheduled?cron=*+*+*+*+*&time=1700000000000&format=json"
cat dev.log
El disparador local debería devolver outcome igual a ok, y el registro de la aplicación debería contener source igual a scheduled, cron igual a * * * * * y scheduledTime igual a 1700000000000. Esta marca de tiempo antigua es una entrada de prueba sintética deliberada, no una prueba de una ejecución actual en la nube. Utilice la verificación para probar otra hora programada controlada y confirmar que se llamó al servicio de estado.
Para las invocaciones HTTP, waitUntil puede prolongar el trabajo hasta 30 segundos después de enviar la respuesta o de que el cliente se desconecte; ese margen se comparte entre las promesas en segundo plano de la solicitud. No es una cola persistente ni una garantía de reintento. La operación breve, limitada a tres segundos, de este laboratorio encaja en ese propósito. El trabajo que necesite una entrega o reintentos fiables debe utilizar un diseño adecuado de cola o flujo de trabajo fuera de este laboratorio. Consulte la documentación de Context API y del scheduled handler para conocer las distintas duraciones de las invocaciones.
Implementar y observar el trabajo en segundo plano de una solicitud
En este paso, implemente ambos Workers nuevos en su propia cuenta de aprendizaje. Detenga el trabajo local real y autorice esta VM nueva mediante el flujo de dispositivo conocido.
jobs
kill %1
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_tail:read
Abra en su navegador con la sesión iniciada el enlace de dispositivo que se muestra, introduzca su código, revise el acceso solicitado y seleccione la cuenta de aprendizaje. Espere a que el terminal confirme el éxito.
npx wrangler whoami --json
Confirme el nombre de la cuenta aunque solo aparezca una. Sustituya YOUR_ACCOUNT_ID en ambas configuraciones siguientes por su ID real. Mantenga los mismos nombres de Worker generados y la programación de un minuto. El Worker público también activa Workers Logs, por lo que sus registros de invocación y de aplicación estarán disponibles en Observability en Dashboard. Esto es independiente de la conexión activa de wrangler tail. Este laboratorio desechable solo emite datos sintéticos de comprobación de estado; no registre nunca credenciales. Consulte la documentación de Workers Logs.
cat > wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [
    {
      "binding": "HEALTH",
      "service": "$WORKER_NAME-health"
    }
  ],
  "triggers": {
    "crons": [
      "* * * * *"
    ]
  },
  "observability": {
    "enabled": true
  },
  "account_id": "YOUR_ACCOUNT_ID"
}
CONFIG
cat > health/wrangler.jsonc <<CONFIG
{
  "name": "$WORKER_NAME-health",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false,
  "account_id": "YOUR_ACCOUNT_ID"
}
CONFIG
npx wrangler deploy -c health/wrangler.jsonc
npx wrangler deploy
El servicio interno de estado se implementa primero para que el enlace del Worker público pueda resolverlo. Confirme que la salida de la implementación pública incluye la programación: * * * * *. Copie debajo su dirección real de workers.dev.
APP_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
curl -i "$APP_URL/health"
npx wrangler tail --format pretty > events.log 2> tail-errors.log &
Espere unos segundos para que se inicialice la conexión de seguimiento y, después, envíe una comprobación sintética.
sleep 5
curl -i -X POST "$APP_URL/checks?probe=remote-one"
cat events.log
Busque el evento POST y su registro health_check con source igual a request y probe igual a remote-one. Si todavía no aparece ningún evento, inspeccione tail-errors.log, espere brevemente, envíe la solicitud de nuevo y vuelva a leer events.log. Un archivo de registro de un laboratorio anterior no demuestra nada sobre esta implementación.
En Dashboard, abra Compute → Workers & Pages de esta cuenta. Confirme los dos nombres exactos, la dirección del Worker público y su enlace HEALTH al servicio interno correspondiente. Utilice la verificación: comprueba la propiedad autenticada y los metadatos del endpoint y del enlace; después, abre su propia sesión breve de seguimiento en vivo y envía una prueba nueva para confirmar la finalización del trabajo en segundo plano. El evaluador no considera events.log como prueba suficiente. Mantenga el trabajo de seguimiento del alumno en ejecución para el siguiente paso.
Observar una ejecución real de Cron
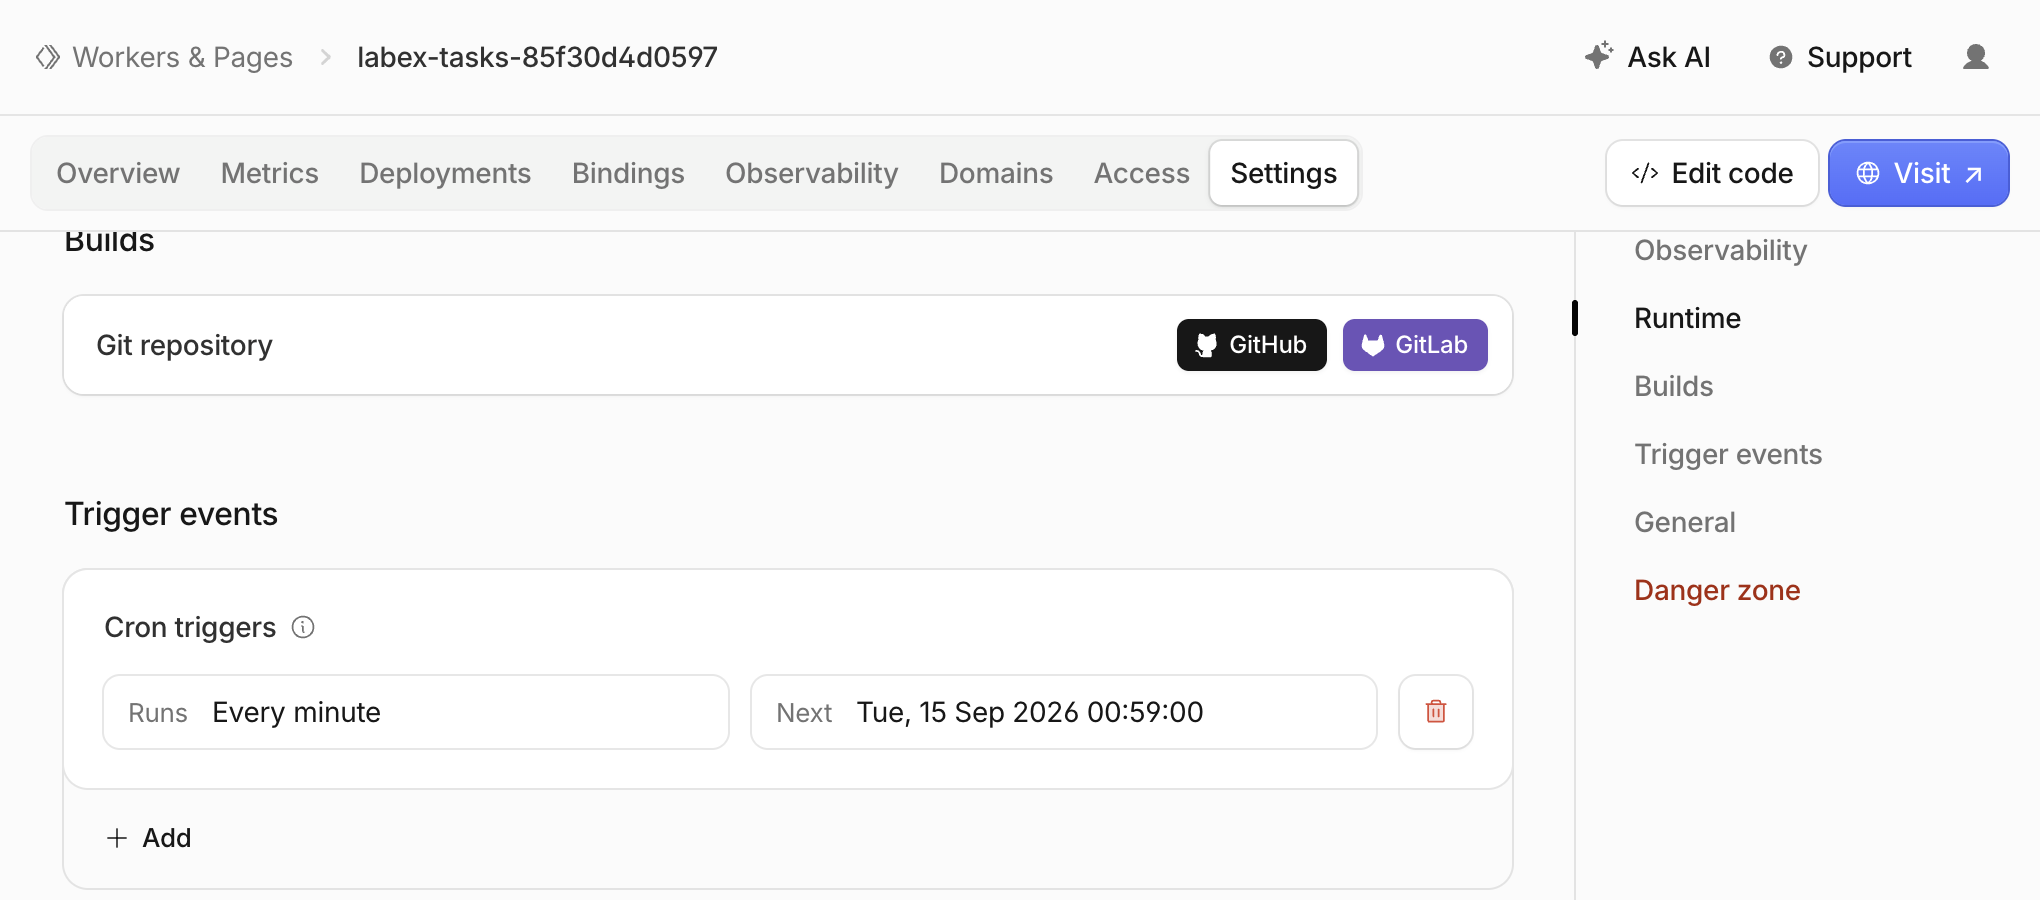
En este paso, distinga la configuración de implementación de la ejecución. Abra el Worker público en Dashboard e inspeccione Settings → Trigger events → Cron triggers. Confirme que la programación aparece como Every minute. Next time es una predicción, no una ejecución completada. Una programación configurada por sí sola no demuestra que se haya ejecutado su controlador.
El ejemplo siguiente muestra el intervalo mínimo admitido: * * * * *, es decir, una vez por minuto. Compare el nombre del Worker con su propia configuración. El nombre y la hora mostrados son ejemplos; no necesita añadir otro disparador en Dashboard porque Wrangler ya lo configuró.
Mantenga en ejecución la conexión de seguimiento del alumno. Espere a que aparezca un evento programado real e inspeccione el mismo archivo de registro:
sleep 60
cat events.log
Busque una invocación programada correcta en la salida legible de seguimiento, identificada por la expresión Cron y su hora de ejecución. Su registro health_check debe tener source igual a scheduled, cron igual a * * * * *, status igual a ok, service igual a labex-health-fixture y un valor scheduledTime. La prueba es cron- seguido de ese scheduledTime. El verificador independiente comprueba por separado los metadatos estructurados del evento de Cloudflare frente a este registro de aplicación. Un evento POST, una marca de tiempo sintética local o un registro vacío no demuestran este resultado.
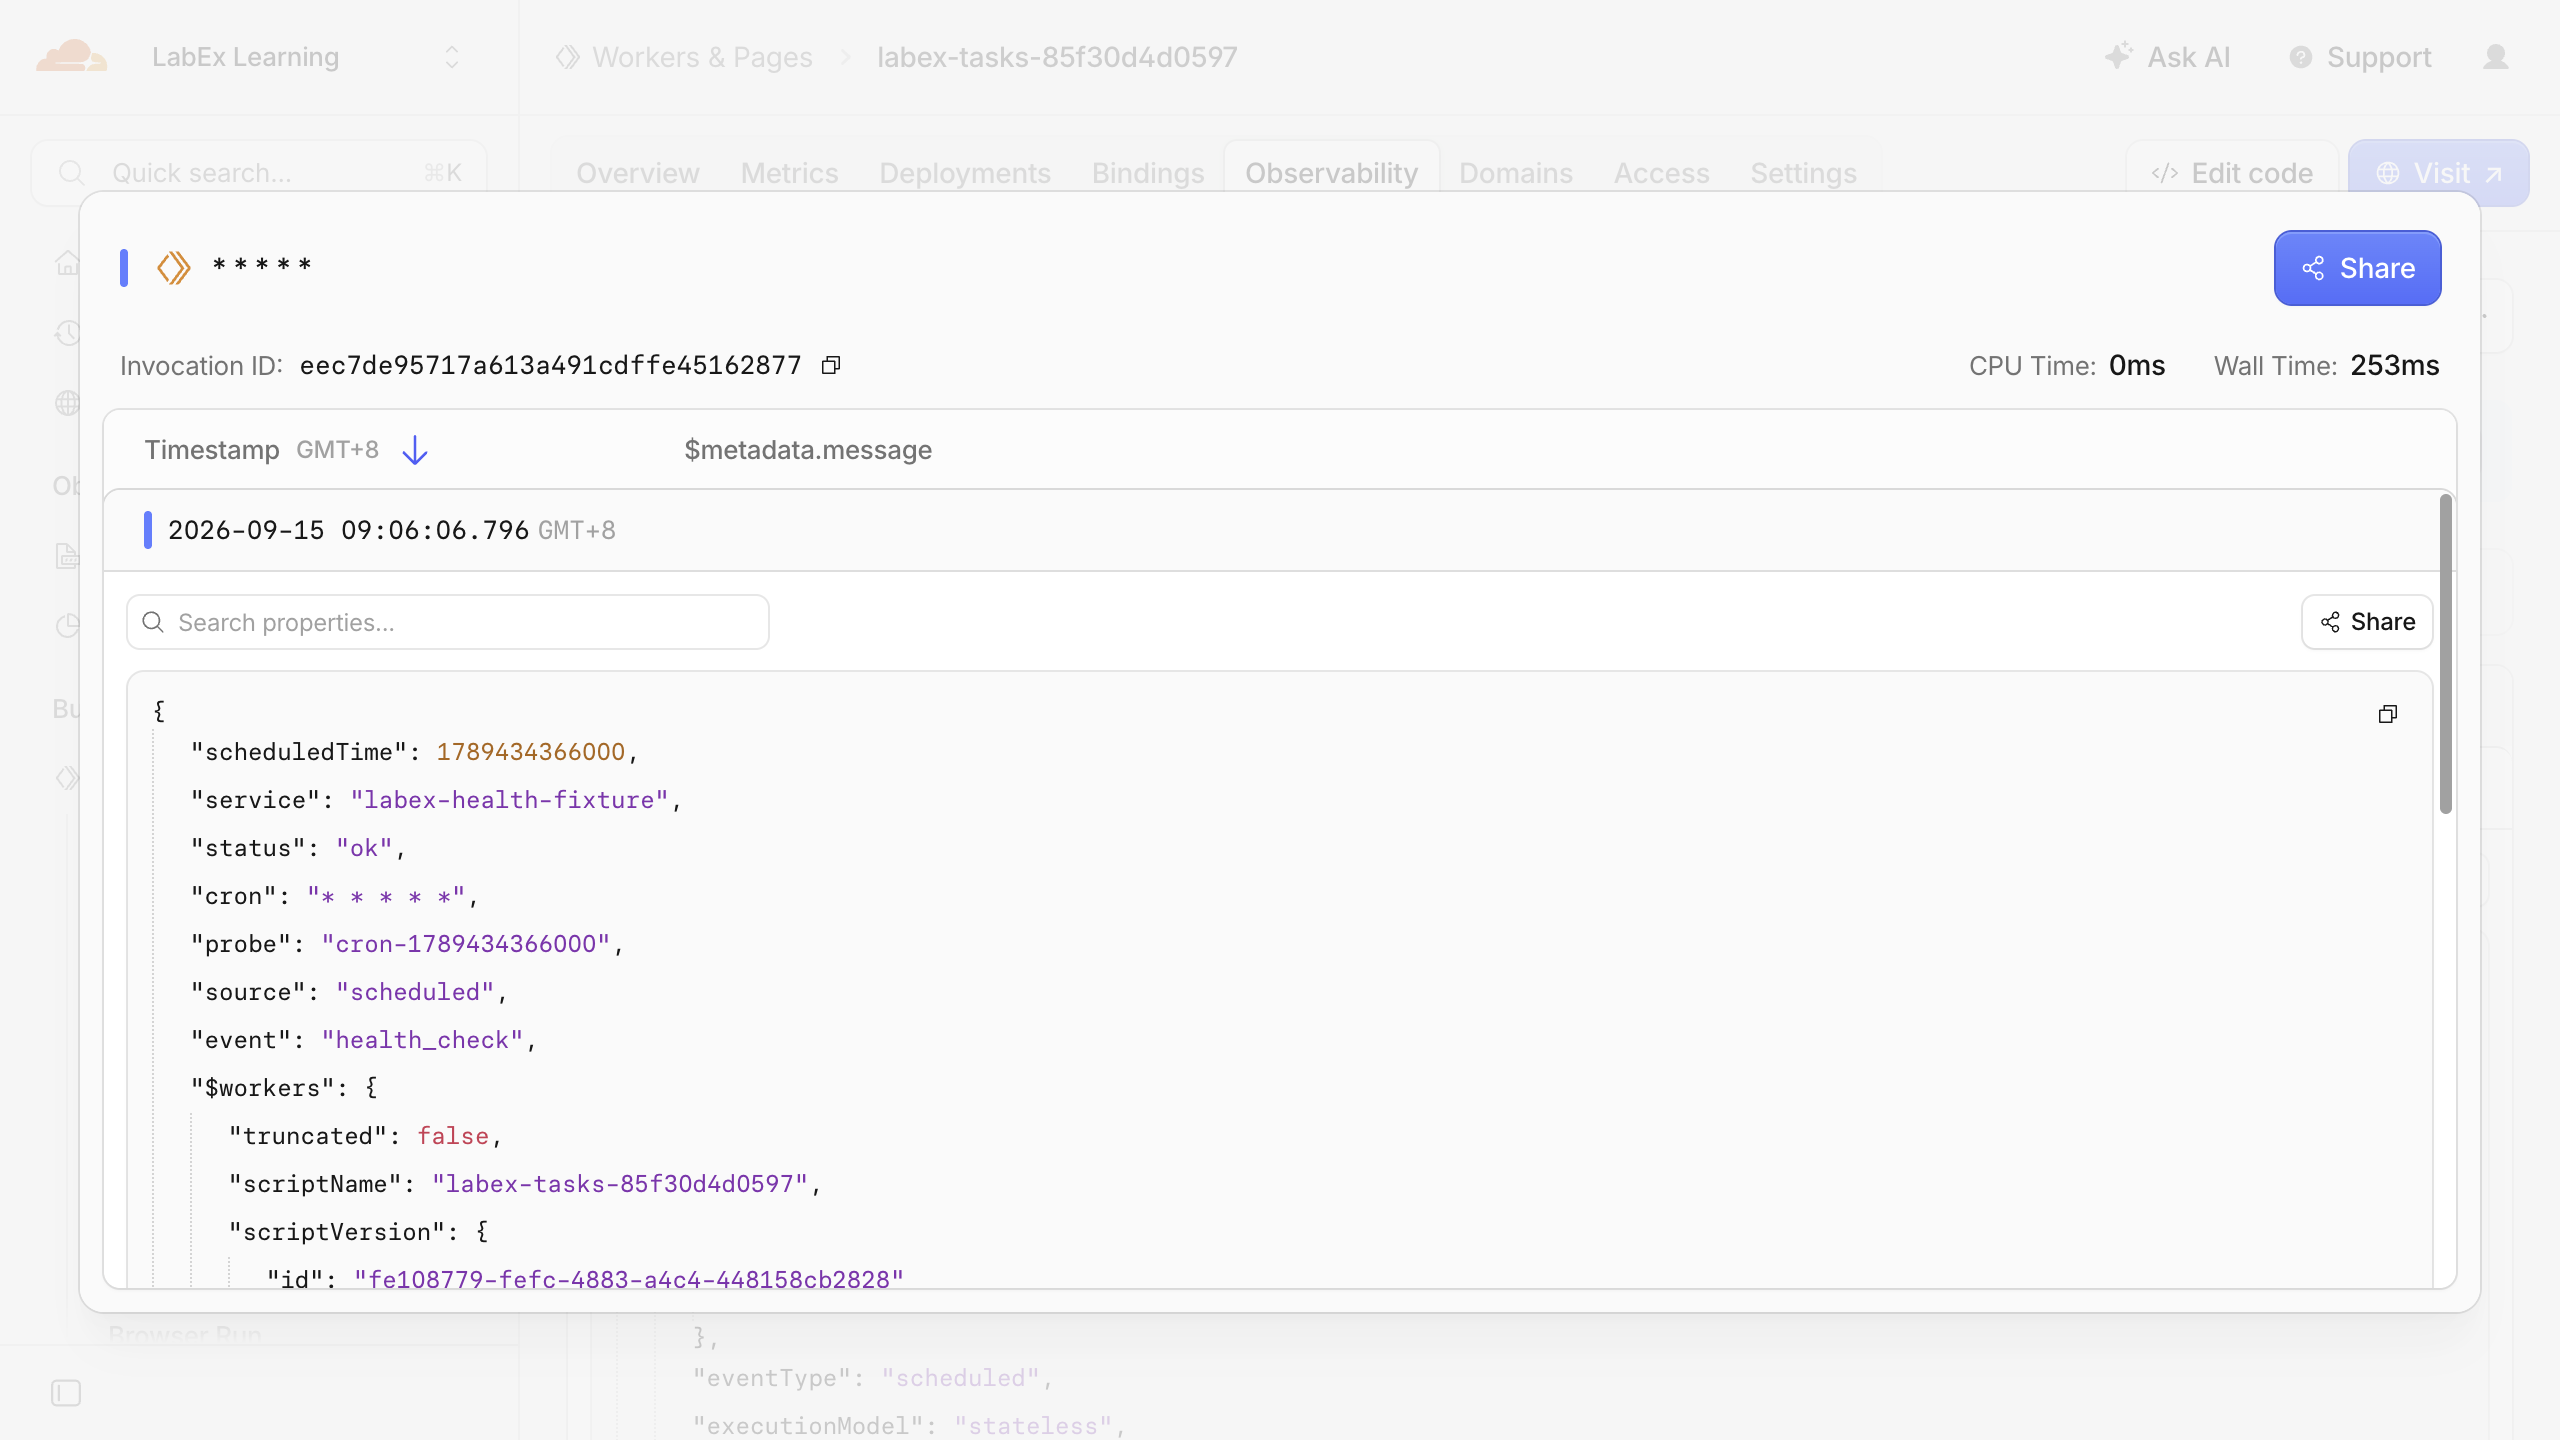
Para relacionar esa salida con el navegador, abra la página Observability → Events del mismo Worker. Utilice Live mientras espera o actualice la consulta de eventos guardada con un intervalo de tiempo que incluya su implementación. Las filas de invocación de este controlador muestran * * * * *. Expanda una, seleccione View invocation y expanda su fila de registro de aplicación asociada para inspeccionar los campos de la comprobación de estado. Un registro de aplicación estructurado puede tener vacía la celda Message; expanda la fila en lugar de interpretarla como datos ausentes. Puede pausar la vista en vivo mientras lee.
En este ejemplo real, source es scheduled, status es ok y service es labex-health-fixture. La prueba cron-... coincide con el scheduledTime del registro de aplicación en milisegundos. Dashboard muestra la marca de tiempo visible en la zona horaria indicada (GMT+8 aquí), mientras que la programación Cron utiliza UTC. Su nombre, ID de invocación y hora serán diferentes. Lea estos campos junto con el resultado de la invocación; la captura de pantalla por sí sola no demuestra la finalización.
Las actualizaciones de Cron pueden tardar hasta 15 minutos en propagarse. Repita el ciclo de espera de un minuto e inspección, permitiendo como máximo 17 minutos desde la implementación correcta. Inspeccione tail-errors.log si el flujo está vacío o se ha detenido. Si no aparece ningún evento coincidente dentro de ese límite, deténgase y diagnostique la configuración, la autorización y el estado del disparador; no informe de éxito. Esta es una observación de aprendizaje con un límite, no una garantía de latencia exacta de ejecución. La documentación de Cron Triggers explica la propagación y la programación UTC. Los Workers Logs guardados también pueden tardar un poco en aparecer; actualice la consulta después de dejar tiempo para la ingesta. El historial independiente Past Cron Events de un Worker nuevo puede tardar hasta 30 minutos en mostrar eventos. Un historial vacío no demuestra un error; utilice la observación en tiempo real anterior dentro del límite de este laboratorio.
Utilice la verificación después de observar una ejecución. Comprueba la programación implementada y observa un flujo en vivo independiente durante un máximo de 70 segundos para encontrar un evento programado real con el resultado de estado. Esto cubre un límite completo de un minuto después del inicio de la conexión. Un resultado sin eventos es inconcluyente, por lo que debe inspeccionar el estado de la conexión y de la propagación, y volver a intentarlo dentro del mismo límite de observación. El evaluador no fabrica ningún evento programado. Detenga el seguimiento del alumno solo después de que la verificación tenga éxito; utilice el número de trabajo real.
jobs
kill %1
Termine cuanto antes la programación desechable completando el siguiente paso. No deje un trabajo de aprendizaje que se ejecute cada minuto sin supervisión.
Eliminar ambos Workers de prueba programada
En este paso, elimine el Worker público y su disparador y, después, el accesorio interno de estado, mientras mantiene la autorización. Confirme que ambas configuraciones contienen los nombres exactos de este laboratorio y la cuenta prevista.
cat wrangler.jsonc
cat health/wrangler.jsonc
npx wrangler delete
npx wrangler delete -c health/wrangler.jsonc
En cada solicitud de confirmación para un nombre coincidente, pulse la única tecla y. Conserve los proyectos no relacionados, la cuenta y su subdominio. El Wrangler fijado puede mostrar el diagnóstico conocido de autenticación de limpieza de KV heredado después de eliminar un Worker; ni ese mensaje ni una solicitud de red fallida demuestran que la eliminación se haya realizado. No amplíe los permisos para resolver ese diagnóstico.
Actualice Dashboard y utilice la verificación. Un inventario autenticado correcto de Workers debe mostrar que ambos nombres están ausentes. Esto confirma la eliminación de los recursos implementados, no la propagación global instantánea de todos los cambios del programador. Cerrar la sesión o la VM por sí solo no realizaría esta limpieza.
Desconectar la VM del laboratorio
En este paso, confirme que el trabajo de seguimiento se ha detenido y que los recursos han desaparecido antes de desconectar esta VM.
jobs
npx wrangler logout
npx wrangler whoami --json
Exija explícitamente loggedIn: false. El comando estructurado sin autenticación puede terminar con un código distinto de cero; un error de red no equivale al mismo resultado. Utilice la verificación y finalice la VM. La sesión iniciada en su navegador puede permanecer disponible para otros laboratorios independientes.
Resumen
Utilizó waitUntil para permitir que una comprobación de estado con duración limitada terminara después de un acuse de recibo en primer plano y, después, reutilizó esa operación desde un controlador programado. Las pruebas locales controladas separaron la respuesta del trabajo retrasado, mientras que un evento real en la nube confirmó la ejecución programada después de la implementación. La configuración, la invocación manual y la ejecución en vivo proporcionaron distintos tipos de evidencia.
Comprobó la propiedad y los enlaces de servicio, relacionó pruebas sintéticas con registros estructurados, respetó los límites de duración de las invocaciones y eliminó la aplicación programada desechable antes de desconectarse. La entrega fiable de larga duración requiere una arquitectura diferente de este patrón de trabajo en segundo plano de corta duración.
