



Introducción
Una API de soporte devuelve una excepción poco útil cuando una dependencia responde lentamente. Reproducirá el síntoma, lo correlacionará con un ID de solicitud y reparará el controlador para que los clientes reciban un fallo acotado y significativo, mientras las solicitudes correctas siguen funcionando. Después verificará respuestas reales en la nube y un flujo independiente de registros en directo.
Comience en esta VM nueva con su propia cuenta de aprendizaje. Los requisitos previos son el despliegue habitual con Wrangler, los enlaces de servicio y las pruebas locales; no se reutiliza ningún Worker ni ninguna VM anteriores. La configuración instala Node.js 22.22.0, Wrangler 4.131.1 y Miniflare 4.20260730.0, y proporciona el cliente defectuoso y un servicio ascendente sintético. El servicio ascendente devuelve datos sintéticos, un 503 controlado o un retraso de 2,5 segundos. No necesita una base de datos, un dominio comprado ni un experimento de carga elevada.
Una excepción del entorno de ejecución, un HTTP 504 deliberado y un fallo por límite de ejecución son observaciones distintas. Inspeccionará cada tipo de evidencia sin tratar toda respuesta 5xx como un fallo de la plataforma.
Reproducir y correlacionar el tiempo de espera
En este paso, reproduzca localmente una excepción causada por una dependencia lenta. Lea el cliente y el servicio ascendente proporcionado. El cliente tiene un límite de 400 ms, pero no captura un fetch rechazado; el modo lento del servicio ascendente espera 2,5 segundos.
cd /home/labex/project/failure-diagnostics
cat src/index.js
cat upstream/index.js
Genere una base única para los recursos. El primer EOF sin comillas sustituye esa variable en ambas configuraciones. El enlace de servicio UPSTREAM mantiene privado el recurso de prueba; un nombre de host en su URL de solicitud no selecciona un servicio público.
WORKER_NAME="labex-diagnose-$(node -p "require('node:crypto').randomBytes(6).toString('hex')")"
cat > wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME",
  "main": "src/index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": true,
  "preview_urls": false,
  "services": [{"binding": "UPSTREAM", "service": "$WORKER_NAME-upstream"}]
}
EOF
cat > upstream/wrangler.jsonc <<EOF
{
  "name": "$WORKER_NAME-upstream",
  "main": "index.js",
  "compatibility_date": "2026-07-30",
  "workers_dev": false,
  "preview_urls": false
}
EOF
Ejecute ambas configuraciones en un único proceso de desarrollo local. El trabajo en segundo plano mantiene disponible el terminal; > y 2>&1 envían la salida y los errores a dev.log. Espere a que aparezca Ready antes de enviar solicitudes.
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Use -H para incluir un ID de solicitud sintético corto. El controlador solo acepta un formato de ID restringido; en cualquier otro caso, genera uno. --max-time limita el tiempo de espera del cliente curl; es independiente del límite del controlador.
curl -i --max-time 6 -H "X-Request-ID: healthy-one" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-one" "http://127.0.0.1:8080/api/check?mode=slow"
cat dev.log
La solicitud correcta devuelve 200 con datos sintéticos del servicio ascendente. El modo lento debería devolver un error local 500 y mostrar el registro request_started para slow-one, seguido de una excepción de tiempo de espera no capturada. La página de error local exacta y la traza pueden variar. Esto demuestra que el límite rechaza la operación; no demuestra que exista una respuesta de error útil. Ejecute la verificación antes de modificar el cliente.
Reparar la respuesta de error y los diagnósticos
En este paso, capture el fallo acotado del servicio ascendente y conserve diagnósticos útiles sin registrar encabezados ni credenciales. Detenga el trabajo actual usando su número real.
jobs
kill %1
Sustituya el cliente por el controlador reparado completo que aparece a continuación. El delimitador entre comillas conserva literalmente el código JavaScript. Un 504 identifica el límite de tiempo de la dependencia del cliente; un 502 identifica una respuesta fallida del servicio ascendente o un problema de protocolo. Las llamadas correctas conservan el resultado del servicio ascendente. elapsed_ms es el tiempo transcurrido del reloj, no el uso de CPU. El registro y la respuesta comparten un ID de solicitud para que pueda seguir una solicitud por todo el sistema.
cat > src/index.js <<'JS'
export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === '/health') return Response.json({status: 'ok'});
    if (url.pathname !== '/api/check') return Response.json({error: 'not_found'}, {status: 404});
    if (request.method !== 'GET') return Response.json({error: 'method_not_allowed'}, {status: 405});
    const mode = url.searchParams.get('mode') || 'healthy';
    if (!['healthy', 'slow', 'fail'].includes(mode)) {
      return Response.json({error: 'invalid_mode'}, {status: 400});
    }
    const suppliedId = request.headers.get('X-Request-ID') || '';
    const requestId = /^[a-z0-9-]{1,64}$/.test(suppliedId) ? suppliedId : crypto.randomUUID();
    const headers = {'X-Request-ID': requestId, 'Cache-Control': 'no-store'};
    const started = Date.now();
    console.log(JSON.stringify({event: 'request_started', request_id: requestId, mode}));
    const upstreamUrl = new URL('https://diagnostic.internal/check');
    upstreamUrl.searchParams.set('mode', mode);
    upstreamUrl.searchParams.set('probe', requestId);
    const signal = AbortSignal.timeout(400);
    const failure = (event, status, detail = {}) => {
      console.error(JSON.stringify({event, request_id: requestId, mode, status,
        elapsed_ms: Date.now() - started, ...detail}));
      return Response.json({error: event, requestId}, {status, headers});
    };
    try {
      const response = await env.UPSTREAM.fetch(upstreamUrl, {signal});
      if (!response.ok) return failure('upstream_status', 502, {upstream_status: response.status});
      const data = await response.json();
      if (data.service !== 'labex-diagnostic-fixture' || data.status !== 'ok' || data.probe !== requestId) {
        return failure('upstream_protocol', 502);
      }
      console.log(JSON.stringify({event: 'request_complete', request_id: requestId,
        mode, status: 200, elapsed_ms: Date.now() - started}));
      return Response.json({status: 'ok', requestId, upstream: data}, {headers});
    } catch {
      return signal.aborted ? failure('upstream_timeout', 504) : failure('upstream_exception', 502);
    }
  }
};
JS
npx wrangler dev -c wrangler.jsonc -c upstream/wrangler.jsonc --ip 0.0.0.0 --port 8080 > dev.log 2>&1 &
cat dev.log
Cuando aparezca Ready, compare los tres modos y la ruta de estado, que no se ha modificado. Cada fallo debe terminar rápidamente; esperar más tiempo para el modo lento no constituye una reparación.
curl -i --max-time 6 -H "X-Request-ID: healthy-two" "http://127.0.0.1:8080/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: slow-two" "http://127.0.0.1:8080/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: fail-two" "http://127.0.0.1:8080/api/check?mode=fail"
curl -i http://127.0.0.1:8080/health
cat dev.log
Espere 200/504/502 para healthy/slow/fail. Cada respuesta incluye su ID de solicitud en el JSON y en X-Request-ID. Los registros emparejan request_started con request_complete, upstream_timeout o upstream_status. La última categoría registra por separado el 503 del servicio ascendente y el 502 del cliente. Un fallo capturado puede tener un resultado correcto del entorno de ejecución porque el controlador terminó normalmente, aunque su estado HTTP sea 504 o 502.
Compare este resultado con el ejemplo proporcionado de límite de ejecución:
cat evidence/execution-limit.json
Este archivo es explícitamente una evidencia sintética para la enseñanza, no una captura de su Worker. Su resultado exceededCpu identifica un fallo por límite de ejecución; no se garantiza que un bloque catch de la aplicación se ejecute después de que el entorno de ejecución detenga la ejecución. Esperar al servicio ascendente asíncrono de este laboratorio no equivale a consumir tiempo de CPU. Investigue los cálculos costosos o el trabajo de las solicitudes antes de considerar los límites; no elimine el límite ni genere carga para imitar este ejemplo. La referencia oficial de errores explica las categorías de excepciones y límites, y la documentación sobre los resultados del entorno de ejecución distingue entre el resultado y el estado HTTP.
Ejecute la verificación. Esta inicia un entorno de ejecución aislado con su propio recurso de prueba e IDs de solicitud, comprueba los contratos de éxito y fallo y confirma que un encabezado Authorization sintético no aparece en los registros capturados de la aplicación. Los archivos de registro del estudiante no constituyen una prueba independiente.
Verificar solicitudes, registros y métricas en directo
En este paso, verifique el comportamiento reparado en su cuenta de aprendizaje. Detenga el desarrollo local y autorice esta VM nueva mediante el mismo flujo de dispositivo con permisos definidos que se enseñó anteriormente.
jobs
kill %1
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_tail:read
Abra el enlace mostrado, introduzca el código y apruebe en el navegador la cuenta de aprendizaje correspondiente. Confirme el nombre y el ID reales de la cuenta en la salida estándar de Wrangler.
npx wrangler whoami --json
Sustituya YOUR_ACCOUNT_ID por ese ID real. Este comando normal de Node lo guarda en ambas configuraciones del proyecto, de modo que cada despliegue especifica claramente su propietario.
node -e 'const fs=require("node:fs");for(const p of ["wrangler.jsonc","upstream/wrangler.jsonc"]){const c=JSON.parse(fs.readFileSync(p));c.account_id="YOUR_ACCOUNT_ID";fs.writeFileSync(p,JSON.stringify(c,null,2)+"\n");}'
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler deploy -c upstream/wrangler.jsonc
npx wrangler deploy
El recurso de prueba no tiene un endpoint público. Copie a continuación la URL workers.dev real del cliente. Si la cuenta necesita registrar inicialmente el subdominio, siga el procedimiento de Deploy Your First Cloudflare Worker antes de continuar.
APP_URL="https://YOUR_WORKER.YOUR_SUBDOMAIN.workers.dev"
Inicie un flujo de registros en directo que sea fácil de leer. Espere hasta que events.log muestre Connected antes de enviar solicitudes; la existencia del archivo por sí sola no indica que el flujo esté listo.
npx wrangler tail --format pretty > events.log 2> tail-errors.log &
cat events.log
curl -i --max-time 6 -H "X-Request-ID: cloud-healthy" "$APP_URL/api/check?mode=healthy"
curl -i --max-time 6 -H "X-Request-ID: cloud-slow" "$APP_URL/api/check?mode=slow"
curl -i --max-time 6 -H "X-Request-ID: cloud-fail" "$APP_URL/api/check?mode=fail"
cat events.log
Busque las respuestas esperadas 200/504/502 y los ID correspondientes en los registros de la aplicación en directo. Si un evento todavía no ha llegado, vuelva a inspeccionar el mismo registro después de unos segundos; no modifique la aplicación para fabricarlo. Si el flujo terminó, deténgase e inspeccione tail-errors.log. La salida legible puede marcar como Ok la invocación capturada que devuelve 504: eso significa que el entorno de ejecución terminó, no que el servicio ascendente estuviera disponible correctamente.
En Dashboard, abra el cliente exacto en la cuenta seleccionada, confirme que su enlace UPSTREAM apunta a este recurso de prueba e inspeccione Metrics. Los gráficos disponibles agregan las solicitudes y los errores de invocación, y pueden tardar en reflejar una prueba breve; registre lo que realmente sea visible en lugar de exigir que el total distinto de cero aparezca de inmediato. Use los registros en directo y las respuestas HTTP como evidencia de solicitudes individuales. Un 504 capturado puede aparecer en los datos del estado de las respuestas HTTP sin contabilizarse como una excepción no capturada del entorno de ejecución. La referencia de métricas explica las categorías de agregación e invocación.
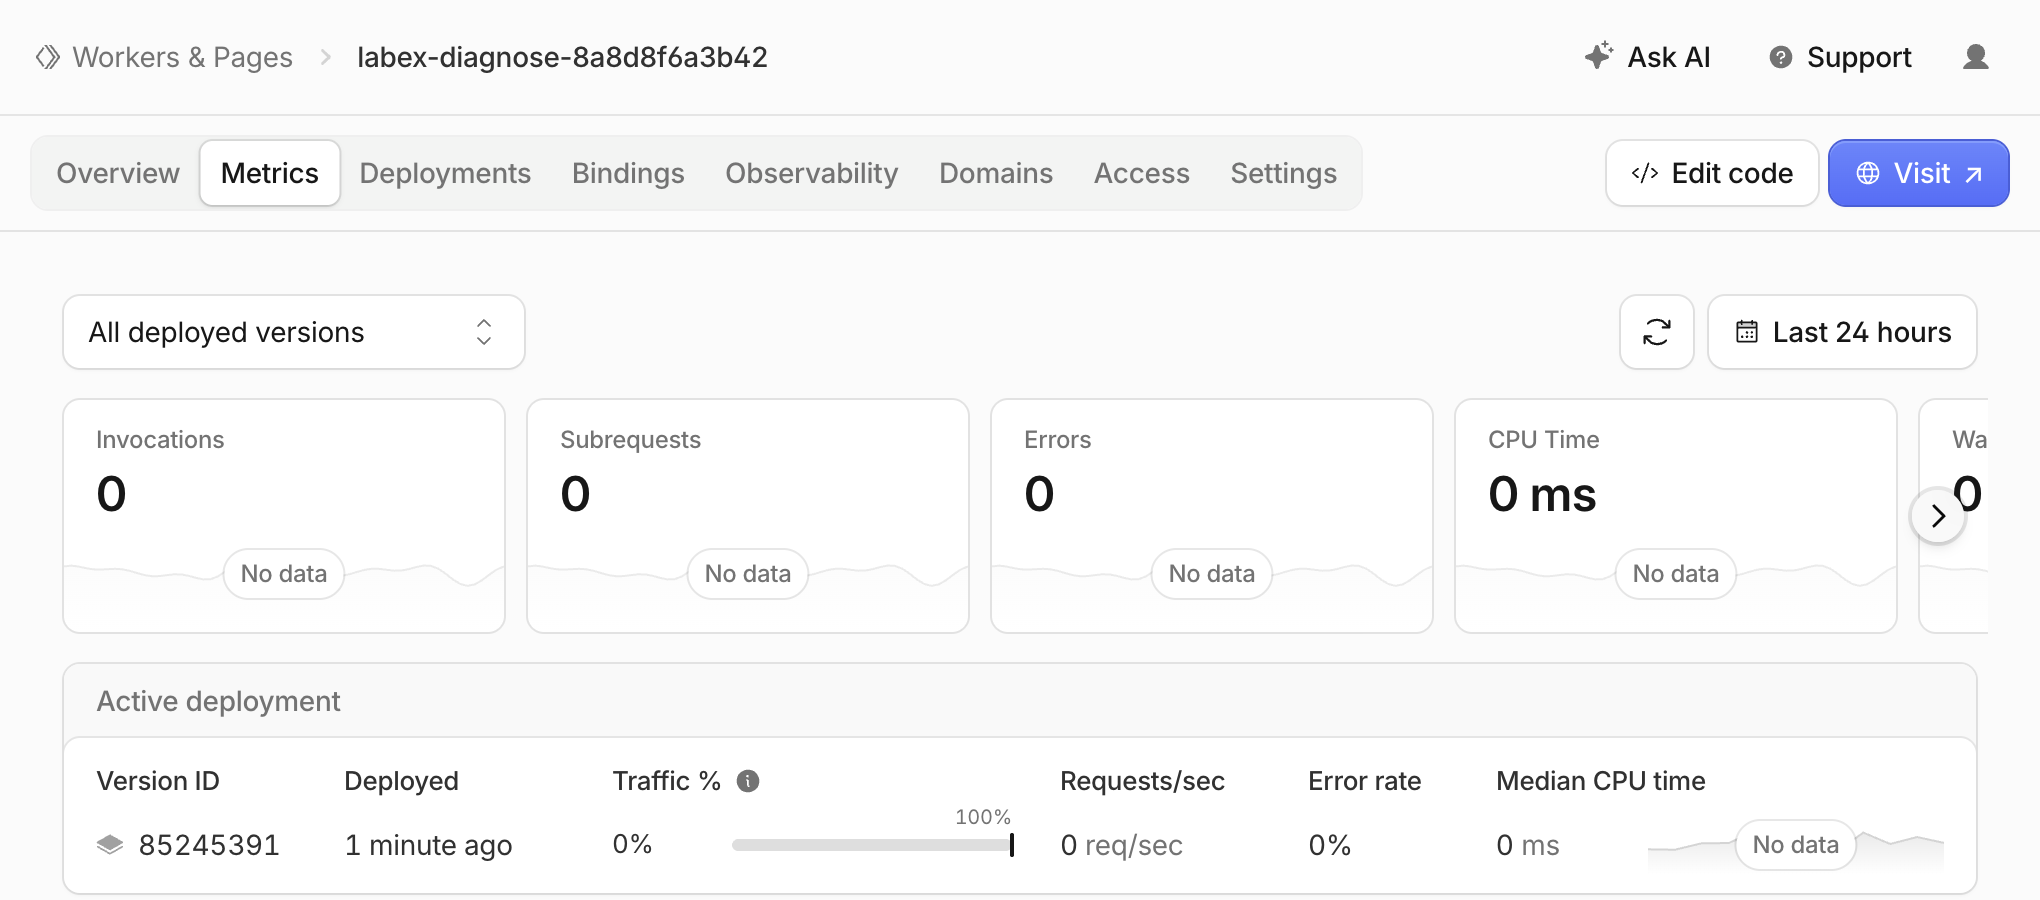
En Compute → Workers & Pages, abra el cliente exacto y seleccione Metrics. Compruebe la ruta de navegación del Worker, el filtro de versión desplegada y un intervalo de tiempo que incluya sus solicitudes. El botón de actualización está junto al selector del intervalo de tiempo. La captura siguiente se tomó poco después de las solicitudes sintéticas correctas, lentas y con fallo del servicio ascendente; las tarjetas todavía mostraban No data. Esta es una observación válida de análisis retrasados, no una prueba de que no se ejecutaran solicitudes ni de que la reparación fallara. Su nombre, ID de versión y totales serán diferentes. No genere carga adicional solo para reproducir una imagen.
Ejecute la verificación mientras siga autorizado. Esta consulta el estado de propiedad y de los enlaces, envía solicitudes independientes nuevas y captura un flujo en directo separado. Espere aproximadamente un minuto. Un flujo no disponible o incompleto no permite sacar conclusiones; inspeccione que la conexión esté lista y vuelva a intentarlo. Nunca trate la ausencia de registros como un éxito. Cuando la verificación termine correctamente, detenga el tail del estudiante usando su número de trabajo actual.
jobs
kill %1
Eliminar los Workers de diagnóstico
En este paso, elimine únicamente el cliente y el recurso de prueba de este laboratorio mientras siga autorizado. Revise ambos nombres y su cuenta antes de eliminar primero el cliente.
cat wrangler.jsonc upstream/wrangler.jsonc
npx wrangler delete
npx wrangler delete -c upstream/wrangler.jsonc
En cada solicitud de confirmación correspondiente al nombre correcto, pulse la única tecla y. La CLI fijada puede mostrar un diagnóstico de autenticación relacionado con la limpieza de KV heredada después de eliminar un Worker; no amplíe los permisos por ese motivo ni suponga que errores arbitrarios demuestran que la eliminación falló. Actualice Dashboard y ejecute la verificación. Ambos nombres deben estar ausentes en un inventario autenticado correcto. Conserve la cuenta, el subdominio y los recursos no relacionados.
Desconectar la VM
En este paso, desconecte la VM después de verificar la eliminación de los recursos. Cerrar el terminal o cerrar sesión no eliminaría los recursos de la nube.
npx wrangler logout
npx wrangler whoami --json
Espere loggedIn=false; el comando puede terminar con un código distinto de cero debido a ese estado sin autenticar. Ejecute la comprobación final. El inicio de sesión del navegador y la cuenta de aprendizaje pueden reutilizarse en otro laboratorio nuevo.
Resumen
Reprodujo un tiempo de espera no controlado, reparó fallos acotados de dependencias y correlacionó IDs de solicitud entre respuestas y registros estructurados. El comportamiento correcto se mantuvo intacto. Distinguió los fallos HTTP de la aplicación de los resultados del entorno de ejecución y de la evidencia sintética de límites de CPU, verificó el comportamiento real en la nube y después eliminó ambos Workers y desconectó la sesión.
