Introducción
Una aplicación de IA necesita dos tipos diferentes de protección del tráfico. Un límite de solicitudes cuenta las solicitudes dentro de una ventana de tiempo y detiene un aumento repentino antes de que llegue al modelo. Un límite de gasto realiza un seguimiento del costo estimado del modelo durante una ventana más larga y protege un presupuesto. Uno controla con qué frecuencia los usuarios pueden enviar trabajo; el otro controla cuánto puede costar ese trabajo.
Creará una puerta de enlace de AI Gateway autenticada y desechable. Permitirá solo dos solicitudes dentro de una ventana deslizante breve, de modo que tres solicitudes pequeñas puedan demostrar una respuesta 429 Too Many Requests sin generar tráfico innecesario hacia el modelo. Cuando la ventana se despeje, comprobará que la inferencia normal se recupera. También agregará una regla de gasto diario de cinco dólares, limitada a Workers AI y al modelo seleccionado. Consultará la regla almacenada en lugar de gastar dinero para agotarla.
Si accedió directamente a este curso, complete primero Conectar LabEx a su cuenta de Cloudflare. Allí se presentan el terminal de LabEx, la autorización de dispositivo de Wrangler y el ID de cuenta. Complete también primero Enrutar la inferencia mediante una puerta de enlace, porque este laboratorio reutiliza sus límites independientes de puerta de enlace y autorización ascendente.
El laboratorio utiliza el modelo alojado por Cloudflare @cf/meta/llama-3.3-70b-instruct-fp8-fast con la facturación Standard de Workers AI. No se requieren Workers Paid, Unified Billing ni credenciales de proveedores externos. Solo tres solicitudes pequeñas deberían llegar al modelo. Si la asignación diaria compartida de Workers AI no está disponible, deténgase en lugar de repetir los intentos.
La configuración instala Node.js 22.22.0 y Wrangler 4.132.0, instalado localmente en el proyecto, en /home/labex/project/ai-gateway-limits. Prepara comprobaciones independientes de solo lectura, pero no autoriza Wrangler, no crea una puerta de enlace, no crea un token ni envía tráfico al modelo. LabEx destruye la máquina virtual al finalizar el laboratorio; aun así, deberá eliminar la puerta de enlace y el token en la nube, porque destruir una máquina virtual no elimina los recursos remotos.
Autorice la máquina virtual y asigne un nombre al experimento
En este paso, conectará la máquina virtual recién creada a su cuenta de aprendizaje y registrará nombres únicos para los recursos que le pertenecen.
Cada laboratorio de LabEx comienza en una máquina virtual nueva. Autorizar esta máquina virtual permite que Wrangler invoque Workers AI en su cuenta de aprendizaje; todavía no crea una puerta de enlace.
Entre en el proyecto preparado, confirme la versión fijada de la CLI e inicie la autorización mediante dispositivo:
cd /home/labex/project/ai-gateway-limits
npx wrangler --version
npx wrangler login --device --browser=false --scopes account:read user:read ai:write
Abra el enlace que se muestra, introduzca el código y autorice la cuenta de aprendizaje correcta. Después, consulte los datos de identidad estructurados:
npx wrangler whoami --json
Debe aparecer Wrangler 4.132.0 y loggedIn: true. Sustituya YOUR_ACCOUNT_ID por el ID real de 32 caracteres que se muestra para la cuenta correcta:
GATEWAY_ID="labex-c09-g04-$(openssl rand -hex 6)"
TOKEN_NAME="$GATEWAY_ID-token"
cat > .labex/state.json <<JSON
{
  "accountId": "YOUR_ACCOUNT_ID",
  "gatewayId": "$GATEWAY_ID",
  "tokenName": "$TOKEN_NAME"
}
JSON
cat .labex/state.json
Estos identificadores no son secretos. Guardarlos hace que todas las consultas y acciones de limpieza posteriores se dirijan únicamente a los recursos desechables de este laboratorio.
Cree una puerta de enlace con un límite de solicitudes breve
En este paso, configurará un contador de solicitudes para toda la puerta de enlace que permita demostrar de forma segura la protección contra aumentos repentinos de tráfico.
Un límite de solicitudes es un contador dentro de una ventana de tiempo. Este laboratorio utiliza una ventana deslizante: en cualquier momento, AI Gateway revisa los 20 segundos anteriores. Después de dos solicitudes dentro de ese intervalo, otra solicitud se rechaza con HTTP 429 antes de llegar a Workers AI.
Abra el Cloudflare Dashboard y seleccione AI → AI Gateway → Create a custom gateway. Use el gatewayId guardado. Mantenga activadas las opciones Collect Logs y Authenticated Gateway. Active Rate Limit Requests, seleccione Change y configure:
- límite:
2solicitudes; - intervalo:
20segundos; - técnica:
sliding.
Mantenga desactivados el almacenamiento en caché y los reintentos. Mantenga la facturación de Workers AI en Standard y cree la puerta de enlace. Crear primero la política de solicitudes proporciona un recurso estable antes de agregar la política de costos independiente.
Agregue un límite de gasto con alcance y consúltelo
En este paso, agregará un presupuesto de costos a la misma puerta de enlace y limitará exactamente qué solicitudes se incluyen en él.
Un límite de gasto es un presupuesto, no un contador de solicitudes. AI Gateway estima el costo de cada solicitud completada a partir del precio y el uso del modelo, y después lo suma a las reglas coincidentes. La estimación es eventualmente consistente, por lo que el tráfico simultáneo puede superar brevemente un presupuesto. La limitación de solicitudes sigue siendo útil aunque exista una regla de gasto.
Abra la pestaña Settings de la nueva puerta de enlace. Active Spend Limits, seleccione Add rule y configure una regla:
- límite de costo:
$5; - ventana:
1 day; - técnica:
Sliding; - filtro de proveedor:
workers-ai; - filtro de modelo:
meta/llama-3.3-70b-instruct-fp8-fast.
Guarde la regla y revise ambos controles. El campo del modelo utiliza el formato author/model porque el proveedor ya se seleccionó por separado; la URL de inferencia posterior seguirá usando el nombre completo de Workers AI, que comienza por @cf/.
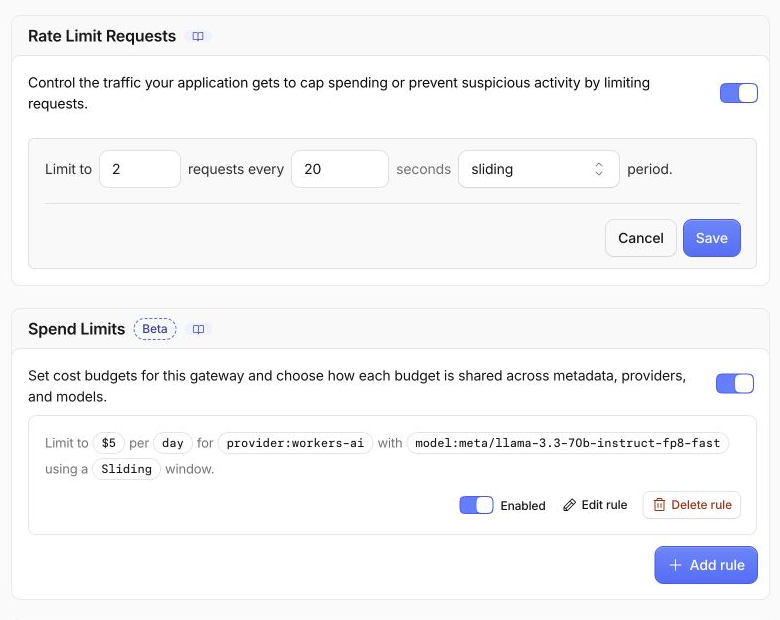
Los filtros de proveedor y modelo convierten esta regla en un límite específico, en lugar de un presupuesto compartido para el tráfico no relacionado de la puerta de enlace. Cinco dólares es un valor deliberadamente alto para este ejercicio pequeño: verificará la política sin intentar agotarla.
Abra My Profile → API Tokens, seleccione Create Token → Create Custom Token y use el tokenName guardado. Agregue dos permisos de cuenta, AI Gateway — Edit y AI Gateway — Run, e incluya únicamente la cuenta de aprendizaje correcta. Edit permite que el laboratorio lea y elimine posteriormente su puerta de enlace exacta; Run autentica el tráfico de inferencia. Wrangler proporciona la credencial ascendente independiente de Workers AI.
Después de revisar el resumen, cree el token. Cloudflare lo muestra una sola vez dentro de un comando de verificación. Copie únicamente el valor del token que aparece después de Bearer, no el comando curl que lo rodea, y guárdelo mediante una entrada oculta:
bash -c '
while :; do
  read -ersp "Paste the AI Gateway token: " GATEWAY_TOKEN
  printf "\n"
  [ -n "$GATEWAY_TOKEN" ] && break
  printf "Token cannot be empty; paste it again.\n" >&2
done
umask 077
printf "%s" "$GATEWAY_TOKEN" > .labex/gateway-token
unset GATEWAY_TOKEN
chmod 600 .labex/gateway-token
'
Consulte los campos importantes que no son secretos mediante la API de administración:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  > .labex/gateway.json
unset GATEWAY_TOKEN
node - <<'NODE'
const b=require('./.labex/gateway.json'), g=b.result||{}, spend=g.spend_limits||{};
console.log(JSON.stringify({
  success:b.success,
  id:g.id,
  rate:{limit:g.rate_limiting_limit,interval:g.rate_limiting_interval,technique:g.rate_limiting_technique},
  spend_limits:{enabled:spend.enabled,rules:spend.rules}
},null,2));
NODE
Debe aparecer una regla de solicitudes de dos solicitudes, 20 segundos y ventana deslizante, además de una regla de costos diaria de cinco dólares activada, con los filtros de proveedor y modelo. Esta consulta confirma la configuración; no significa que se haya consumido el presupuesto.
Observe el rechazo de solicitudes con tres llamadas
En este paso, utilizará tres solicitudes pequeñas para observar la política de conteo de solicitudes sin generar un aumento grande de tráfico.
Ahora enviará tres solicitudes pequeñas de forma secuencial. Las dos primeras se permiten. La tercera debe recibir 429 y no llegar al modelo. Esto es más seguro y económico que generar un gran aumento de tráfico.
Guarde de forma privada el token de Wrangler de corta duración de esta máquina virtual para autorizar el acceso ascendente a Workers AI:
umask 077
npx wrangler auth token --json \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>process.stdout.write(JSON.parse(s).token))' \
  > .labex/upstream-token
chmod 600 .labex/upstream-token
Envíe las tres llamadas. Cada una incluye metadatos sintéticos para que las solicitudes sean fáciles de reconocer en los registros; la regla de gasto las identifica mediante los filtros de proveedor y modelo de Workers AI:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
MODEL='@cf/meta/llama-3.3-70b-instruct-fp8-fast'
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
for NUMBER in 1 2 3; do
  METADATA=$(printf '{"lab":"g04-limits","request":"burst-%s","synthetic":true}' "$NUMBER")
  STATUS=$(curl --http1.1 -sS \
    -o ".labex/burst-$NUMBER-response.json" -w '%{http_code}' \
    -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
    -H "Authorization: Bearer $UPSTREAM_TOKEN" \
    -H "cf-aig-metadata: $METADATA" \
    -H 'Content-Type: application/json' \
    --data "{\"prompt\":\"Reply with the number $NUMBER.\",\"max_tokens\":4}" \
    "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
  printf '%s\n' "$STATUS" | tee ".labex/burst-$NUMBER-status.txt"
done
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
Debe obtener:
200
200
429
El 429 indica que la protección funcionó correctamente. Significa que la solicitud se detuvo en la puerta de enlace, por lo que no consumió otra inferencia del modelo ni incrementó el contador de gasto.
Espere a que se recupere la ventana deslizante
En este paso, esperará a que se despeje la ventana breve y comprobará que la puerta de enlace permite de nuevo la inferencia normal.
Un límite de solicitudes debe proteger contra aumentos repentinos sin desactivar la aplicación de forma permanente. Espere un poco más de los 20 segundos de la ventana y envíe otra solicitud pequeña:
sleep 22
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
MODEL='@cf/meta/llama-3.3-70b-instruct-fp8-fast'
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
STATUS=$(curl --http1.1 -sS \
  -o .labex/recovery-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H 'cf-aig-metadata: {"lab":"g04-limits","request":"recovery","synthetic":true}' \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"Reply only with recovered.","max_tokens":4}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN
printf '%s\n' "$STATUS" | tee .labex/recovery-status.txt
node -e 'const b=require("./.labex/recovery-response.json"); console.log(b.result?.response ?? b.result)'
Debe obtener HTTP 200 y una respuesta breve generada. La recuperación demuestra que el 429 procedía de la ventana de tiempo configurada y no de credenciales incorrectas ni de un modelo que no funciona.
Relacione la política con la evidencia del Dashboard
En este paso, relacionará los resultados de la API y HTTP con los controles y registros visibles en el Dashboard.
Vuelva a AI → AI Gateway, seleccione la puerta de enlace guardada y abra Settings. Confirme que el límite de solicitudes sigue mostrando dos solicitudes, 20 segundos y aplicación deslizante. En Spend Limits, revise la única regla y compruebe que tenga un costo de cinco dólares, una ventana deslizante de un día y los filtros de proveedor y modelo.
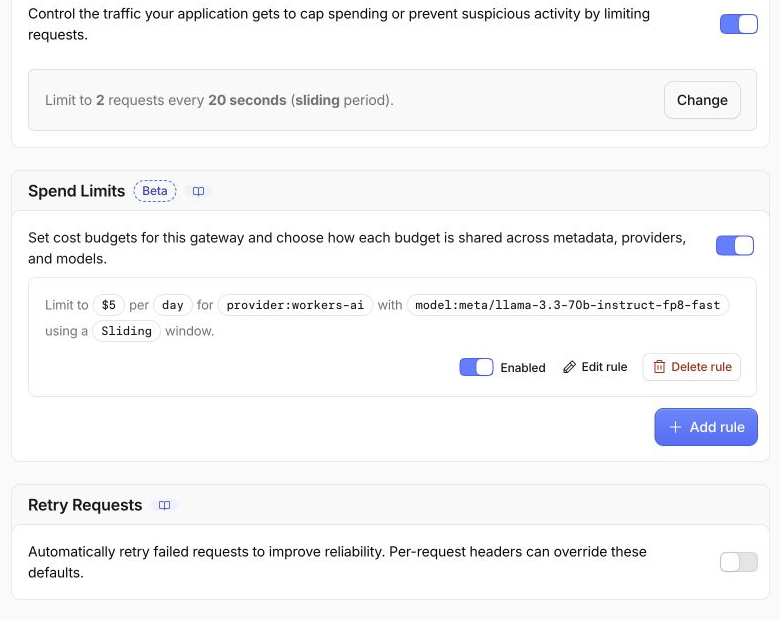
Después, abra Logs. Las dos solicitudes iniciales correctas y la solicitud recuperada deberían aparecer después de la propagación normal de los registros. La tercera solicitud rechazada puede representarse de otra forma porque se detuvo antes de la inferencia del proveedor; el estado HTTP guardado es la evidencia autorizada del límite de solicitudes.
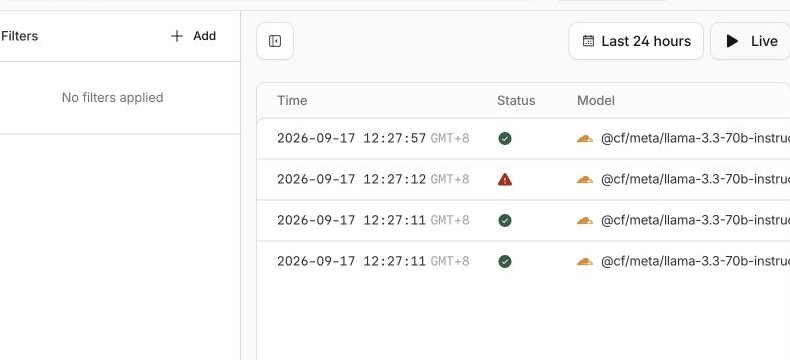
Observe lo que no es necesario: no debe gastar cinco dólares, reducir la regla a un valor peligrosamente pequeño ni repetir llamadas hasta que aparezca un rechazo por costo. La consulta de la API de administración demuestra el alcance de la política de gasto, mientras que el experimento de tres llamadas demuestra por separado la aplicación del conteo de solicitudes.
Elimine la puerta de enlace desechable
En este paso, eliminará únicamente la puerta de enlace indicada en el inventario del laboratorio y comprobará que ya no existe mientras la autorización sigue disponible.
Elimine la puerta de enlace mientras el token de administración todavía pueda demostrar que el recurso exacto desapareció:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -X DELETE \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s);if(!b.success)process.exit(1);console.log("gateway deletion accepted")})'
unset GATEWAY_TOKEN

GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways" \
  > .labex/gateways-after-delete.json
unset GATEWAY_TOKEN
node -e 'const b=require("./.labex/gateways-after-delete.json"),id=process.argv[1],found=(b.result||[]).some(g=>g.id===id);console.log("gateway absent:",!found);if(found)process.exit(1)' "$GATEWAY_ID"
Debe obtener gateway absent: true. Un inventario autenticado distingue una eliminación real de un fallo de red o de una página a la que ya no puede acceder.
Revoque el token y cierre la sesión
En este paso, revocará el token restante del Dashboard, eliminará las dos copias de la máquina virtual y desconectará Wrangler.
En el Cloudflare Dashboard, abra My Profile → API Tokens. Busque el tokenName guardado, abra Actions, seleccione Delete, revise la confirmación y elimine únicamente ese token. Ahora es seguro revocarlo porque la eliminación de la puerta de enlace ya está comprobada.
Elimine las dos copias temporales del token y desconecte Wrangler:
shred -u .labex/gateway-token .labex/upstream-token
npx wrangler logout
npx wrangler whoami --json || true
test ! -e .labex/gateway-token -a ! -e .labex/upstream-token \
  && echo "local token files removed"
Debe obtener loggedIn: false y local token files removed. La sesión del Dashboard es independiente y permanece iniciada. LabEx destruye esta máquina virtual temporal cuando termina el laboratorio en lugar de conservarla.
Resumen
Aplicó dos controles complementarios de AI Gateway. Una ventana deslizante de dos solicitudes rechazó la tercera solicitud de bajo volumen con HTTP 429 y después permitió automáticamente el tráfico cuando la ventana se despejó. Una regla de gasto diaria independiente de cinco dólares se limitó a Workers AI y a un modelo, y su configuración almacenada se verificó sin desperdiciar uso del modelo.
El siguiente laboratorio utiliza otro control de confiabilidad de la puerta de enlace: una alternativa limitada. Enrutará un fallo controlado del modelo principal hacia un segundo modelo compatible, mientras que una solicitud correcta al modelo principal se completará en su primer paso.