Введение
Конечная точка AI зависит не только от вашего JavaScript-кода. Учащийся может отправить некорректные входные данные, выбранная модель может отклонить запрос, для аккаунта может быть достигнута квота или ограничение частоты запросов, вычислительные ресурсы могут временно отсутствовать, а код самого приложения может завершиться с ошибкой. Для каждой такой ситуации нужен свой ответ. Если рассматривать все случаи как «ошибку AI», приложением становится трудно управлять, а повторные попытки могут расходовать ресурсы без пользы.
В этой лабораторной работе вы создадите POST /draft-reply. Размещённая в Cloudflare модель Llama будет формировать один короткий ответ службы поддержки. Worker отклоняет некорректные входные данные до запуска инференса, распознаёт документированные ошибки модели и ограничения, не более одного раза повторяет запрос после временного сбоя, проверяет ответ модели и отдельно сообщает о дефекте приложения. Ограниченная повторная попытка означает, что максимальное число дополнительных попыток задаётся заранее и не может увеличиваться до исчерпания бесплатного ресурса аккаунта.
Большинство сценариев сбоев вы проверите с помощью детерминированных фикстур. Фикстура — это контролируемая замена, которая возвращает заранее выбранный результат или ошибку. Благодаря этому квоту и недоступность сервиса можно проверить, не расходуя квоту намеренно и не вызывая настоящий сбой. Только один короткий локальный запрос и один запрос после развёртывания используют реальную модель.
Это шестая лабораторная работа курса с пошаговым сопровождением. Если вы открыли её напрямую, сначала выполните Connect LabEx to Your Cloudflare Account, чтобы научиться пользоваться терминалом виртуальной машины, авторизовать Wrangler, проверить учебный аккаунт и настроить его идентификатор.
Выбранная модель @cf/meta/llama-3.3-70b-instruct-fp8-fast доступна в стандартной квоте Workers AI. В бесплатный план Workers сейчас включено 10 000 Neurons в день. Пока бесплатная квота не исчерпана, Workers Paid для этой лабораторной работы не требуется. Упражнение и независимая проверка выполняют по одному короткому успешному запросу локально и после развёртывания. Локальный инференс всё равно обращается к Cloudflare и расходует квоту аккаунта, поэтому не повторяйте запросы к реальной модели после сбоя без необходимости.
Настройка устанавливает Node.js 22.22.0 и локальный для проекта Wrangler 4.132.0 в /home/labex/project/resilient-ai-reply. Она также добавляет детерминированные фикстуры и независимые проверки. Настройка не авторизует Wrangler, не создаёт исходный код Worker, не вызывает модель, не выполняет развёртывание и не создаёт облачный ресурс.
Авторизация виртуальной машины и настройка отказоустойчивого Worker
На этом этапе вы авторизуете новую виртуальную машину и настроите один временный Worker. Вход в Cloudflare через браузер не авторизует Wrangler автоматически внутри новой виртуальной машины LabEx.
Перейдите в подготовленный проект и проверьте зафиксированную версию CLI:
cd /home/labex/project/resilient-ai-reply
npx wrangler --version
Запустите авторизацию устройства:
npx wrangler login --device --browser=false --scopes \
  account:read user:read workers_scripts:write workers_kv:write ai:write
Откройте показанный URL авторизации в браузере, выберите нужный учебный аккаунт и подтвердите перечисленные разрешения. Разрешение KV compatibility требуется этой версии Wrangler при удалении Worker; в этой лабораторной работе данные KV не создаются и не изменяются.
Проверьте авторизацию с помощью структурированного вывода:
npx wrangler whoami --json
Убедитесь, что значение "loggedIn": true, проверьте имя аккаунта и скопируйте настоящий идентификатор этого аккаунта в следующую конфигурацию. Сгенерируйте уникальное имя и создайте wrangler.jsonc:
RUN="labex-c07-a06-$(openssl rand -hex 6)"
printf 'Worker name: %s\n' "$RUN"
cat > wrangler.jsonc <<EOF
{
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "account_id": "PASTE_YOUR_ACCOUNT_ID_HERE",
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
EOF
Binding AI предоставляет коду Worker интерфейс env.AI, связанный с аккаунтом. Параметр remote: true также означает, что локальные запросы Wrangler используют настоящий сервис Workers AI и учитываются в общей квоте.
Разделение категорий сбоев
На этом этапе вы определите небольшой публичный контракт для нескольких совершенно разных причин сбоя, прежде чем писать код восстановления.
HTTP-статус сообщает клиенту, какой результат произошёл. Он не должен раскрывать исходные сообщения провайдера, данные аккаунта или трассировки стека. В этой лабораторной работе используются пять границ:
400 invalid_request: входные данные учащегося отсутствуют или имеют недопустимый размер, поэтому инференс не запускается.502 model_incompatibleилиincompatible_model_response: выбранная модель или форма возвращённых данных не соответствует контракту приложения. Повторение того же запроса не исправит проблему совместимости.503 model_quota_exhaustedилиmodel_rate_limited: ограничение аккаунта или модели требует остановиться. Немедленная автоматическая повторная попытка создаст ещё один запрос и дополнительную нагрузку.503 model_temporarily_unavailable: тайм-аут или временная нехватка ресурсов привели к двум сбоям. Ответ содержитRetry-After, чтобы клиент мог подождать перед следующим запросом.500 application_failure: инференс модели вернул пригодные данные, но собственный шаг форматирования приложения завершился с ошибкой.
Cloudflare документирует внутренний код 3036 для исчерпанной дневной бесплатной квоты, 3040 для временной нехватки ресурсов, 3007 для тайм-аута и 5035 для модели, которой требуется Workers Paid. Приложение преобразует известные сигналы в стабильные публичные ошибки и записывает в журнал только категорию, число попыток и идентификатор трассировки.
Сгенерируйте объявления TypeScript и проверьте binding AI:
npx wrangler types
grep -nE 'interface Env|AI: Ai' worker-configuration.d.ts
Сгенерированное объявление подтверждает, что Worker может использовать env.AI. Оно не подтверждает успешность вызова модели: авторизация, квота, совместимость модели и состояние сервиса проверяются во время выполнения.
Реализация ограниченного восстановления
На этом этапе вы реализуете классификацию сбоев, ограничение в одну повторную попытку и отдельные границы для ответа модели и приложения.
Создайте точку входа Worker:
cat > src/index.js <<'WORKER'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_MESSAGE = 500;
const RETRY_DELAY_MS = 25;
const RETRY_AFTER_SECONDS = 30;

function json(data, status = 200, headers = {}) {
  return Response.json(data, { status, headers });
}

async function readMessage(request) {
  if (request.method !== "POST") return { error: json({ error: "method_not_allowed" }, 405) };
  let body;
  try { body = await request.json(); }
  catch { return { error: json({ error: "invalid_request" }, 400) }; }
  if (typeof body?.message !== "string") return { error: json({ error: "invalid_request" }, 400) };
  const message = body.message.trim();
  if (!message || message.length > MAX_MESSAGE) return { error: json({ error: "invalid_request" }, 400) };
  return { message };
}

function numeric(value) {
  const number = Number(value);
  return Number.isFinite(number) ? number : undefined;
}

export function classifyModelError(error) {
  const code = numeric(error?.code ?? error?.cause?.code);
  const status = numeric(error?.status ?? error?.cause?.status);
  if ([5004, 5005, 5007, 5016, 5018, 5035, 3042].includes(code) ||
      [400, 403, 404, 405, 413].includes(status)) {
    return { kind: "model_incompatible", status: 502, retryable: false };
  }
  if (code === 3036) return { kind: "model_quota_exhausted", status: 503, retryable: false };
  if (code === 3040 || code === 3007 || status >= 500) {
    return { kind: "model_temporarily_unavailable", status: 503, retryable: true };
  }
  if (status === 429) return { kind: "model_rate_limited", status: 503, retryable: false };
  return { kind: "model_unavailable", status: 503, retryable: false };
}

export async function runWithBoundedRecovery(run, input, traceId, sleep) {
  for (let attempt = 1; attempt <= 2; attempt += 1) {
    try {
      return { result: await run(input), attempts: attempt };
    } catch (error) {
      const failure = classifyModelError(error);
      if (failure.retryable && attempt === 1) {
        console.log(JSON.stringify({
          event: "model_retry_scheduled",
          kind: failure.kind,
          attempt,
          traceId
        }));
        await sleep(RETRY_DELAY_MS);
        continue;
      }
      return { failure, attempts: attempt };
    }
  }
}

function formatReply(reply) {
  return reply.trim();
}

export async function handleDraftReply(request, env, options = {}) {
  const parsed = await readMessage(request);
  if (parsed.error) return parsed.error;

  const traceId = crypto.randomUUID();
  const run = options.run ?? (input => env.AI.run(MODEL, input));
  const sleep = options.sleep ?? (ms => new Promise(resolve => setTimeout(resolve, ms)));
  const outcome = await runWithBoundedRecovery(run, {
    messages: [
      { role: "system", content: "Draft one concise support reply under 80 words. Do not invent account actions." },
      { role: "user", content: parsed.message }
    ],
    max_tokens: 120
  }, traceId, sleep);

  if (outcome.failure) {
    console.log(JSON.stringify({
      event: "model_request_failed",
      kind: outcome.failure.kind,
      attempts: outcome.attempts,
      retryable: outcome.failure.retryable,
      traceId
    }));
    const headers = outcome.failure.retryable ? { "retry-after": String(RETRY_AFTER_SECONDS) } : {};
    return json({ error: outcome.failure.kind, retryable: outcome.failure.retryable },
      outcome.failure.status, headers);
  }

  if (typeof outcome.result?.response !== "string" ||
      !outcome.result.response.trim() ||
      outcome.result.response.length > 1200) {
    console.log(JSON.stringify({
      event: "model_response_rejected",
      attempts: outcome.attempts,
      traceId
    }));
    return json({ error: "incompatible_model_response", retryable: false }, 502);
  }

  let reply;
  try {
    reply = (options.format ?? formatReply)(outcome.result.response);
  } catch {
    console.log(JSON.stringify({ event: "application_failure", traceId }));
    return json({ error: "application_failure", retryable: false }, 500);
  }

  console.log(JSON.stringify({
    event: "reply_generated",
    model: MODEL,
    attempts: outcome.attempts,
    traceId
  }));
  return json({ model: MODEL, reply, attempts: outcome.attempts, traceId });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (url.pathname === "/health") return json({ ok: true });
    if (url.pathname === "/draft-reply") return handleDraftReply(request, env);
    return json({ error: "not_found" }, 404);
  }
};
WORKER
Цикл повторных попыток разрешает всего два вызова: первоначальный и ещё один, только для известной временной категории. Ошибки квоты, ограничения частоты и совместимости сразу прекращают выполнение. Обратите внимание: вызов модели, проверка ответа и форматирование приложением разделены. Благодаря этому оператор может отличить проблему провайдера от дефекта приложения.
Публичный ответ никогда не содержит исходное исключение. В журналах отсутствуют сообщение службы поддержки и сгенерированный ответ; сохраняются только необходимые для расследования категории сбоя метаданные жизненного цикла.
Проверка матрицы сбоев без расходования квоты
На этом этапе вы проверите каждую категорию сбоя с помощью контролируемых фикстур, прежде чем выполнять настоящий запрос к модели.
Запустите детерминированный набор тестов:
node --test test/worker.test.mjs
В девяти случаях используются фикстуры, а не реальный инференс. Убедитесь, что некорректные входные данные приводят к нулю вызовов модели, ошибки квоты и ограничения частоты — к одному вызову, временная нехватка ресурсов — не более чем к двум вызовам, некорректный формат ответа — к ошибке совместимости, а дефект форматирования — к ошибке приложения.
Теперь соберите точный Worker:
npx wrangler deploy --dry-run --outdir /tmp/a06-dry-run
Пробный запуск проверяет, может ли Wrangler собрать модуль, и должен показать binding AI. Развёртывание и вызов модели не выполняются.
Проверка успешного инференса и изучение подтверждений
На этом этапе вы выполните один успешный локальный запрос и один запрос к развёрнутому Worker, а затем сопоставите их результаты с доступными только для чтения данными Dashboard Cloudflare.
Запустите локальный Wrangler в фоновом режиме и дождитесь ответа маршрута health, который не обращается к AI. Ограниченный цикл не позволит ожиданию продолжаться бесконечно:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
for attempt in $(seq 1 30); do
  curl --silent --fail http://127.0.0.1:8787/health >/dev/null && break
  sleep 1
done
curl --silent --show-error http://127.0.0.1:8787/draft-reply \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
В ответе должны присутствовать непустой reply, точное имя модели, идентификатор трассировки и значение attempts, равное 1 в обычном успешном случае. Значение 2 означает, что один временный сбой удалось устранить в пределах установленного ограничения.
Запустите независимую локальную проверку, остановите сохранённый процесс и выполните развёртывание:
./.labex/verify.py local
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
npx wrangler deploy
Скопируйте точный URL workers.dev из вывода команды развёртывания и проверьте общедоступную конечную точку:
WORKER_URL="https://YOUR_WORKER_URL"
curl --silent --show-error "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":"My keyboard stopped working after the latest update."}'
curl --silent --show-error --include "$WORKER_URL/draft-reply" \
  -H 'content-type: application/json' \
  --data '{"message":""}'
./.labex/verify.py deployed
Пустое сообщение должно вернуть HTTP 400 до запуска инференса. Это подтверждает защиту входных данных и не расходует ещё один запрос к модели.
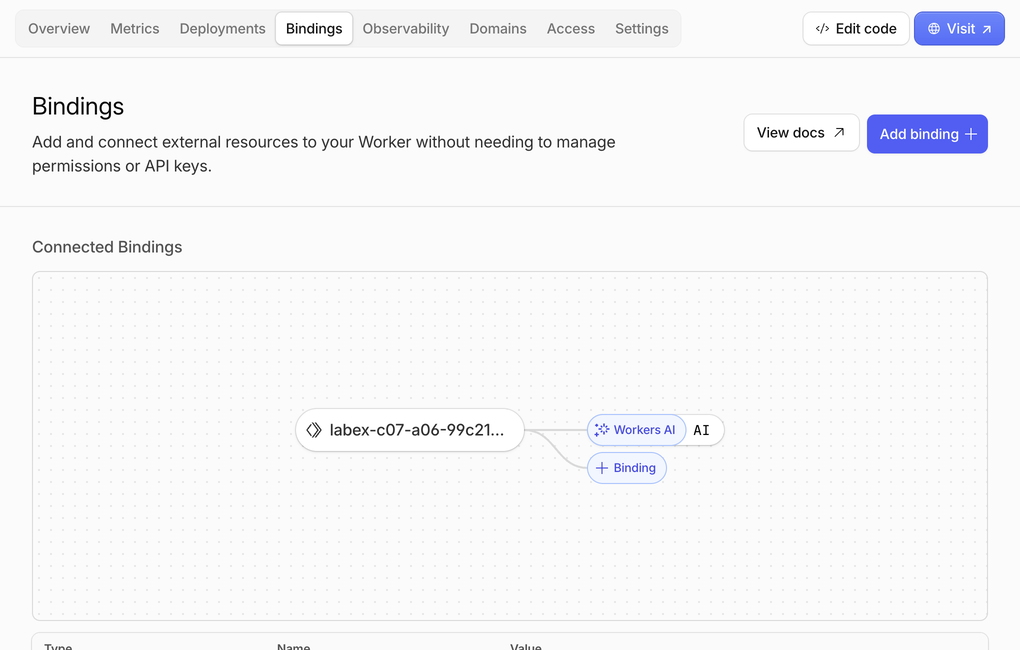
Откройте Workers & Pages, выберите Worker с точным именем и перейдите в раздел Bindings. Binding — это именованное соединение, которое позволяет коду Worker обращаться к другому сервису Cloudflare без хранения API-ключа. Убедитесь, что присутствует одно соединение Workers AI с именем AI; приведённое ниже имя Worker относится к тестовому запуску, а ваше имя будет содержать другой случайный суффикс.
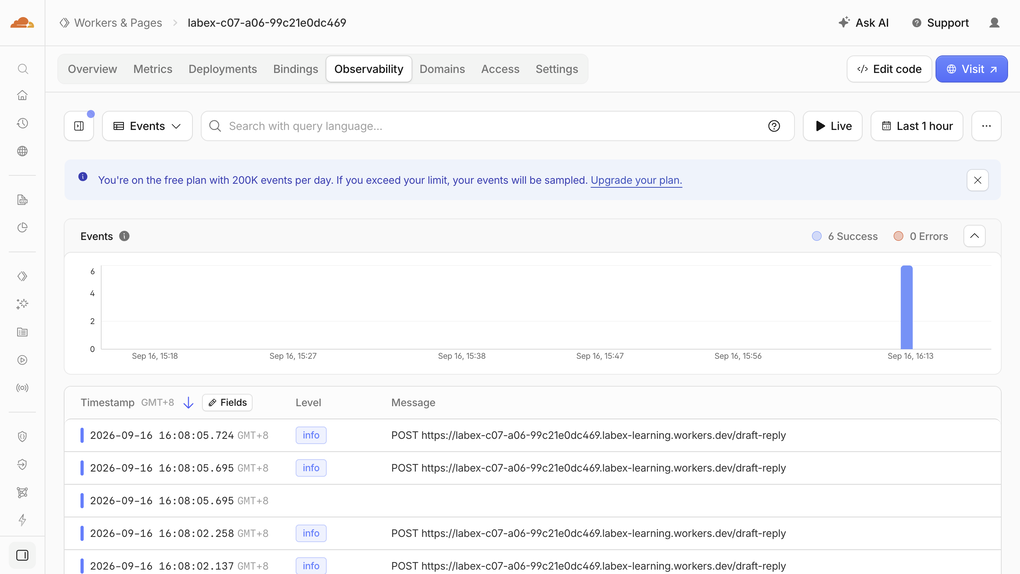
Затем откройте Observability. В примере было создано шесть успешных событий и не было ошибок. Числа могут отличаться: один запрос может создать и запись о вызове, и запись журнала приложения, а сохранённые журналы могут появиться после ответа.
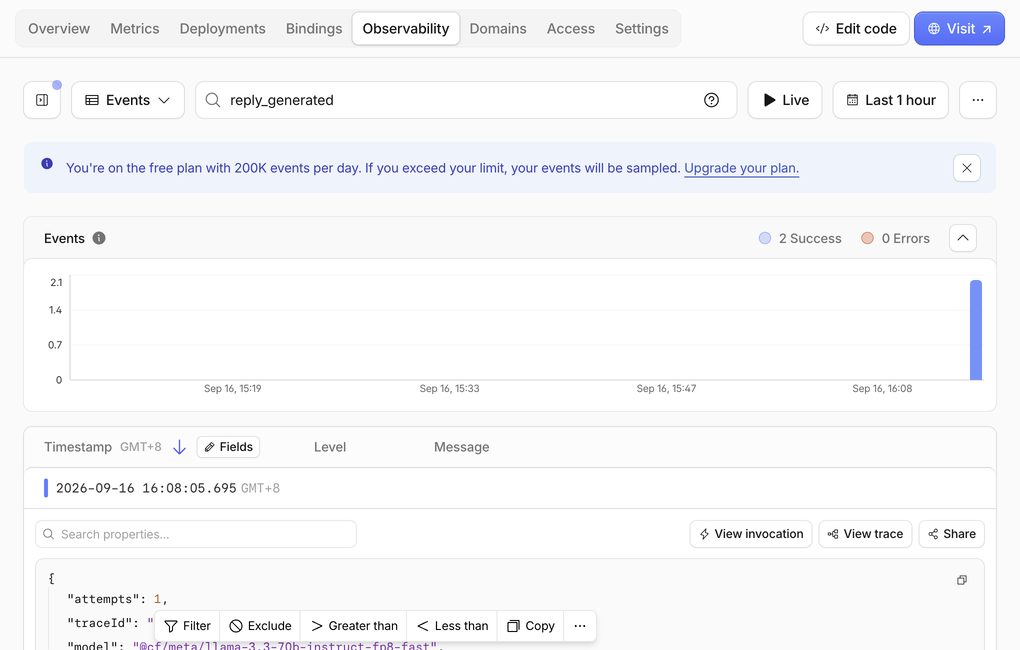
Синее уведомление о бесплатном плане здесь описывает лимит событий Workers Logs, а не использование инференса AI. Найдите reply_generated и разверните один результат. В рассматриваемом примере показаны два успешных совпадения и намеренно ограниченный набор полей приложения: одна попытка, идентификатор трассировки и точная модель. Полное событие также содержит event: "reply_generated", но приложение не записывает сообщение службы поддержки, сгенерированный ответ или исходную ошибку провайдера.
Наконец, откройте AI > Workers AI и оставьте выбранной вкладку Neurons. Neuron — это единица измерения вычислений AI в Cloudflare. В общем примере аккаунта за этот день было использовано 428.59/10k Neurons: 427.82 пришлось на модель Llama, а 0.77 — на предыдущую лабораторную работу с embedding. Эти итоги включают другие упражнения курса и могут обновиться с задержкой; это не стоимость одного запроса.
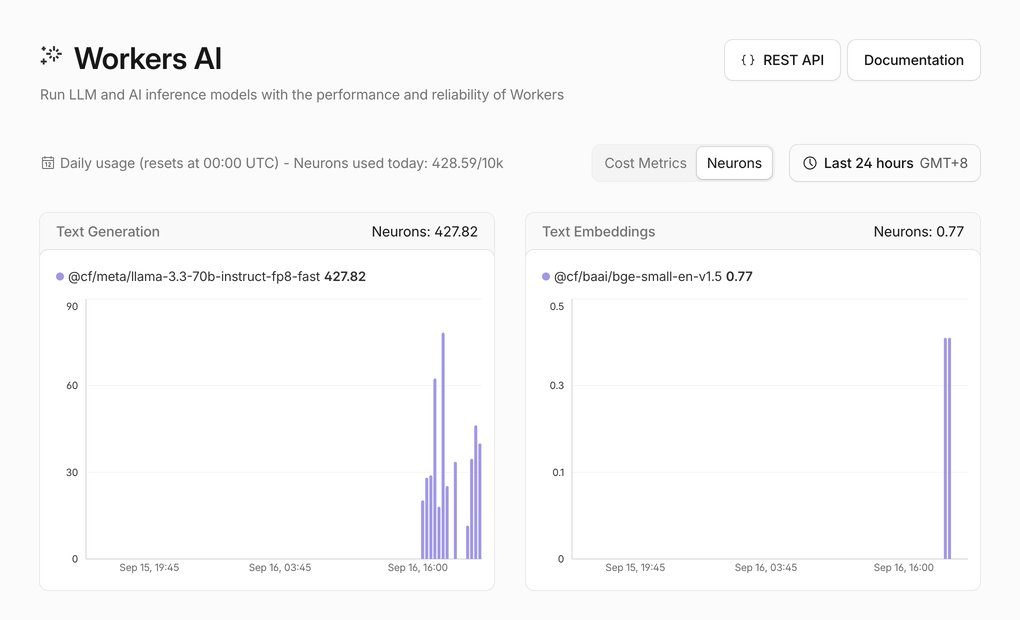
Убедитесь только, что использование остаётся в пределах доступной дневной квоты. Представления Dashboard помогают связать конфигурацию, трафик и использование с результатом командной строки, но авторитетными остаются ответ во время выполнения и независимые проверки. Не повторяйте инференс только для того, чтобы изменить график.
Удаление Worker и выход из аккаунта
На этом этапе вы удалите временную конечную точку, пока авторизация ещё доступна, а затем удалите эту авторизацию с виртуальной машины.
Удалите только временный Worker, имя которого указано в wrangler.jsonc:
npx wrangler delete --force
Проверьте отсутствие ресурса, пока Wrangler всё ещё авторизован:
./.labex/verify.py deleted
Теперь удалите сохранённые данные авторизации этой виртуальной машины:
npx wrangler logout
npx wrangler whoami --json
Убедитесь, что значение "loggedIn": false, затем запустите финальную проверку:
./.labex/verify.py logout
Удаление Worker удаляет облачный ресурс, а выход из аккаунта удаляет авторизацию с этой виртуальной машины. Это два отдельных действия очистки.
Резюме
Вы создали конечную точку Workers AI, которая:
- отклоняет некорректные входные данные до запуска инференса;
- различает ошибки совместимости, квоты, ограничения частоты, временные и прикладные ошибки;
- повторяет известную временную ошибку не более одного раза;
- проверяет ответ модели до форматирования приложением;
- возвращает стабильные публичные ошибки и не раскрывает исходные данные провайдера;
- записывает метаданные жизненного цикла с ограниченным объёмом данных;
- проверяет поведение при сбоях с помощью детерминированных фикстур, не расходуя квоту;
- подтверждает успешный локальный инференс и инференс после развёртывания в Workers Free; и
- удаляет временный Worker и выходит из аккаунта на виртуальной машине.
Главная эксплуатационная привычка — не «повторять любую ошибку AI». Сначала определите границу сбоя, повторяйте запрос только при действительно временной проблеме и только в пределах фиксированного ограничения, а клиенту возвращайте понятный ответ, подсказывающий дальнейшее действие.