Введение
Обычно приложение работает по правилам, непосредственно записанным в его коде. Инференс искусственного интеллекта (AI) добавляет другой тип операции: приложение отправляет входные данные обученной модели, а модель генерирует результат. Инструкция и контекст, отправленные модели, называются промптом. Формулировка результата может отличаться от запроса к запросу, поэтому надёжное приложение ограничивает входные данные и проверяет результат, а не ожидает одну-единственную фразу.
Cloudflare Workers AI позволяет Worker запускать поддерживаемые AI-модели через платформу Cloudflare. Worker — это код приложения, который обрабатывает запросы в сети Cloudflare. AI-привязка — это настроенное подключение, благодаря которому Workers AI доступен коду через env.AI; отдельный API-ключ провайдера не нужно хранить в проекте.
В этой лабораторной работе приложению поддержки нужна краткая сводка заявки до того, как оператор откроет её полное описание. Вы настроите AI-привязку, реализуете конечную точку POST /summaries, отклоните неподходящие входные данные до запуска инференса, протестируете тот же Worker локально, развернёте его и проверите работу Worker и AI в Cloudflare Dashboard. В лабораторной работе используется модель @cf/meta/llama-3.3-70b-instruct-fp8-fast, размещённая в Cloudflare и доступная в рамках стандартной бесплатной квоты Workers AI. Формулировка ответа не оценивается; оценивается контракт приложения.
Перед началом этого курса пройдите лабораторную работу Connect LabEx to Your Cloudflare Account. В ней объясняется работа с терминалом виртуальной машины LabEx, авторизация устройства, подтверждение аккаунта и сохранение фактического идентификатора аккаунта. Также вам нужно знать, как небольшой JavaScript Worker обрабатывает HTTP-запрос. Знания в области машинного обучения не требуются.
В настоящее время Workers AI предоставляет аккаунтам Workers Free общую суточную квоту в 10 000 Neuron — единиц вычислений модели в Cloudflare. В этой лабораторной работе используются небольшие промпты и ответы, поэтому платный план не нужен, однако другие операции в том же аккаунте используют эту же квоту. Перед началом изучите актуальную страницу модели Llama 3.3 и информацию о тарифах Workers AI. Если суточная квота уже исчерпана, инференс не будет выполняться до её сброса; не создавайте повторные запросы в попытке обойти ограничение. Локальная разработка Workers AI также использует облачную модель и учитывается в квоте — это не офлайн-симуляция.
В рамках настройки устанавливаются Node.js 22.22.0 и локальный для проекта Wrangler 4.132.0 в /home/labex/project/ticket-summary. Также предоставляются детерминированные тесты, имитирующие ответ AI без вызова модели. Настройка не выполняет вход, не меняет план, не развёртывает приложение и не запускает инференс. Не закрывайте эту виртуальную машину, пока временный Worker не будет удалён, а выход из аккаунта не будет подтверждён.
Авторизация виртуальной машины и выбор аккаунта
На этом шаге вы подключите новую виртуальную машину LabEx к своему учебному аккаунту Cloudflare и создадите уникальную конфигурацию Worker. Сеанс браузера в Dashboard не авторизует команды терминала на виртуальной машине автоматически.
Перейдите в подготовленный проект и проверьте закреплённую версию Wrangler:
cd /home/labex/project/ticket-summary
npx wrangler --version
Ожидаемый результат — 4.132.0. Запустите авторизацию устройства только с разрешениями, необходимыми для этой лабораторной работы. Разрешение workers_scripts:write позволяет развернуть, прочитать и удалить временный Worker. ai:write позволяет Worker вызывать Workers AI. Wrangler 4.132.0 также проверяет ссылки на привязки KV при удалении Worker, поэтому workers_kv:write позволяет завершить эту проверку, хотя в этой лабораторной работе пространство имён KV не создаётся. Разрешения на чтение аккаунта и пользователя позволяют подтвердить нужный аккаунт.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Откройте показанную ссылку в браузере, введите текущий код устройства, проверьте разрешения и выберите учебный аккаунт. Также может появиться Background Access, поскольку Wrangler должен продолжать работу после завершения процедуры в браузере. Нажимайте кнопку авторизации только после того, как аккаунт и список разрешений будут соответствовать этой лабораторной работе. Затем вернитесь в терминал и дождитесь сообщения об успешном завершении.
npx wrangler whoami --json
Убедитесь, что указано loggedIn: true, затем прочитайте name и id аккаунта, который собираетесь использовать, даже если в списке присутствует только один аккаунт. Имя помогает не выбрать неправильный аккаунт, а идентификатор — это стабильное значение, которое Wrangler сохраняет в конфигурации.
Создайте уникальное имя Worker. Команда openssl rand -hex 6 создаёт 12 случайных шестнадцатеричных символов, а $(...) подставляет их в переменную оболочки.
RUN="labex-c07-a01-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Скопируйте выбранный идентификатор аккаунта в приведённую ниже конфигурацию, заменив YOUR_ACCOUNT_ID. Here-документ записывает строки между двумя маркерами JSON в wrangler.jsonc. Маркер без кавычек позволяет раскрыть $RUN, а обратная косая черта сохраняет ключ $schema буквально.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
compatibility_date фиксирует поведение среды выполнения, проверяемое в этой лабораторной работе. observability сохраняет данные о вызовах и журналы приложения для последующей проверки в Dashboard. Запись файла не разворачивает Worker и не вызывает модель.
Проверка AI-привязки Workers
На этом шаге вы превратите конфигурацию в типизированное описание окружения Worker и свяжете имя привязки с кодом, который напишете далее.
Привязка — это именованная возможность, предоставляемая средой выполнения Workers. Имя AI в wrangler.jsonc означает, что Worker будет использовать env.AI для запуска моделей. В исходном коде нет API-токена: Cloudflare подключает развёрнутый Worker к выбранному аккаунту. Параметр remote: true важен при выполнении wrangler dev, поскольку инференс модели всегда происходит в Cloudflare, даже если сам обработчик запросов запускается на этой виртуальной машине.
Сгенерируйте описание типов окружения на основе конфигурации проекта:
npx wrangler types
Wrangler создаст файл worker-configuration.d.ts. Найдите сгенерированную запись Env, а не просматривайте весь файл:
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
В выводе будет AI-привязка, например:
interface __BaseEnv_Env {
    AI: Ai;
}
Wrangler размещает сгенерированные привязки в базовом интерфейсе, а затем расширяет его интерфейсом Env. Строка AI: Ai — полезная проверка согласованности: если изменить имя привязки в конфигурации и забыть обновить код, развёртывание завершится, но Worker не будет работать во время выполнения. Повторно генерируйте типы после каждого изменения привязок. Полная имитация развёртывания, которую вы выполните позднее, проверит конфигурацию и пакет Worker вместе.
Создание конечной точки для ограниченной по размеру сводки
На этом шаге вы реализуете границу обработки запроса и вызов модели. Языковая модель хорошо создаёт компактное объяснение, но ей не следует поручать определять, безопасно ли обрабатывать произвольный запрос. Обычный код приложения должен отклонять неправильный тип содержимого, некорректный JSON, отсутствующие сведения и слишком большие входные данные до запуска инференса.
Конечная точка отправит модели два сообщения. Системное сообщение задаёт роль модели и ограничение на ответ. Пользовательское сообщение содержит синтетическую заявку. Модели читают и создают токены — небольшие фрагменты текста, которыми могут быть слово, часть слова или знак пунктуации. max_tokens ограничивает объём генерируемого ответа, а приложение отдельно ограничивает количество входных символов. Это разные элементы управления: один ограничивает отправляемый объём, другой — объём, который может сгенерировать модель. temperature управляет степенью вариативности; указанное здесь низкое значение способствует стабильной сводке, но не гарантирует одинаковую формулировку.
Создайте точку входа Worker:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_DETAILS = 2000;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readTicket(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 4096) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const subject = typeof body?.subject === "string" ? body.subject.trim() : "";
  const details = typeof body?.details === "string" ? body.details.trim() : "";
  if (!details) {
    return { error: json({ error: "invalid_ticket" }, 400) };
  }
  if (subject.length > 120 || details.length > MAX_DETAILS) {
    return { error: json({ error: "ticket_too_large" }, 413) };
  }
  return { ticket: { subject, details } };
}

async function summarize(request, env) {
  const requestId = crypto.randomUUID();
  const parsed = await readTicket(request);
  if (parsed.error) return parsed.error;

  try {
    const result = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Summarize this support ticket in one plain sentence. Do not invent facts."
        },
        {
          role: "user",
          content: `Subject: ${parsed.ticket.subject || "(none)"}\nDetails: ${parsed.ticket.details}`
        }
      ],
      max_tokens: 120,
      temperature: 0.2
    });

    const summary = result.response?.trim();
    if (!summary) throw new Error("empty model response");

    console.log(JSON.stringify({
      event: "ticket_summarized",
      requestId,
      model: MODEL,
      inputCharacters: parsed.ticket.details.length,
      totalTokens: result.usage?.total_tokens ?? null
    }));

    return json({ summary, model: MODEL, requestId });
  } catch (error) {
    console.error(JSON.stringify({
      event: "ticket_summary_failed",
      requestId,
      model: MODEL,
      reason: error instanceof Error ? error.message : "unknown"
    }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/summaries") {
      return summarize(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
Каждый запрос получает случайный идентификатор запроса, который появляется и в ответе, и в журнале. Это позволяет отследить один запрос, не записывая его заявку. Код записывает этот идентификатор, выбранную модель и счётчики, но не текст заявки. Благодаря этому последующая наблюдаемость — записи, помогающие понять, что сделал Worker, — остаётся полезной и не копирует содержимое заявок в данные мониторинга. Код также проверяет строку response, возвращаемую именно этой моделью, вместо предположения, что каждая модель Workers AI возвращает одинаковый объект.
Запустите предоставленные детерминированные тесты. Они заменяют env.AI небольшим тестовым объектом, поэтому эти тесты не расходуют ресурсы модели:
node --test test/worker.test.mjs
Ожидайте четыре успешно пройденных теста. Затем попросите Wrangler собрать Worker без развёртывания:
npx wrangler deploy --dry-run
Тесты подтверждают контракты входных и выходных данных на контролируемых данных модели. Имитация развёртывания подтверждает, что Wrangler может собрать настоящий Worker. Ни одна из этих проверок не доказывает, что модель доступна сейчас или что в аккаунте ещё есть суточная бесплатная квота; это вы проверите следующим шагом одним реальным запросом.
Выполнение одного локального инференса
На этом шаге вы запустите обработчик запросов на виртуальной машине, а его привязка AI вызовет настоящую модель, размещённую в Cloudflare. Это называется локальной разработкой, но локальным является только процесс Worker — инференс выполняется удалённо и учитывается в квоте.
Запустите Wrangler в фоновом режиме на порту 8787. > сохраняет журналы в файл, 2>&1 направляет ошибки в тот же файл, а & возвращает приглашение командной строки, пока сервер продолжает работать. Сохранение $! записывает идентификатор процесса для последующего завершения.
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Дождитесь ответа маршрута проверки состояния:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
Ответ проверки состояния должен быть {"status":"ok"}. Он не вызывает модель. Теперь отправьте небольшую синтетическую заявку. Параметр --data превращает запрос в POST, а заголовок сообщает Worker, что нужно разобрать JSON.
curl --silent --show-error http://127.0.0.1:8787/summaries \
  --header 'Content-Type: application/json' \
  --data '{"subject":"Invoice upload fails","details":"After signing in, the customer selects a PDF invoice. The upload stops before completion and no confirmation appears."}' | jq
Ожидайте непустое поле summary, точный идентификатор модели и уникальный для этого запуска requestId. Ваша фраза может отличаться от приведённого примера:
{
  "summary": "The customer cannot complete a PDF invoice upload after signing in.",
  "model": "@cf/meta/llama-3.3-70b-instruct-fp8-fast",
  "requestId": "..."
}
Убедитесь, что некорректные входные данные отклоняются обычным кодом до запуска инференса:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/summaries \
  --header 'Content-Type: application/json' \
  --data '{"details":""}'
Ожидайте {"error":"invalid_ticket"} и HTTP-код 400. Приложение не отправляет этот запрос модели. Если корректный запрос возвращает model_unavailable, проверьте .labex/dev.log; исчерпанная бесплатная квота, недостаток ресурсов модели или ошибка авторизации не подтверждают прохождение контракта конечной точки.
Развёртывание и проверка Worker с AI
На этом шаге вы остановите локальный процесс, развернёте тот же код в Cloudflare и сопоставите данные командной строки с состоянием, отображаемым в Dashboard.
Остановите только сохранённый процесс разработки и дождитесь его завершения:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Разверните Worker:
npx wrangler deploy
Wrangler выведет общедоступный URL workers.dev. Сохраните этот URL без изменений, заменив пример ниже:
WORKER_URL="https://YOUR_WORKER_URL"
Отправьте новую синтетическую заявку на развёрнутую конечную точку:
curl --silent --show-error "$WORKER_URL/summaries" \
  --header 'Content-Type: application/json' \
  --data '{"subject":"Password reset loop","details":"The customer opens the reset email, chooses a new password, and returns to the sign-in page, but the old password remains active."}' | jq
Сгенерированная фраза может отличаться, но поле model должно указывать на Llama 3.3, а requestId должно присутствовать. Это подтверждает, что общедоступный Worker достиг настроенной AI-привязки.
Откройте Cloudflare Dashboard и перейдите в Workers & Pages → Overview → ваш Worker labex-c07-a01-... → Settings → Bindings. Найдите AI-привязку Workers AI с именем AI. Это видимое соединение между wrangler.jsonc и env.AI в коде.
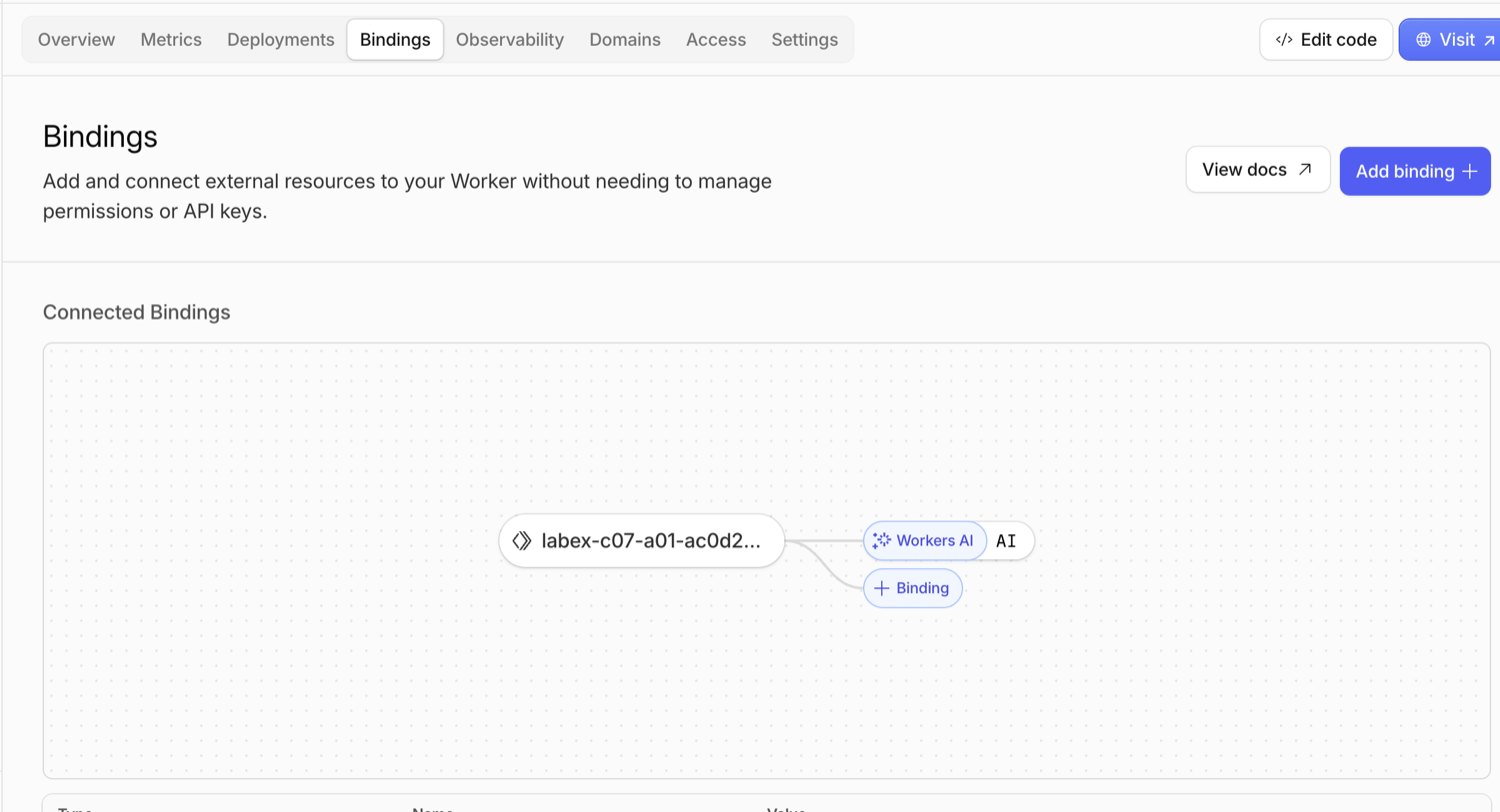
В примере показано имя привязки AI, совпадающее с именем, используемым в env.AI. Имя вашего временного Worker будет другим.
Затем откройте Observability → Logs для того же Worker. Найдите недавний успешный вызов и разверните структурированный журнал ticket_summarized. Сопоставьте его идентификатор запроса с ответом развёрнутого Worker. В журнале должны быть указаны модель и счётчики, но не текст заявки. Если сохранённые журналы ещё не появились, используйте Real-time logs, отправьте ещё один небольшой синтетический запрос и проверьте этот вызов.
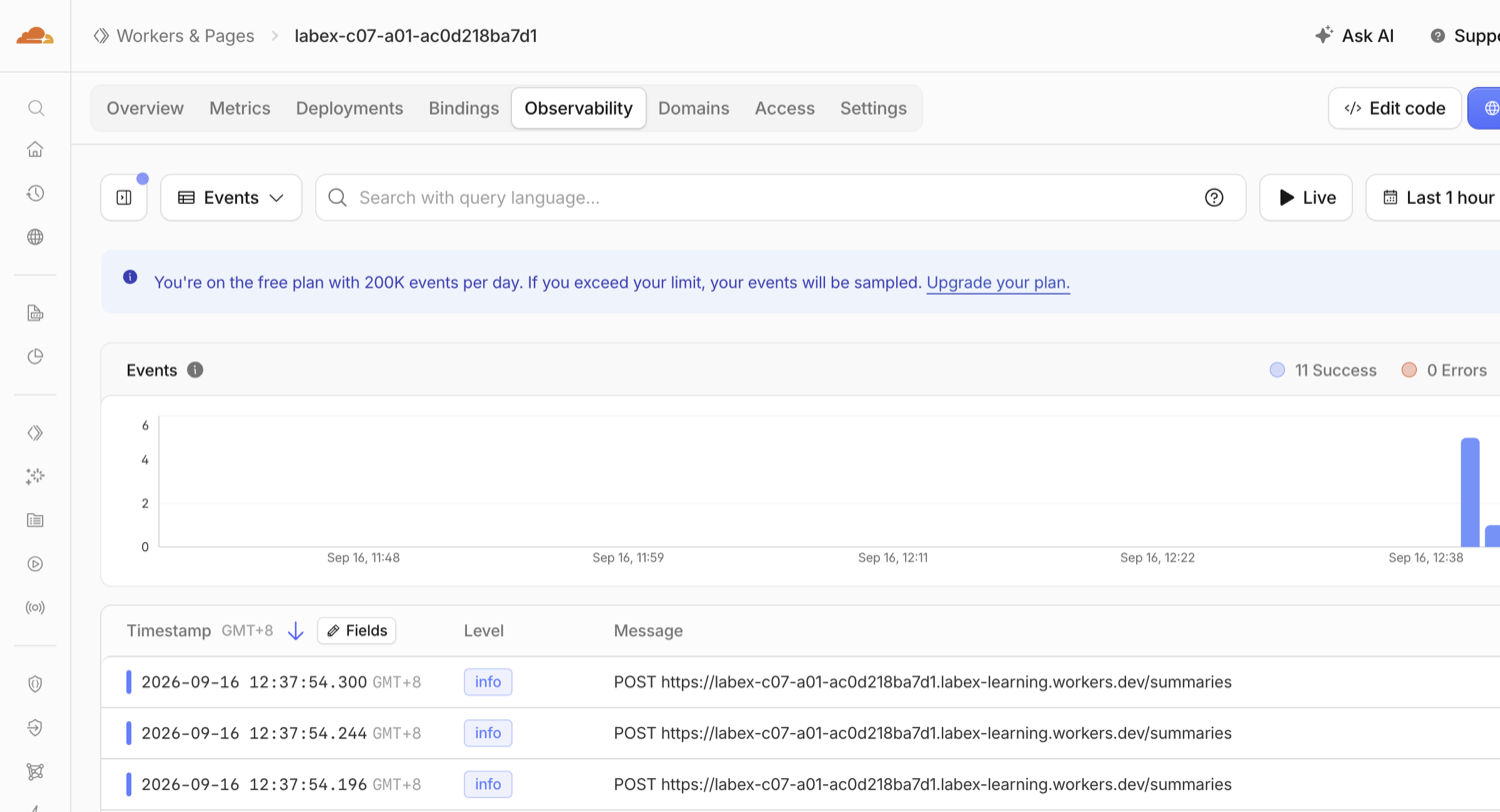
Вначале обзор подтверждает, что запросы достигли Worker без ошибок. Открыв один запрос, вы увидите структурированное событие приложения:
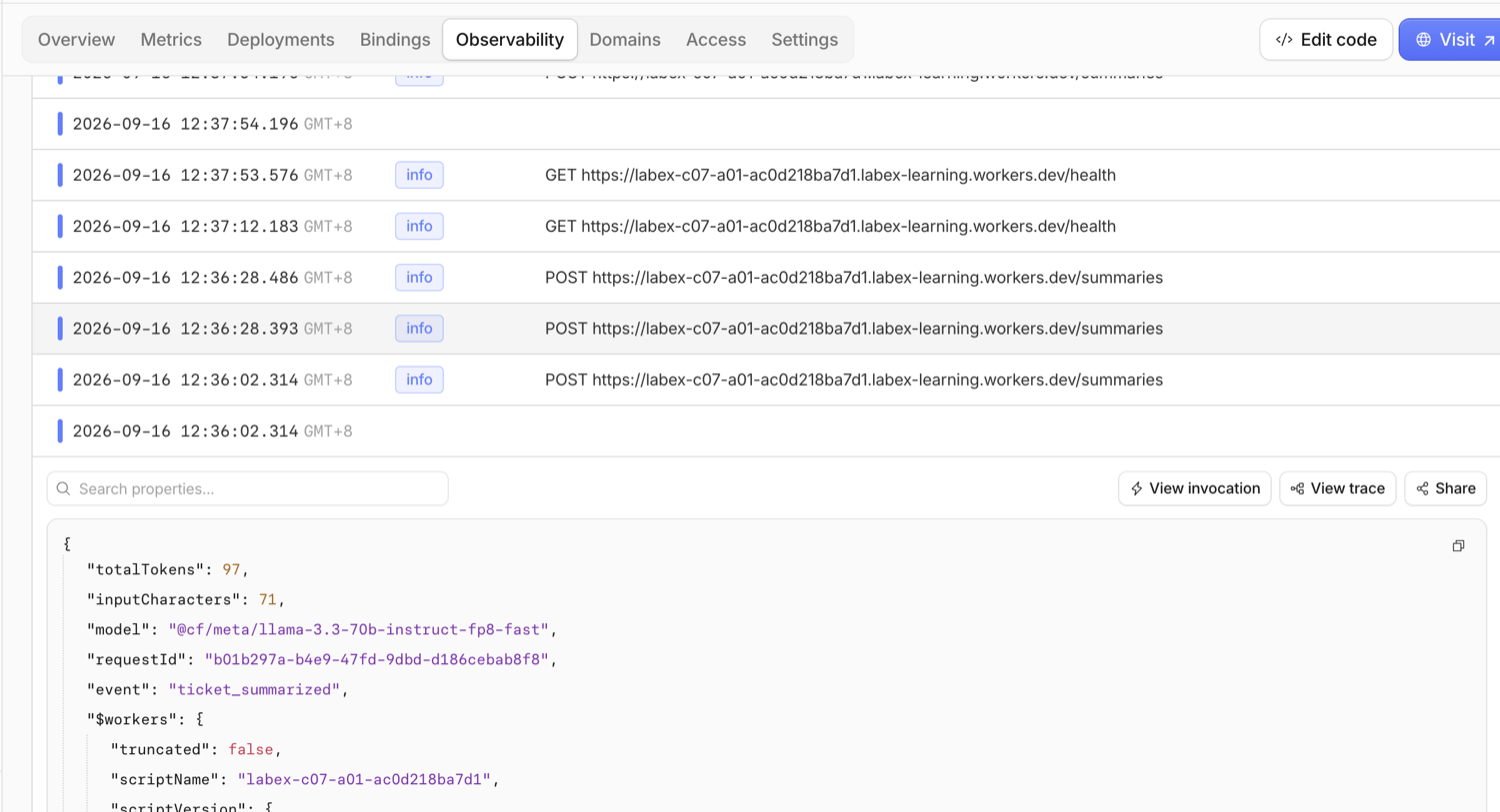
Обратите внимание: журнал содержит рабочие сведения, такие как модель, количество токенов и идентификатор запроса, но не содержит тему или детали заявки поддержки. Это граница конфиденциальности, созданная написанным вами кодом журналирования.
Наконец, откройте Workers AI в навигации Developer Platform и проверьте представление использования. Найдите недавнюю активность модели или использование Neuron, связанное с этим ограниченным тестом. Данные об использовании могут появиться позже запроса; пустой график сразу после выполнения ничего не доказывает, и не следует «исправлять» это повторными вызовами инференса.
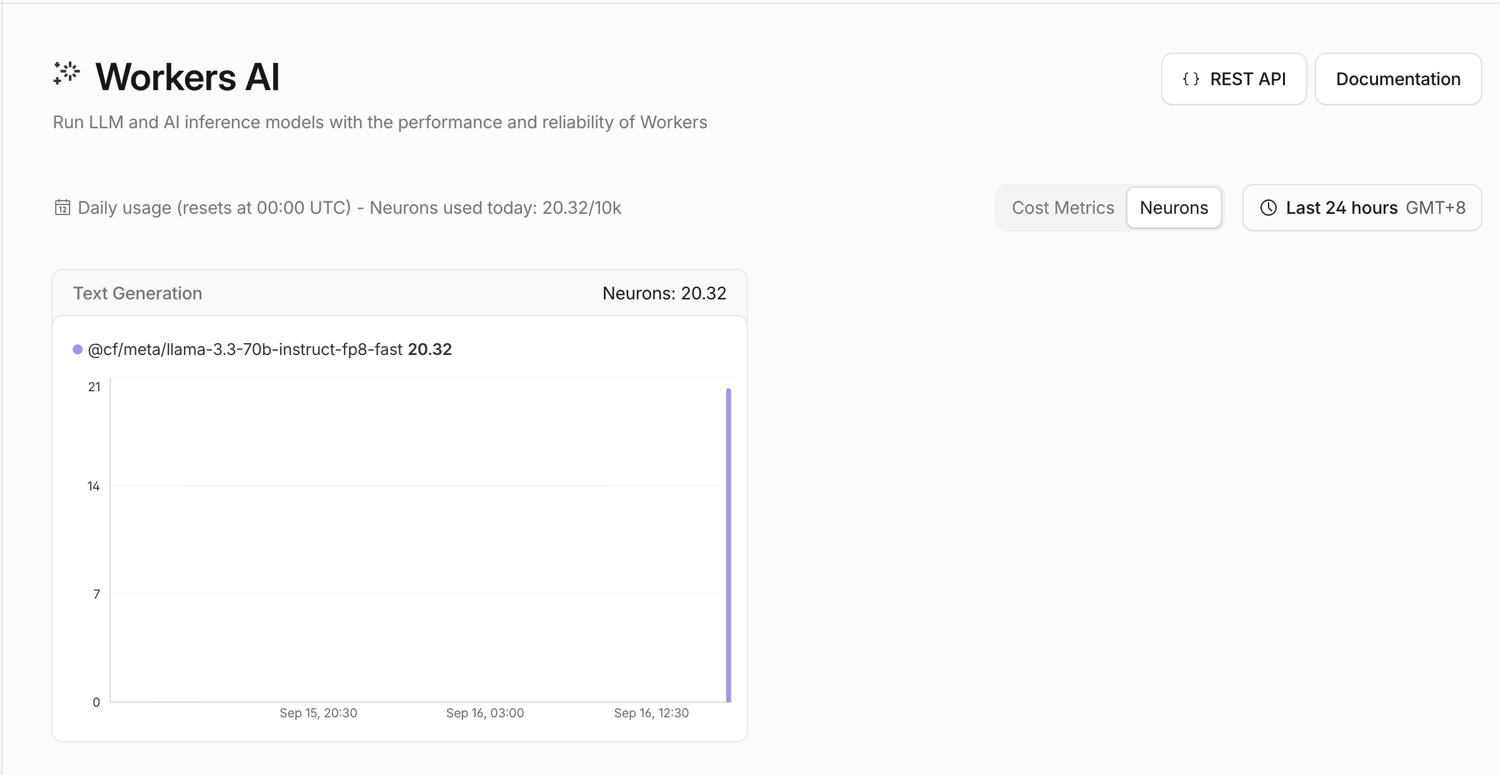
Здесь 20.32/10k означает, что во время этого приёмочного запуска была использована лишь небольшая часть суточной бесплатной квоты аккаунта. В общую сумму входит другая активность Workers AI в вашем учебном аккаунте, поэтому она не совпадёт со снимком экрана.
Снимки экрана Dashboard в этой лабораторной работе показывают примерные значения одного приёмочного запуска с временным Worker. Имя Worker, идентификатор запроса, временные отметки, количество токенов и общие показатели использования у вас будут другими.
Удаление Worker и выход из аккаунта
На этом шаге вы удалите временное облачное приложение, а затем отзовёте сеанс Wrangler на этой виртуальной машине. Удаление Worker отключает его общедоступную конечную точку. Оно не изменяет ваш план Workers и не удаляет записи об использовании на уровне аккаунта.
Удалите Worker, указанный в wrangler.jsonc:
npx wrangler delete
Подтвердите удаление, когда Wrangler покажет уникальное имя этой лабораторной работы. Не удаляйте никакие другие приложения. В Dashboard вернитесь в Workers & Pages → Overview и убедитесь, что Worker с точным именем labex-c07-a01-... отсутствует. Исторические журналы и данные об использовании могут сохраниться после удаления скрипта.
Перед завершением Wrangler проверяет, не зависит ли другой Worker от этого Worker. Поэтому при входе ранее требовался доступ к очистке KV, хотя приложение не использовало KV; успешное удаление должно вернуть вас к приглашению командной строки без ошибки авторизации.
Выполните проверку удаления, пока виртуальная машина всё ещё авторизована:
python3 .labex/verify.py deleted
Только после сообщения PASS: deleted удалите сохранённые данные авторизации:
npx wrangler logout
npx wrangler whoami --json
В итоговом выводе должно быть указано loggedIn: false. Ошибка сети не подтверждает выход из аккаунта.
Резюме
Вы подключили Worker к модели, размещённой в Cloudflare, через AI-привязку, ограничили входные и генерируемые данные, проверили детерминированное поведение до расходования ресурсов модели, выполнили реальный инференс локально и после развёртывания, а также связали ответ с данными Dashboard о привязке, журналах и использовании. Кроме того, вы безопасно удалили временный Worker и выполнили выход из аккаунта на новой виртуальной машине.