Введение
Когда AI-модель готовит длинный ответ, ожидание всего результата может создать ощущение, что приложение зависло. Потоковая передача позволяет приложению получать небольшие фрагменты сразу после их готовности. Это похоже на чтение сообщения, пока отправитель ещё печатает: для полного ответа требуется примерно столько же работы, но полезный текст появляется раньше.
В этой лабораторной работе используется Server-Sent Events (SSE) — текстовый формат для отправки последовательности событий в рамках одного HTTP-ответа. Каждое событие Workers AI начинается с data:. Текстовые события содержат часть сгенерированного ответа, а финальное событие data: [DONE] сообщает, что поток завершился нормально. Пауза между событиями означает только то, что модель продолжает работу. Без сигнала завершения приложение не может отличить медленный ответ от соединения, которое уже никогда не завершится.
Вы создадите обработчик POST /help, передадите ответ Llama, размещённой в Cloudflare, указанному клиенту командной строки и проверите два варианта завершения: нормальное завершение и намеренную отмену после первого полезного фрагмента. Отмена означает, что клиенту больше не нужен оставшийся ответ и он закрывает операцию, вместо того чтобы оставлять неиспользуемое соединение открытым. Вы также примените детерминированные тесты, чтобы доказать, что ошибка запуска модели превращается в ограниченную по времени ошибку, а прерванный поток завершается, а не зависает.
Это вторая лабораторная работа курса. Предполагается, что вы знаете: Cloudflare Worker — это код приложения, выполняющийся в сети Cloudflare, а привязка AI предоставляет Workers AI через env.AI. Если вы перешли к курсу напрямую, сначала выполните лабораторную работу Подключение LabEx к вашей учётной записи Cloudflare, чтобы научиться пользоваться терминалом виртуальной машины, авторизовать Wrangler, проверять учебную учётную запись и сохранять её идентификатор.
В лабораторной работе используется @cf/meta/llama-3.3-70b-instruct-fp8-fast и небольшие синтетические вопросы. Бесплатные учётные записи Workers сейчас получают общую дневную квоту в размере 10 000 Neurons. Локальный запуск также обращается к Cloudflare и расходует эту квоту. Если квота исчерпана или модели не хватает мощности, остановитесь и не отправляйте повторные запросы; приложение должно сообщить о терминальной ошибке, а не зависнуть.
Настройка устанавливает Node.js 22.22.0 и локальный Wrangler 4.132.0 в /home/labex/project/help-stream. Она предоставляет SSE-клиент, детерминированные фикстуры и независимые проверки. Настройка не выполняет вход, не запускает модель, не развёртывает Worker и не создаёт облачные ресурсы. Не закрывайте эту виртуальную машину, пока не удалите временный Worker и не проверите выход из учётной записи.
Авторизация виртуальной машины и настройка потокового Worker
На этом шаге вы авторизуете новую виртуальную машину и настроите временный потоковый Worker. Выполненный вход в Dashboard не предоставляет терминальным командам разрешение на управление учебной учётной записью автоматически.
Перейдите в подготовленный проект и проверьте закреплённую версию Wrangler:
cd /home/labex/project/help-stream
npx wrangler --version
Ожидается 4.132.0. Запросите только необходимые здесь разрешения. Разрешение Workers Scripts на запись позволяет управлять временным Worker, разрешение Workers AI на запись позволяет его привязке вызывать модель, а две области чтения помогают определить выбранную учётную запись. Wrangler 4.132.0 также проверяет зависимости привязок KV при удалении Worker, поэтому узкая область KV на запись позволяет команде очистки завершиться, хотя в этой лабораторной работе данные KV не создаются.
npx wrangler login --device --browser=false --scopes account:read user:read workers_scripts:write workers_kv:write ai:write
Откройте показанную ссылку, введите текущий код устройства, проверьте учётную запись и разрешения и авторизуйте учебную учётную запись. Также может появиться Background Access, поскольку Wrangler продолжает работу после закрытия браузера. Вернитесь в терминал и дождитесь сообщения об успешном завершении, затем проверьте структурированные данные удостоверения:
npx wrangler whoami --json
Убедитесь, что указано loggedIn: true, и прочитайте name и id нужной учётной записи. Сгенерируйте уникальное имя временного Worker:
RUN="labex-c07-a02-$(openssl rand -hex 6)"
printf '%s\n' "$RUN"
Замените YOUR_ACCOUNT_ID ниже фактическим идентификатором этой учётной записи:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["enable_request_signal"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": {
    "enabled": true,
    "head_sampling_rate": 1
  },
  "ai": {
    "binding": "AI",
    "remote": true
  }
}
JSON
Привязка AI станет доступна через env.AI. Параметр remote: true означает, что при локальной разработке по-прежнему используется настоящая облачная модель. enable_request_signal позволяет request.signal сообщать об отключении клиента, чтобы Worker мог записать сигнал отмены и обработать его. Observability сохраняет события жизненного цикла, которые вы изучите позже. Worker ещё не развёрнут, и вывод модели ещё не запускался.
Проверка привязки AI и SSE-клиента
На этом шаге вы подключите привязку AI к предоставленному SSE-клиенту, прежде чем писать Worker. Модель является источником данных, Worker передаёт байты, а client.mjs — получатель. Разделение этих ролей помогает понять, какой компонент должен завершить операцию.
Сгенерируйте типы окружения Worker:
npx wrangler types
grep -A4 'interface __BaseEnv_Env' worker-configuration.d.ts
Найдите AI: Ai. Это означает, что настроенная привязка будет доступна обработчику как env.AI; это не API-ключ, сохранённый в исходном коде.
Теперь проверьте варианты завершения, которые выводит предоставленный клиент:
grep -nE 'chunk:|complete chunks=|cancelled after|stream_error:' client.mjs
Клиент читает ответ по частям. Строка chunk: показывает недавно сгенерированный текст. complete появляется только после data: [DONE]. В режиме отмены клиент закрывает reader после первого непустого фрагмента. stream_error означает терминальную ошибку, включая тайм-аут в 45 секунд; тайм-аут — это защитная граница, а не прогноз того, что каждый ответ модели должен занимать столько времени.
SSE-событие представляет собой обычный текст, отделённый пустой строкой. Типичный успешный поток выглядит так:
data: {"response":"First piece"}

data: {"response":" and another piece."}

data: [DONE]
Границы фрагментов — это детали передачи: одно событие может содержать слово, знак пунктуации или более длинный фрагмент. Логика приложения должна объединять строки response и ожидать [DONE], а не предполагать фиксированное количество или размер фрагментов.
Создание потокового обработчика с мониторингом
На этом шаге вы создадите потоковый обработчик и мониторинг его жизненного цикла. Worker запросит у модели поток с параметром stream: true, а затем предоставит клиенту тот же протокол SSE. Он не будет сначала собирать весь ответ в памяти. Небольшая обёртка отслеживает жизненный цикл потока: при завершении закрывает его штатно, при отмене отменяет чтение из внешнего потока, а при ошибке потока завершает ответ.
Создайте точку входа Worker:
cat > src/index.js <<'JS'
const MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const MAX_QUESTION = 800;

function json(data, status = 200) {
  return Response.json(data, { status });
}

async function readQuestion(request) {
  const contentType = request.headers.get("content-type") || "";
  if (!contentType.toLowerCase().includes("application/json")) {
    return { error: json({ error: "json_required" }, 415) };
  }

  const raw = await request.text();
  if (raw.length > 2048) {
    return { error: json({ error: "question_too_large" }, 413) };
  }

  let body;
  try {
    body = JSON.parse(raw);
  } catch {
    return { error: json({ error: "invalid_json" }, 400) };
  }

  const question = typeof body?.question === "string" ? body.question.trim() : "";
  if (!question) {
    return { error: json({ error: "invalid_question" }, 400) };
  }
  if (question.length > MAX_QUESTION) {
    return { error: json({ error: "question_too_large" }, 413) };
  }
  return { question };
}

function monitor(upstream, details) {
  const reader = upstream.getReader();
  let terminal = false;

  return new ReadableStream({
    async pull(controller) {
      try {
        const { done, value } = await reader.read();
        if (done) {
          terminal = true;
          console.log(JSON.stringify({ event: "help_stream_completed", ...details }));
          controller.close();
          return;
        }
        controller.enqueue(value);
      } catch {
        terminal = true;
        console.error(JSON.stringify({ event: "help_stream_failed", ...details }));
        controller.error(new Error("model stream interrupted"));
      }
    },
    async cancel(reason) {
      if (!terminal) {
        terminal = true;
        console.log(JSON.stringify({ event: "help_stream_cancelled", ...details }));
      }
      await reader.cancel(reason);
    }
  });
}

async function streamHelp(request, env) {
  const parsed = await readQuestion(request);
  if (parsed.error) return parsed.error;

  const requestId = crypto.randomUUID();
  const details = { requestId, model: MODEL };
  request.signal.addEventListener("abort", () => {
    console.log(JSON.stringify({ event: "help_client_disconnected", ...details }));
  }, { once: true });

  try {
    const upstream = await env.AI.run(MODEL, {
      messages: [
        {
          role: "system",
          content: "Answer the support question in at most four short sentences. Give safe, practical steps and do not invent account details."
        },
        { role: "user", content: parsed.question }
      ],
      stream: true,
      max_tokens: 160,
      temperature: 0.2
    });

    if (!(upstream instanceof ReadableStream)) {
      throw new Error("stream unavailable");
    }

    console.log(JSON.stringify({ event: "help_stream_started", ...details }));
    return new Response(monitor(upstream, details), {
      headers: {
        "content-type": "text/event-stream; charset=utf-8",
        "cache-control": "no-store",
        "x-request-id": requestId
      }
    });
  } catch {
    console.error(JSON.stringify({ event: "help_stream_start_failed", ...details }));
    return json({ error: "model_unavailable", requestId }, 502);
  }
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "GET" && url.pathname === "/health") {
      return json({ status: "ok" });
    }
    if (request.method === "POST" && url.pathname === "/help") {
      return streamHelp(request, env);
    }
    return json({ error: "not_found" }, 404);
  }
};
JS
Код записывает идентификаторы запросов и события жизненного цикла, но никогда не записывает вопрос или сгенерированный ответ. Идентификатор запроса связывает один ответ клиенту с одной записью журнала, не копируя содержимое обращения в данные observability. Ответ с ошибкой также скрывает внутренние сведения о поставщике; операторы могут использовать журнал жизненного цикла, а клиенты получают стабильный контракт model_unavailable.
Запустите детерминированные тесты. Их поддельная привязка AI выдаёт контролируемые события, завершается с ошибкой до начала потоковой передачи, поддерживает отмену и прерывает один поток, не расходуя Neurons:
node --test test/worker.test.mjs
Ожидается шесть успешно пройденных тестов. Затем соберите настоящий Worker, не развёртывая его:
npx wrangler deploy --dry-run
Тесты подтверждают поведение приложения при контролируемом времени выполнения. Пробный запуск подтверждает, что исходный код и конфигурация собираются вместе. Ни один из этих шагов не доказывает, что облачная модель сейчас доступна; на следующем шаге вы выполните один настоящий потоковый запрос.
Наблюдение за настоящим локальным потоком
На этом шаге вы посмотрите один настоящий поток через процесс Worker, запущенный на виртуальной машине. Слово «локальный» относится к обработчику запроса; вывод модели по-прежнему выполняется в выбранной учётной записи и расходует её дневную квоту.
Запустите Wrangler в фоновом режиме и сохраните идентификатор процесса:
npx wrangler dev --port 8787 > .labex/dev.log 2>&1 &
echo $! > .labex/dev.pid
Дождитесь ответа маршрута проверки, не использующего AI:
for attempt in $(seq 1 30); do
  if curl --silent --fail http://127.0.0.1:8787/health; then
    break
  fi
  sleep 1
done
Теперь воспользуйтесь предоставленным клиентом и отправьте небольшой синтетический вопрос:
node client.mjs http://127.0.0.1:8787 \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
Вы должны увидеть одну или несколько строк chunk:, а затем завершающую строку, похожую на:
complete chunks=18 chars=238
Текст, количество фрагментов и количество символов у вас будут отличаться. Важный признак — непустой контент, поступающий постепенно, а затем [DONE], который клиент преобразует в complete. Если вы видите stream_error, проверьте .labex/dev.log. Ошибка квоты, авторизации или доступности — это неудачный запуск модели, а не причина ждать бесконечно.
Наконец, убедитесь, что проверка приложения выполняется до обращения к модели:
curl --silent --show-error --write-out '\nHTTP %{http_code}\n' \
  http://127.0.0.1:8787/help \
  --header 'Content-Type: application/json' \
  --data '{"question":""}'
Ожидайте {"error":"invalid_question"} и HTTP-код 400. Потоковая передача полезна только после того, как обычный запрос прошёл свои проверки.
Развёртывание, завершение и отмена потока
На этом шаге вы развернёте Worker, завершите один поток и отмените другой после его первого полезного фрагмента. Сначала остановите только сохранённый процесс разработки и дождитесь его завершения:
kill "$(cat .labex/dev.pid)"
wait "$(cat .labex/dev.pid)" 2>/dev/null || true
Разверните тот же код Worker:
npx wrangler deploy
Сохраните точный URL workers.dev, который напечатает Wrangler:
WORKER_URL="https://YOUR_WORKER_URL"
Сначала проверьте нормальное завершение:
node client.mjs "$WORKER_URL" \
  "How can I safely retry an invoice upload without creating a duplicate ticket?"
Финальная строка complete означает, что модель отправила [DONE]; одно только получение первого фрагмента не доказывает завершение ответа.
Теперь запустите второй поток и намеренно остановите его после первого непустого фрагмента:
node client.mjs "$WORKER_URL" \
  "Explain four checks to make before retrying a failed file upload." \
  --cancel-after-first
Ожидайте одну строку chunk:, за которой последует cancelled after 1 chunk. Отмена — это не ошибка модели: клиент намеренно решил, что остальная часть ему больше не нужна. Закрытие reader передаёт отмену внешнему потоку, а сигнал входящего запроса позволяет Worker записать отключение клиента.
Откройте Cloudflare Dashboard и перейдите в Workers & Pages → Overview → ваш Worker labex-c07-a02-... → Observability → Logs. Найдите последние запросы. Пример ниже взят из одного временного приёмочного запуска: 14 Success и 0 Errors показывают, что Worker обработал проверки состояния, завершённые потоки и намеренные отключения без неудачного вызова. Ваши значения и временные метки будут отличаться.
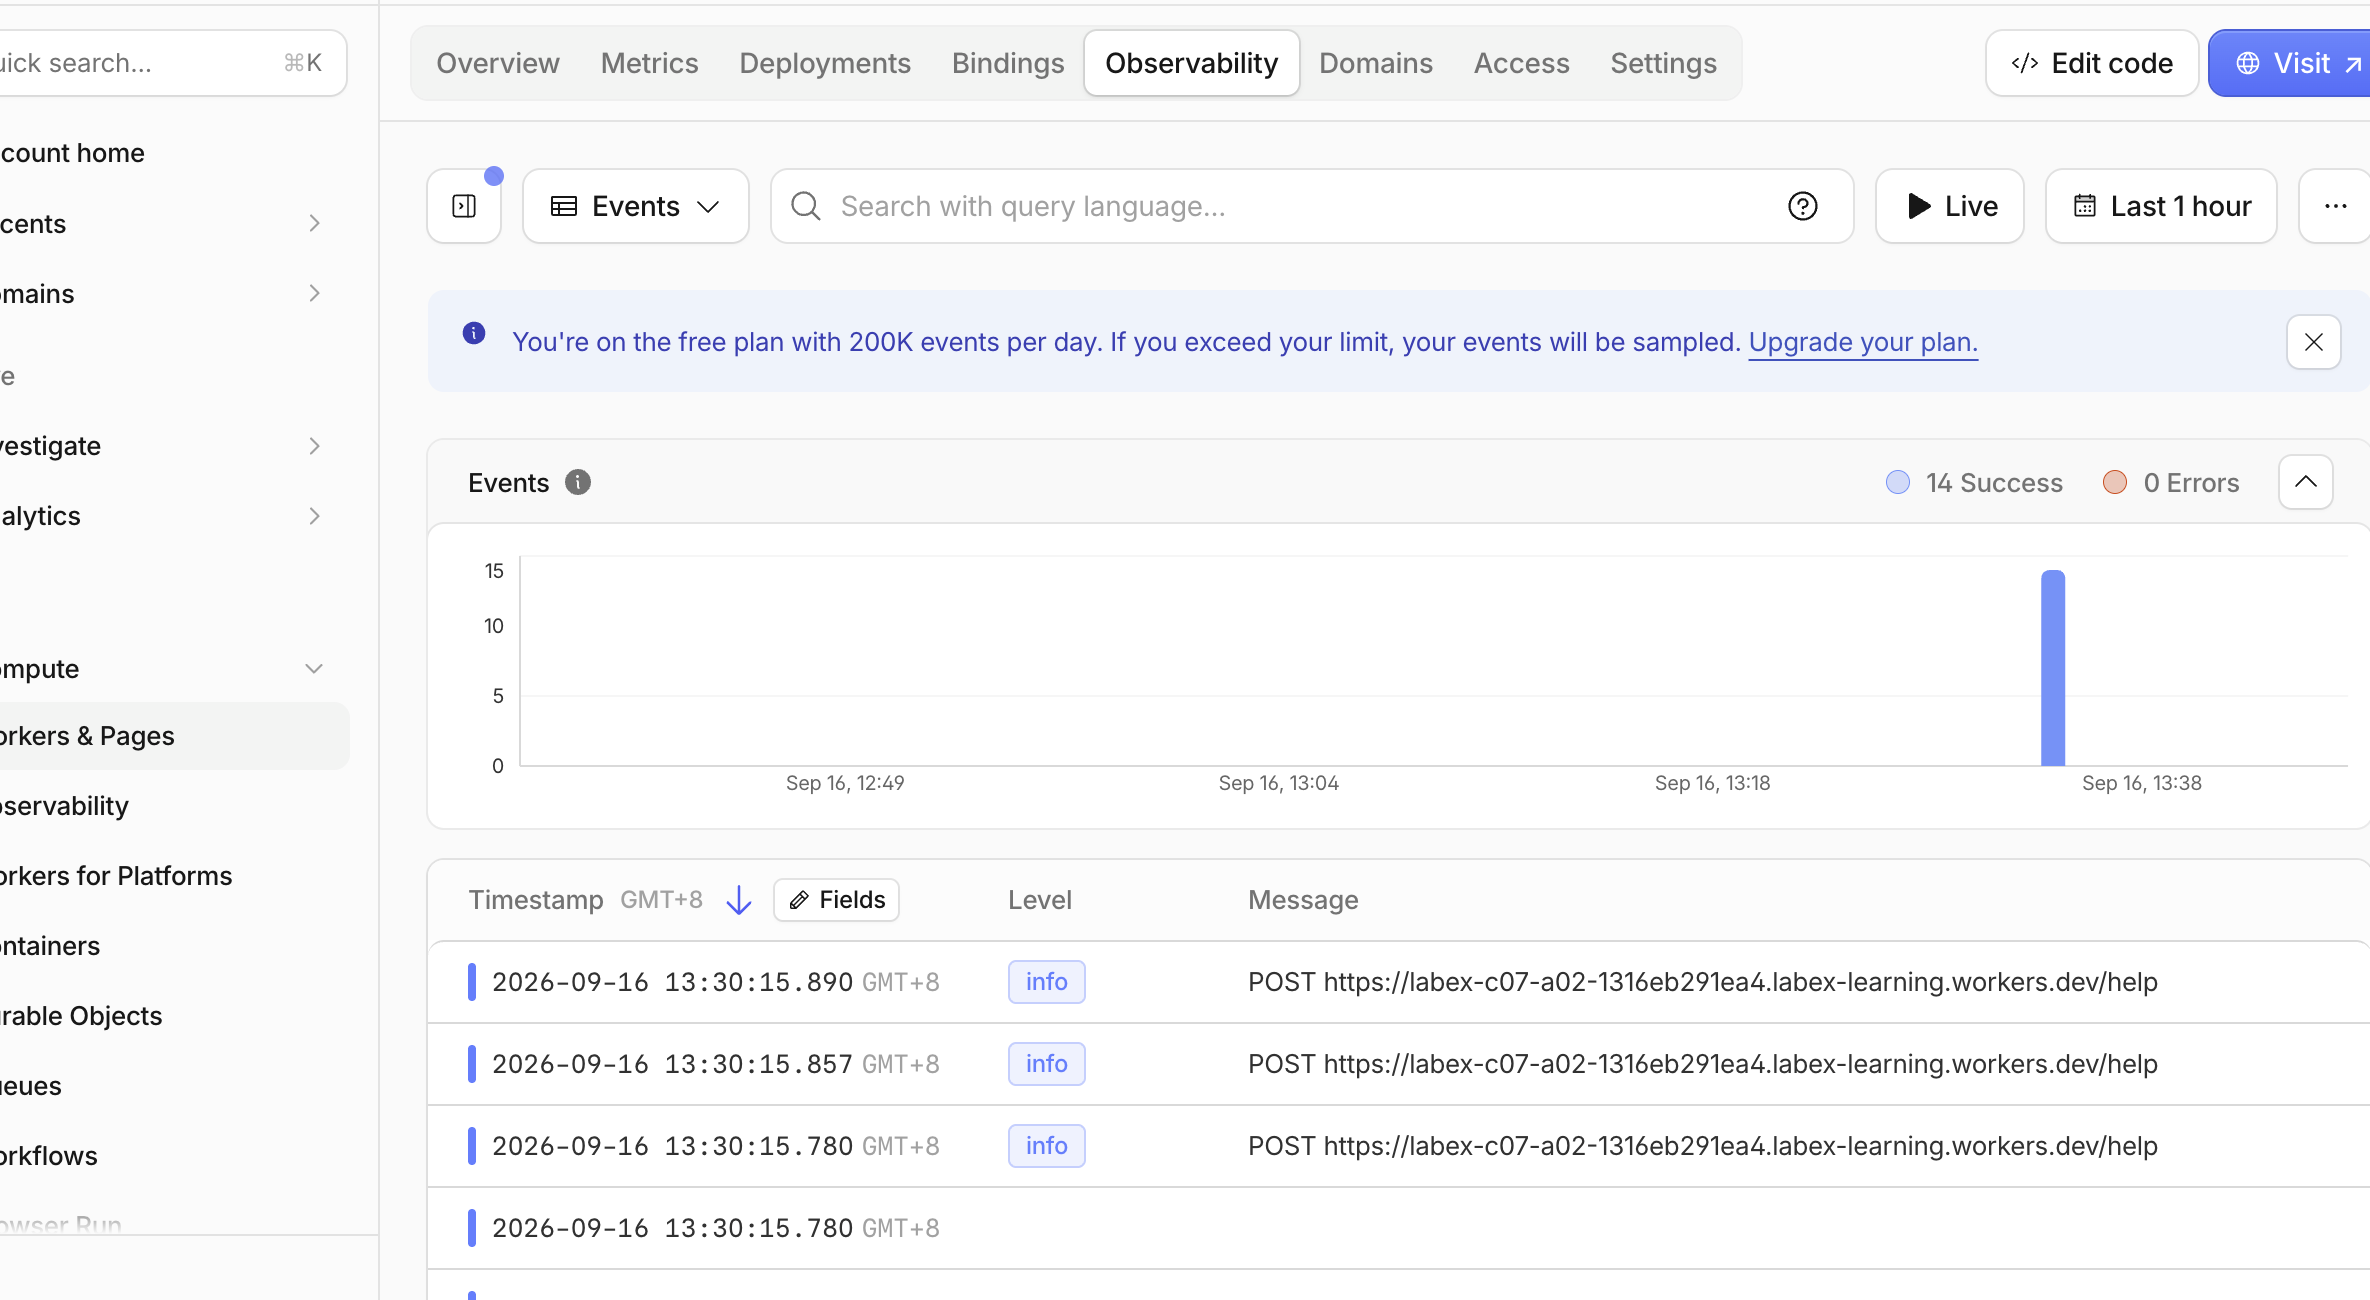
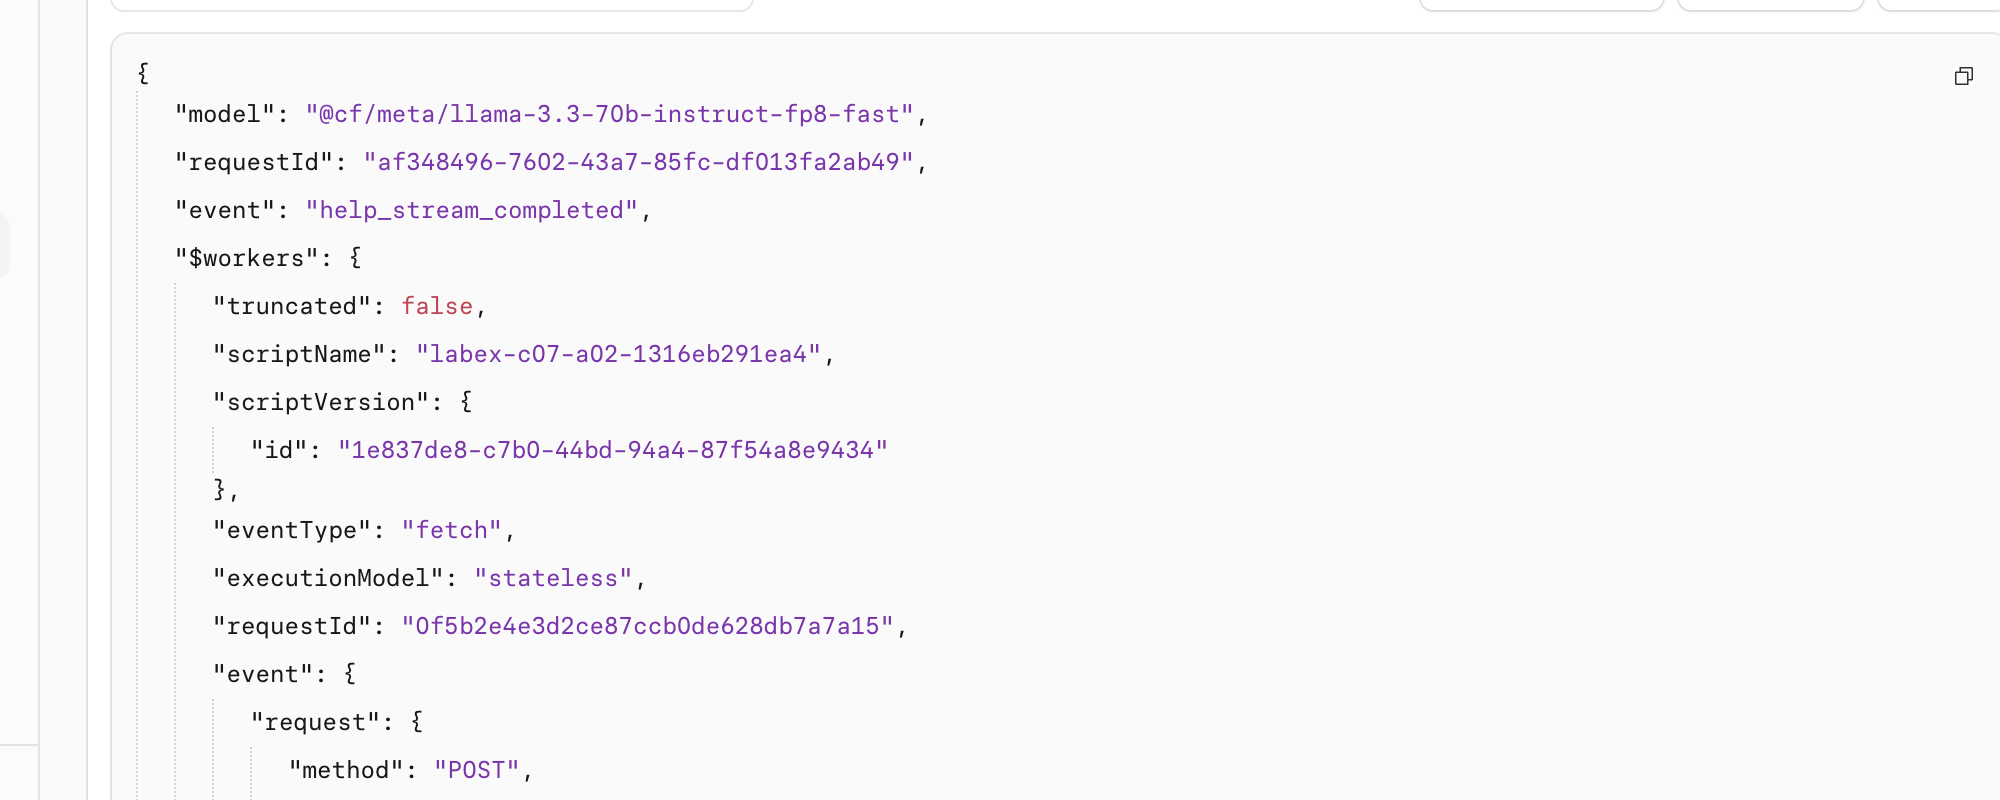
Найдите help_stream_completed, раскройте одну запись и проверьте её model, requestId и event. Идентификатор запроса — безопасное значение для сопоставления: он помогает оператору связать записи жизненного цикла, не сохраняя вопрос учащегося или сгенерированный ответ.
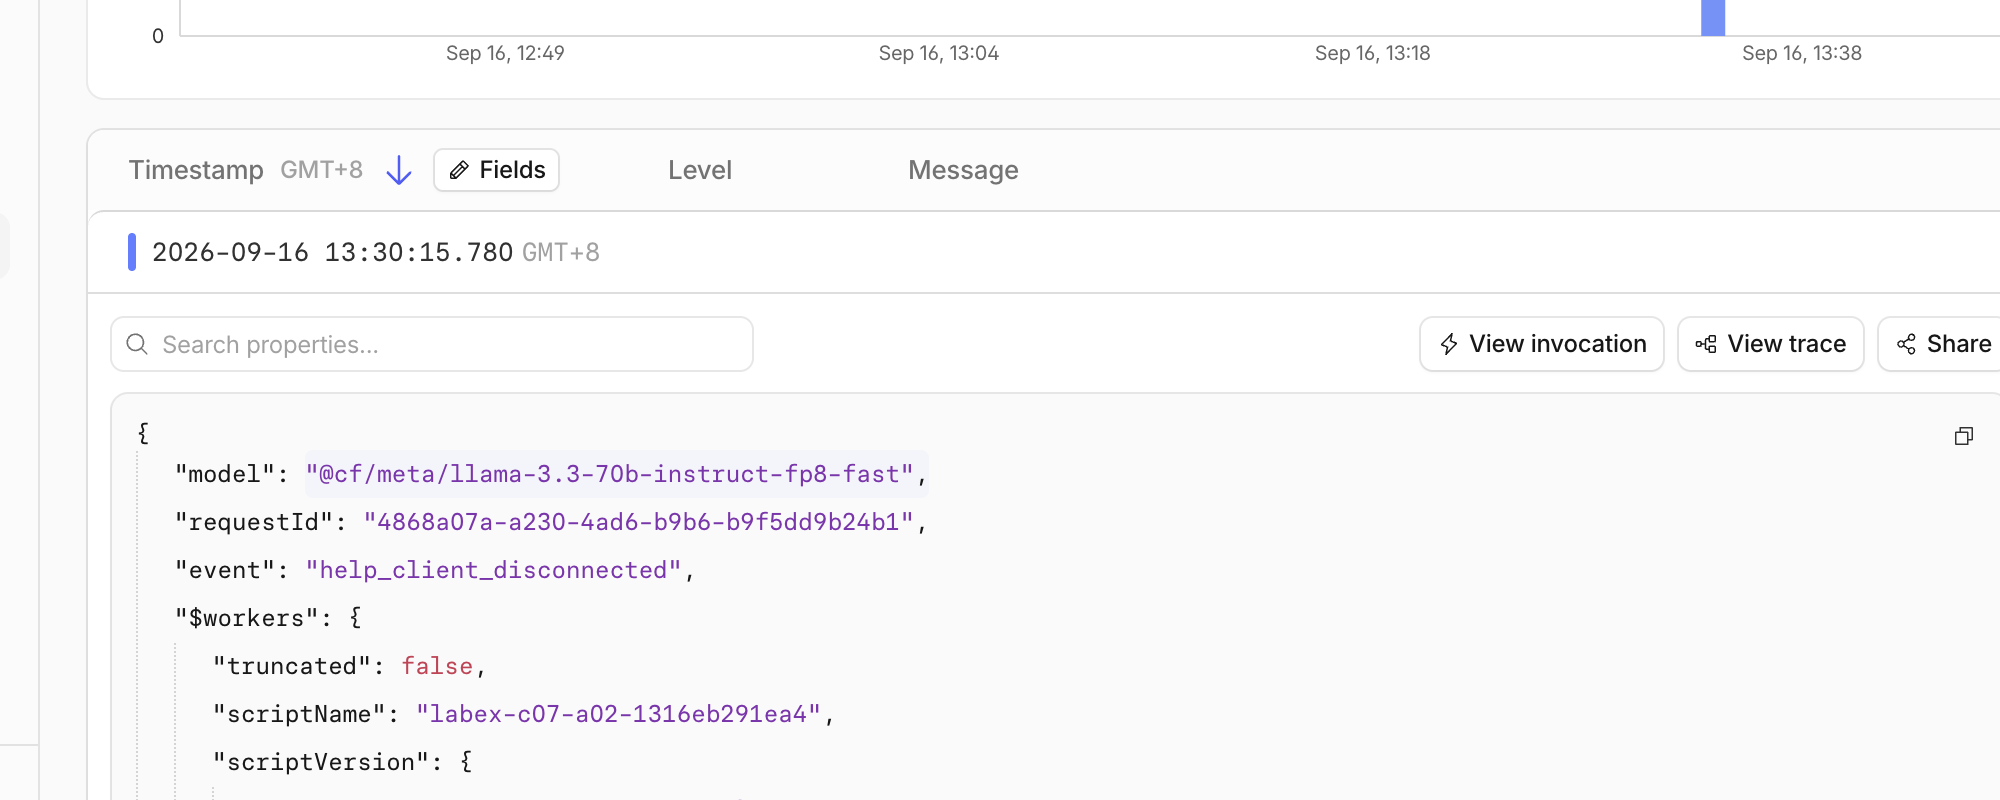
Для намеренно отменённого публичного запроса найдите help_client_disconnected. При включённом enable_request_signal это прямое доказательство того, что входящий клиент отключился. Детерминированный тест из шага 4 отдельно подтверждает, что последующий вызов cancel() достигает фикстуры модели и записывает help_stream_cancelled; при реальном сетевом взаимодействии в облачной записи может быть виден только сигнал запроса. Сохранённые журналы могут появиться позже ответа, поэтому немного подождите и при необходимости выполните не более одного дополнительного ограниченного по времени запроса с отменой.
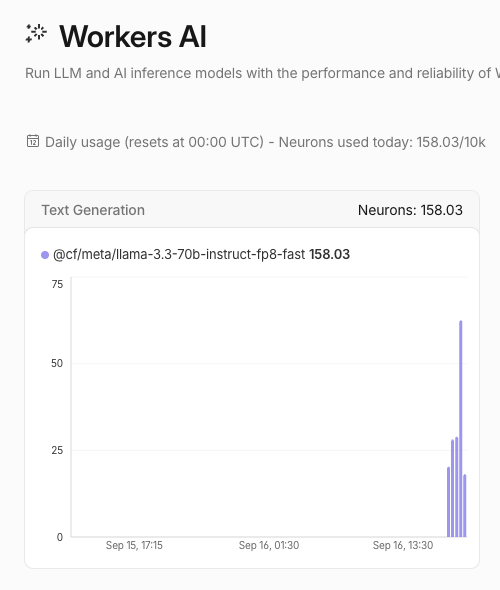
Затем откройте Workers AI и проверьте сегодняшнее использование модели. Найдите модель Llama 3.3 и убедитесь, что небольшие упражнения укладываются в бесплатную квоту 10 000 Neurons. В примере ниже вся работа в учебной учётной записи использовала 158.03/10k Neurons; сюда входят и другие упражнения в этой учётной записи, поэтому ваше значение будет отличаться. Тариф Workers Paid для этой лабораторной работы не требуется, пока учётная запись остаётся в пределах бесплатной квоты. Данные об использовании могут появляться с задержкой, поэтому не повторяйте вывод модели только для обновления графика.
Имя Worker, идентификаторы запросов, временные метки и данные об использовании на этих снимках экрана — примеры временного запуска. Цель обучения — названия событий и связь между этапами жизненного цикла, а не точные значения.
Удаление Worker и выход из учётной записи
На этом шаге вы удалите временный Worker, а затем выполните выход с этой виртуальной машины. Данные об использовании Workers AI хранятся на уровне учётной записи, поэтому удаление Worker убирает его публичную конечную точку, но не удаляет исторические записи и не изменяет тарифный план учётной записи.
Удалите Worker с точным именем из wrangler.jsonc:
npx wrangler delete
Подтверждайте удаление только после того, как Wrangler покажет уникальное имя этой лабораторной работы labex-c07-a02-.... Команда должна завершиться сообщением Successfully deleted. В Dashboard обновите страницу Workers & Pages → Overview и убедитесь, что это имя отсутствует.
Пока виртуальная машина ещё авторизована, выполните независимую проверку управления:
python3 .labex/verify.py deleted
Только после сообщения PASS: deleted удалите сохранённые данные авторизации этой виртуальной машины:
npx wrangler logout
npx wrangler whoami --json
Убедитесь, что указано loggedIn: false. Отсутствие локального файла, закрытая вкладка браузера или ошибка сети не доказывают ни удаление ресурса в облаке, ни выход из учётной записи.
Резюме
Вы создали конечную точку Workers AI, которая передаёт потоковый SSE-вывод по частям, вместо того чтобы буферизовать полный ответ. Вы узнали, зачем клиенту нужен явный сигнал [DONE], как тайм-аут предотвращает бесконечное ожидание, чем намеренная отмена отличается от ошибки и как корректно завершать ошибки потока. Вы проверили настоящий локальный и развёрнутый вывод модели, связали события жизненного цикла с observability в Dashboard, удалили временный Worker и выполнили выход с новой виртуальной машины.