Введение
В V03 вы преобразовали вопрос в embedding и получили близкие по смыслу статьи справки. Однако настоящая система поддержки обычно обслуживает нескольких клиентов, поэтому одна только семантическая близость никогда не должна определять, документы какого клиента может увидеть пользователь.
В этой лабораторной работе добавляются две границы поиска. Пространство имён Vectorize — это раздел внутри одного индекса. Поиск в одном пространстве имён исключает векторы из всех остальных пространств ещё до начала ранжирования по сходству. Затем фильтр метаданных дополнительно ограничивает раздел клиента по такому полю, как category. Пространство имён можно представить как выбор нужного картотечного шкафа, а фильтр категории — как выбор одного ящика внутри него.
Ни один из этих механизмов не выполняет аутентификацию пользователя. Сначала приложение должно проверить вход, токен или другой признак личности, а затем определить пространство имён на сервере. Чтобы упражнение оставалось безопасным и воспроизводимым, этот Worker использует две общедоступные синтетические метки сессий, представляющие уже проверенные сессии. Это учебные фикстуры, а не настоящие учётные данные и не полноценная система аутентификации. Запрос никогда не может самостоятельно выбрать клиента или пространство имён.
Вы развернёте один временный Worker с привязками Workers AI и Vectorize. Четыре синтетические статьи специально содержат одинаковый текст о пароле в пространствах имён двух клиентов. Живые embeddings делают поиск реалистичным, а точные проверки пространства имён, категории и идентификаторов подтверждают изоляцию, не оценивая точные значения, возвращённые моделью. Вы также проверите разрешённый пустой результат и отклоните попытку переопределить область поиска до обращения к любому из облачных сервисов.
Если вы открыли этот курс напрямую, сначала выполните лабораторную работу Подключение LabEx к вашей учётной записи Cloudflare. Лабораторные работы V01–V03 также обязательны: в них рассматриваются совместимые индексы, асинхронные мутации и семантический поиск.
Небольшой индекс и ограниченные запросы к BGE Small соответствуют документированным квотам Workers Free; Workers Paid не требуется. Локальные и развёрнутые вызовы моделей всё равно расходуют общую суточную квоту Workers AI вашей учётной записи, поэтому при недоступности квоты прекратите работу, а не повторяйте попытки.
В рамках настройки устанавливаются Node.js 22.22.0 и локальный Wrangler 4.132.0 в /home/labex/project/scoped-vector-search. Настройка предоставляет детерминированные тесты и независимые проверки только для чтения, но не авторизует Wrangler, не создаёт индекс, не разворачивает Worker, не запускает inference и не загружает данные в облако.
Авторизуйте доступ и назовите ресурсы поиска
На этом шаге вы авторизуете новую виртуальную машину и опишете один Worker вместе с соответствующим индексом Vectorize в обычной конфигурации Wrangler.
Перейдите в подготовленный проект и проверьте зафиксированную версию CLI:
cd /home/labex/project/scoped-vector-search
npx wrangler --version
Ожидается 4.132.0. Авторизация устройства позволяет виртуальной машине получить временное разрешение OAuth, не передавая ей пароль Cloudflare. Запрошенные области доступа охватывают сведения об учётной записи, временный индекс, развёртывание Worker и привязку Workers AI, используемую для создания embeddings:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Откройте показанную ссылку в браузере, введите текущий код и подтвердите нужную учебную учётную запись. Вернувшись в терминал, убедитесь, что отображаются loggedIn: true, authType: OAuth Token и имя учётной записи, прежде чем копировать её идентификатор.
Создайте один случайный суффикс, а затем получите имя индекса из имени Worker. Такой способ именования упростит последующую точечную очистку:
RUN="labex-c08-v04-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Замените YOUR_ACCOUNT_ID идентификатором, показанным командой whoami. Привязка предоставляет коду Worker локальное имя для сервиса Cloudflare: AI будет создавать embeddings, а DOCUMENTS — обращаться именно к индексу, указанному в index_name.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
Файл задаёт имена нужных ресурсов, но пока ничего не создаёт. Особенно важно явно указать идентификатор и владельца до выполнения операций записи в общей учебной учётной записи.
Создайте Worker с областью поиска, заданной сервером
На этом шаге вы реализуете границу поиска до развёртывания Worker.
Заголовок x-lab-session использует только две общедоступные метки, чтобы имитировать результат предыдущего уровня аутентификации. Функция resolveSession сопоставляет проверенный контекст с пространством имён на сервере. Тело запроса может задать запрос и разрешённую категорию, но не может указать клиента или пространство имён. В рабочем приложении замените эти метки корректно проверенной сессией или поставщиком удостоверений; пространство имён организует данные, но не выполняет аутентификацию.
Четыре документа содержат одинаковый текст о пароле для клиентов blue и green. Благодаря этому результат защиты легко увидеть: сходство не может различить копии, поэтому разделить их может только область поиска, управляемая сервером.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);
const SESSION_CONTEXTS = Object.freeze({
  "blue-session": Object.freeze({ customer: "blue", namespace: "customer-blue" }),
  "green-session": Object.freeze({ customer: "green", namespace: "customer-green" })
});

const DOCUMENTS = [
  {
    id: "blue-password",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "blue-invoice",
    namespace: "customer-blue",
    category: "billing",
    title: "Download an invoice",
    text: "Download an invoice or receipt for a completed payment."
  },
  {
    id: "green-password",
    namespace: "customer-green",
    category: "account",
    title: "Reset a password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "green-upload",
    namespace: "customer-green",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function resolveSession(label) {
  const context = SESSION_CONTEXTS[label];
  if (!context) throw new Error("session_invalid");
  return context;
}

export function parseSearchInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const query = typeof value.query === "string" ? value.query.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!query || query.length > 200) throw new Error("query_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { query, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    namespace: document.namespace,
    values: vectors[index],
    metadata: {
      category: document.category,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "scoped_documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let context;
  try {
    context = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch (error) {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 3,
    namespace: context.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });
  const matches = result.matches.map((match) => ({
    id: match.id,
    score: match.score,
    namespace: match.namespace,
    title: match.metadata?.title,
    category: match.metadata?.category
  }));
  console.log(JSON.stringify({
    event: "scoped_search",
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    returnedCount: matches.length
  }));
  return json({
    customer: context.customer,
    namespace: context.namespace,
    category: input.category,
    candidateCount: result.matches.length,
    matches
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Запустите детерминированные тесты. Их привязки в памяти подтверждают, что Worker создаёт обе границы запроса на основе серверного контекста, не расходуя облачную квоту:
node --test test/worker.test.mjs
Ожидается шесть успешно выполненных тестов. Сгенерируйте типы привязок из реальной конфигурации, а затем выполните сборку без развёртывания:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v04-dry-run
В сгенерированном файле должны присутствовать AI: Ai и DOCUMENTS: VectorizeIndex. Пробный запуск подтверждает, что исходный код и конфигурация собираются вместе; он не создаёт и не проверяет ни один облачный ресурс.
Создайте индекс с фильтрацией и разверните Worker
На этом шаге вы создадите совместимый индекс, подготовите поле category для фильтрации и развернёте Worker только после завершения этой подготовки.
Вектор может хранить метаданные, но это не делает их доступными для поиска. Индекс метаданных сообщает Vectorize, какое поле нужно организовать для запросов с предварительной фильтрацией. Он должен существовать до вставки векторов документов, иначе ранее добавленные записи не будут участвовать в фильтре по этим метаданным.
Создайте косинусный индекс размерности 384, совместимый с BGE Small. Параметр --update-config=false не позволяет Wrangler переписать уже проверенную явную привязку:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Теперь поставьте в очередь подготовку строкового поля category и сохраните идентификатор мутации:
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Принятая мутация — это поставленная в очередь работа, а не завершённая операция. Создайте один ограниченный по времени ожидатель только для чтения и повторно используйте его после загрузки данных. Он требует трёх последовательных чтений одной и той же мутации и количества векторов, чтобы кратковременно устаревший результат не стал итоговым подтверждением лабораторной работы:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
Мутация может быть обработана раньше, чем обновится отдельное представление списка. Используйте ограниченный цикл только для чтения, чтобы дождаться видимой строки category, а не считать один устаревший ответ списка ошибкой:
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Ожидается category с типом String. Наконец, разверните Worker, чья привязка DOCUMENTS указывает на подготовленный индекс:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
Индекс пока пуст. Развёртывание подключает привязки, но не создаёт embeddings документов автоматически.
Заполните два пространства имён клиентов
На этом шаге вы создадите embeddings в реальном времени и сохраните каждую запись ровно в одном пространстве имён клиента вместе с метаданными категории.
Пространство имён принадлежит самой векторной записи. Две записи о пароле специально содержат одинаковый текст, но находятся в разных разделах. category — отдельные метаданные, поэтому одна запись одновременно может принадлежать пространству имён blue и категории account.
Один раз вызовите фиксированную конечную точку заполнения. Корпус контролируется сервером, поэтому тело запроса пустое:
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " scoped vectors in mutation " + value.mutationId);
'
Ожидаются count: 4, размерность 384, pooling cls и UUID мутации. Дождитесь именно этой мутации и этого количества, а не пытайтесь угадать, сколько секунд потребуется сервису:
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 4
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'blue-password' <<<"$VECTOR_LIST" &&
     grep -q 'blue-invoice' <<<"$VECTOR_LIST" &&
     grep -q 'green-password' <<<"$VECTOR_LIST" &&
     grep -q 'green-upload' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in blue-password blue-invoice green-password green-upload; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed vector %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
В списке должны присутствовать blue-password, blue-invoice, green-password и green-upload. Идентификаторы связывают результаты поиска с исходными документами; пространство имён и категория определяют, может ли в остальном похожая запись участвовать в запросе.
Подтвердите изоляцию клиентов и категорий
На этом шаге вы зададите один и тот же семантический вопрос от имени двух клиентов, а затем проверите разрешённый пустой результат и небезопасное переопределение области поиска.
Начните с синтетической сессии blue и категории account:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/blue-account.json
В ответе должны быть customer: blue, namespace: customer-blue и только blue-password. Теперь отправьте тот же вопрос сессии green:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: green-session' \
  --data '{"query":"My password expired","category":"account"}' \
  | tee .labex/green-account.json
На этот раз подходит только green-password. Текст документов одинаков, поэтому различие вызвано пространством имён, выбранным проверенной сессией, а не моделью embeddings и не случайным значением оценки.
Затем запросите для сессии blue категорию files. Существует очень релевантная статья о загрузке файла для green, но в пространстве имён blue нет статьи о файлах:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files"}' \
  | tee .labex/blue-files-empty.json
Ожидаются candidateCount: 0 и matches: []. Пустой результат — правильный ответ для разрешённого запроса; использование релевантной записи из другого пространства имён стало бы утечкой данных.
Наконец, попробуйте переопределить пространство имён в теле запроса:
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"query":"Upload a PDF","category":"files","namespace":"customer-green"}'
cat .labex/override-response.json
Ожидаются HTTP 400 и scope_override_not_allowed. Worker отклоняет поле до создания embeddings и выполнения запроса к Vectorize. Клиент может запросить разрешённую категорию, но только доверенная серверная логика сопоставляет удостоверение с пространством имён клиента.
Откройте Workers & Pages → ваш Worker labex-c08-v04-... → Bindings. Убедитесь, что AI указывает на Workers AI, а DOCUMENTS — на точный временный индекс Vectorize. Эта визуальная связь показывает, как env.AI и env.DOCUMENTS в коде обращаются к управляемым сервисам; независимые проверки по-прежнему подтверждают точные идентификаторы привязок.
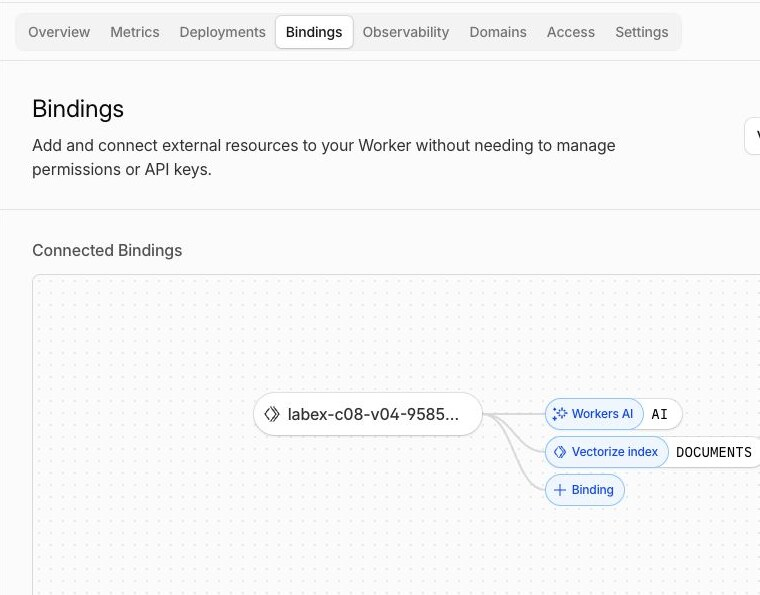
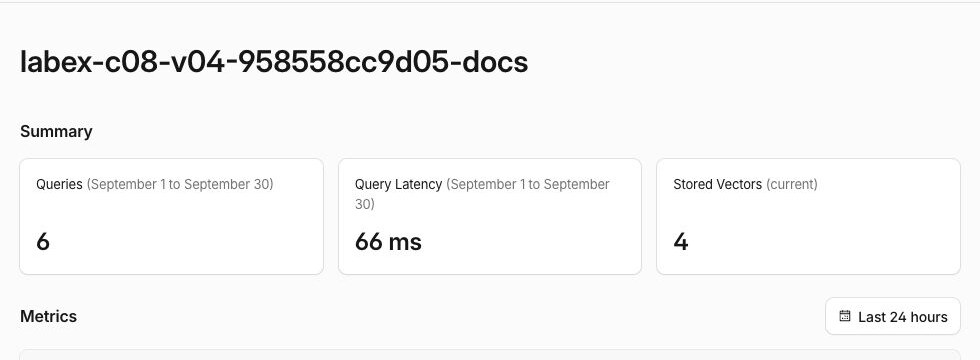
Затем откройте AI → Vectorize → соответствующий индекс -docs. Текущее количество векторов со временем должно стать равным четырём, а метрики запросов начнут отражать поиск с заданной областью. Счётчики Dashboard могут обновляться с задержкой; для точных идентификаторов, пространств имён и категорий достоверными остаются аутентифицированные чтения записей и HTTP-ответы.
Если доступны Workers Logs, откройте представление Observability → Logs вашего Worker и найдите запись scoped_search. В ней фиксируются только синтетическая метка клиента, пространство имён, категория и количество возвращённых результатов — не текст вопроса и не метка сессии. Структурированные журналы с ограниченным содержимым помогают определить, какая область, выбранная сервером, выполнялась, не копируя конфиденциальное содержимое запроса.
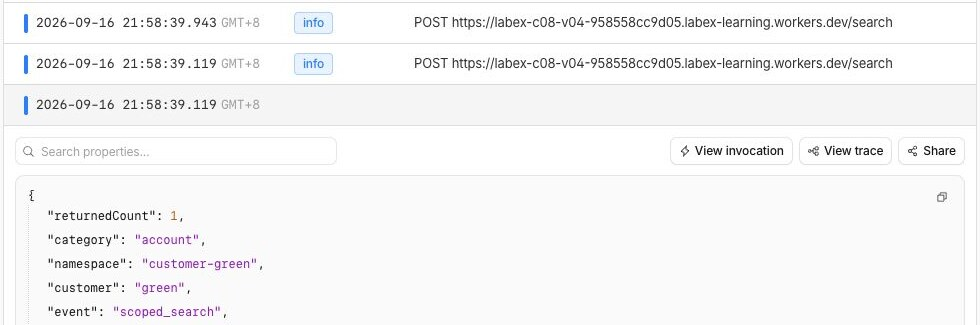
Эти снимки экрана — примеры из одного временного тестового запуска. Имя ресурса со случайным суффиксом, временные отметки, задержка и общее количество запросов у вас будут отличаться; сравнивайте имена привязок, текущее количество векторов и связи между полями, а не копируйте значения из примеров.
Удалите ресурсы поиска
На этом шаге вы удалите временные Worker и индекс, а затем подтвердите их отсутствие, пока авторизация Wrangler ещё действует.
Получите точные имена из wrangler.jsonc, чтобы очистка не зависела от переменных из предыдущего сеанса терминала:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Убедитесь, что оба значения начинаются с вашего уникального префикса labex-c08-v04-.... Сначала удалите Worker, чтобы развёрнутый код больше не сохранял привязку, затем удалите только соответствующий ему индекс:
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Сохраните успешный аутентифицированный список ресурсов и проверьте точное имя:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Завершите этот шаг до выхода из системы. Сбой сети или авторизации не является достаточным подтверждением; проверка также требует успешного чтения данных учётной записи и отсутствия ресурса с точным именем.
Выйдите из учебной виртуальной машины
На этом шаге вы удалите временную авторизацию Wrangler с этой виртуальной машины. Облачные ресурсы уже удалены, а аутентифицированная проверка очистки завершена успешно:
npx wrangler logout
npx wrangler whoami --json
Ожидается loggedIn: false. Сессия браузера Cloudflare Dashboard отделена от этого доступа и остаётся доступной для вашей учебной учётной записи.
Итоги
Вы добавили две независимые проверки допустимости к семантическому поиску. Проверенная синтетическая сессия выбрала на сервере пространство имён одного клиента, а индексированное поле category сузило поиск внутри этого раздела до ранжирования результатов Vectorize. Одинаковые документы о пароле показали, что одно лишь сходство не может обеспечить изоляцию клиентов, а запрос blue для категории files продемонстрировал: разрешённый пустой результат безопаснее, чем использование релевантной записи другого клиента.
Кроме того, вы отклонили переданные клиентом переопределения клиента и пространства имён до запуска inference, проверили в Dashboard реальные связи между привязками, индексом и журналом с ограниченным содержимым, удалили временные Worker и индекс с действующей авторизацией, а затем вышли из системы. В V05 эта безопасная граница поиска будет повторно использована для формирования ограниченного набора исходных данных перед ответом языковой модели.