Введение
В V01 были сохранены идентифицированные векторы, а V02 обеспечил актуальность этих записей. В этой лабораторной работе добавляется недостающий путь чтения: пользователь вводит вопрос, приложение преобразует этот текст в совместимый вектор и запрашивает у Vectorize документы, векторы которых указывают в наиболее близких направлениях.
Это семантический поиск. Он сравнивает эмбеддинги, ориентированные на смысл, вместо требования повторять точные слова статьи в запросе. Для запроса и сохранённых документов должны использоваться одна и та же модель, 384 измерения и pooling cls. Оценка сходства Vectorize помогает ранжировать совместимые векторы для одного запроса; это не универсальный процент уверенности и не доказательство того, что статья отвечает на вопрос.
Вы создадите один временный Worker с двумя привязками Cloudflare. AI отправляет короткий текст в размещённую Cloudflare модель эмбеддингов @cf/baai/bge-small-en-v1.5. DOCUMENTS записывает данные в один временный индекс Vectorize и выполняет запросы к нему. Worker предоставляет фиксированную операцию /seed для трёх синтетических справочных статей и операцию /search, которая принимает запрос, topK и необязательную минимальную оценку. topK означает «вернуть не более такого количества ближайших кандидатов», а не «эти кандидаты определённо релевантны».
Это третья лабораторная работа по Vectorize. Если вы открыли её напрямую, сначала выполните Connect LabEx to Your Cloudflare Account, затем пройдите V01 и V02, чтобы разобраться с совместимостью индекса, стабильными идентификаторами и асинхронными мутациями.
Для Vectorize и Workers AI доступны бесплатные квоты. В этой лабораторной работе сохраняются три небольших вектора и выполняется всего несколько коротких запросов на получение эмбеддингов. План Workers Paid не требуется. Локальное или развёрнутое выполнение всё равно расходует общую дневную квоту Workers AI, поэтому прекратите попытки и не повторяйте запросы, если модель или бесплатная квота недоступны.
В процессе настройки устанавливаются Node.js 22.22.0 и локальный для проекта Wrangler 4.132.0 в /home/labex/project/vector-search. Настройка предоставляет детерминированные тесты и независимые проверки, но не выполняет авторизацию в Wrangler, не вызывает модель, не создаёт индекс, не развёртывает Worker и не загружает данные в облако.
Авторизация и именование ресурсов поиска
На этом этапе вы авторизуете новую виртуальную машину и создадите одну конфигурацию, в которой будут указаны имена Worker и связанного с ним индекса Vectorize.
Перейдите в подготовленный проект и проверьте зафиксированную версию CLI:
cd /home/labex/project/vector-search
npx wrangler --version
Ожидается 4.132.0. Wrangler использует вход через устройство, поэтому ваш пароль не попадёт в виртуальную машину. Запросите доступ к данным аккаунта, Worker, Vectorize и Workers AI для этой временной лабораторной работы:
Wrangler разделяет операции с индексом, развёртывание скрипта и проверки очистки. Запросите workers:write для Vectorize, workers_scripts:write для Worker, workers_kv:write для безопасной проверки удаления зависимостей Wrangler и ai:write для привязки модели:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Убедитесь, что указано loggedIn: true и выбран нужный учебный аккаунт. Сгенерируйте один случайный суффикс, а затем получите из него имена обоих ресурсов, чтобы при очистке их нельзя было перепутать с другими ресурсами:
RUN="labex-c08-v03-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex:  %s\n' "$RUN" "$INDEX"
Замените YOUR_ACCOUNT_ID фактическим идентификатором выбранного аккаунта. Привязка — это имя, через которое код Worker получает доступ к управляемой службе Cloudflare. AI будет выполнять инференс модели, а DOCUMENTS будет предоставлять именно индекс Vectorize, указанный в index_name.
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "account_id": "YOUR_ACCOUNT_ID",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI", "remote": true },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
Конфигурация указывает имена ресурсов, но не создаёт их. Благодаря такому разделению вы можете проверить предполагаемую границу владения ресурсами до внесения каких-либо изменений в аккаунт.
Создание Worker с привязанными службами поиска
На этом этапе вы реализуете фиксированную загрузку документов и доступную учащемуся конечную точку поиска, не развёртывая код.
Три исходных документа остаются в коде приложения, поскольку Vectorize хранит векторы и метаданные, но не является полной системой учёта статей. /seed один раз получает эмбеддинги для этого фиксированного набора. /search получает эмбеддинг одного проверенного запроса, запрашивает у Vectorize ближайшие topK кандидатов и после этого применяет minScore. Возвращённые метаданные помогают приложению преобразовать идентификаторы векторов обратно в полезные ссылки.
cat > src/index.js <<'JS'
const MODEL = "@cf/baai/bge-small-en-v1.5";
const POOLING = "cls";
const DIMENSIONS = 384;

const DOCUMENTS = [
  {
    id: "password-reset",
    category: "account",
    title: "Reset an expired password",
    text: "Reset an expired or forgotten password to regain access to your account."
  },
  {
    id: "upload-pdf",
    category: "files",
    title: "Upload a PDF",
    text: "Upload a PDF document and troubleshoot file size or format errors."
  },
  {
    id: "billing-receipt",
    category: "billing",
    title: "Download a billing receipt",
    text: "Download a receipt for a completed invoice or payment."
  }
];

function json(value, status = 200) {
  return Response.json(value, { status, headers: { "cache-control": "no-store" } });
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

export function parseSearchInput(value) {
  const query = typeof value?.query === "string" ? value.query.trim() : "";
  const topK = value?.topK === undefined ? 3 : value.topK;
  const minScore = value?.minScore === undefined ? 0 : value.minScore;
  if (!query || query.length > 200) throw new Error("query_required");
  if (!Number.isInteger(topK) || topK < 1 || topK > 3) throw new Error("topk_invalid");
  if (typeof minScore !== "number" || !Number.isFinite(minScore) || minScore < 0 || minScore > 1) throw new Error("minscore_invalid");
  return { query, topK, minScore };
}

async function embed(env, texts) {
  const result = await env.AI.run(MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, DOCUMENTS.map((document) => document.text));
  const records = DOCUMENTS.map((document, index) => ({
    id: document.id,
    values: vectors[index],
    metadata: {
      category: document.category,
      published: true,
      title: document.title,
      model: MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "documents_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

async function search(request, env) {
  let input;
  try {
    input = parseSearchInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }
  const [queryVector] = await embed(env, [input.query]);
  const result = await env.DOCUMENTS.query(queryVector, { topK: input.topK, returnMetadata: "all" });
  const matches = result.matches
    .filter((match) => Number.isFinite(match.score) && match.score >= input.minScore)
    .map((match) => ({
      id: match.id,
      score: match.score,
      title: match.metadata?.title,
      category: match.metadata?.category
    }));
  console.log(JSON.stringify({ event: "documents_retrieved", candidateCount: result.matches.length, returnedCount: matches.length, topK: input.topK }));
  return json({ model: MODEL, dimensions: DIMENSIONS, pooling: POOLING, candidateCount: result.matches.length, matches });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/search") return search(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Запустите детерминированные тесты. Они заменяют обе привязки небольшими фикстурами в памяти, поэтому проверяют валидацию и логику выполнения, не расходуя квоту AI или Vectorize:
node --test test/worker.test.mjs
Ожидается пять успешно пройденных тестов. Затем сгенерируйте типы привязок и попросите Wrangler собрать Worker без его развёртывания:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v03-dry-run
Сгенерированный файл типов должен содержать и AI: Ai, и DOCUMENTS: VectorizeIndex. Пробный запуск подтверждает, что модуль и конфигурация собираются вместе; он не подтверждает существование облачных служб.
Создание индекса и развёртывание обеих привязок
На этом этапе вы создадите пустой совместимый индекс, а затем развернёте Worker, который получает обе управляемые привязки.
Модель эмбеддингов возвращает 384 числа. Косинусное расстояние сравнивает их направление, поэтому создайте индекс с тем же неизменяемым контрактом:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Развёртывайте Worker только после создания индекса: Cloudflare должна сопоставить настроенную привязку DOCUMENTS с реальным ресурсом:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
Wrangler должен вывести обе привязки и URL workers.dev. Сохраните точный URL, не пытаясь угадать поддомен:
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix the deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
На этом этапе индекс намеренно пуст. Развёртывание подключает службы, но не создаёт эмбеддинги и не загружает документы автоматически.
Загрузка живых эмбеддингов документов
На этом этапе вы один раз вызовете фиксированную операцию /seed, сохраните идентификатор мутации и дождётесь, пока все три эмбеддинга модели станут доступны для чтения.
Worker отправляет три коротких текста документов модели BGE Small одним пакетом. Он проверяет форму результата, добавляет стабильные идентификаторы и полезные метаданные, а затем выполняет upsert записей. Вызовите операцию с пустым JSON-объектом, поскольку набор документов контролируется сервером:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
Ожидается ответ HTTP 202 с данными, содержащими count: 3, 384 измерения, pooling cls и UUID мутации. Принятая мутация выполняется асинхронно, поэтому создайте такую же ограниченную проверку стабильности, как в предыдущих лабораторных работах. execFileSync запускает закреплённый процесс Wrangler, а readFileSync читает сохранённый ответ /seed; эти функции относятся к разным встроенным модулям Node.js:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const indexName = process.argv[2];
const seed = JSON.parse(readFileSync(".labex/seed-response.json", "utf8"));
const mutationId = seed.mutationId;
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("seed response has no mutation ID");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (info.processedUpToMutation === mutationId && info.vectorCount === 3) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log(`mutation ${mutationId} is consistently readable with three vectors`);
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error(`mutation ${mutationId} was not readable within four minutes`);
JS
node scripts/wait-for-vectorize.mjs "$INDEX"
Три совпадающих чтения защищают отображаемый результат от кратковременно устаревшей реплики. После успешного завершения ожидания выведите стабильные идентификаторы приложения:
npx wrangler vectorize list-vectors "$INDEX" --count=10
В списке должны присутствовать password-reset, upload-pdf и billing-receipt. Фактические значения получены от размещённой в Cloudflare рабочей модели, а не от детерминированных учебных векторов, использованных в V01 и V02.
Получение и интерпретация похожих статей
На этом этапе вы отправите содержательный вопрос о пароле, изучите двух ближайших кандидатов и отличите ранжирование от явного пустого результата.
Запросите topK: 2. Vectorize может просмотреть весь небольшой индекс, но вернёт не более двух ближайших кандидатов. Первым результатом должна быть статья о пароле: запрос и статья имеют близкий смысл, хотя их точные формулировки различаются:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"My old password expired and I cannot sign in","topK":2}' \
  | tee .labex/password-search.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  console.table(value.matches);
' .labex/password-search.json
Ожидаются две строки, отсортированные по убыванию оценки, причём первой должна быть password-reset. Сравнивайте оценки относительно друг друга: большее значение означает, что результат ближе для этого совместимого запроса и индекса, но 0.8 не означает «80% правильности». topK также не задаёт порог релевантности.
Теперь задайте несвязанный вопрос и установите minScore: 1. Vectorize по-прежнему вернёт приложению трёх кандидатов, но приложение удалит каждого кандидата, оценка которого ниже порога:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":"volcanic basalt crystallization","topK":3,"minScore":1}' \
  | tee .labex/empty-search.json
Ожидаются candidateCount: 3 и matches: []. Пустой список совпадений — это явное решение приложения, а не доказательство отсутствия векторов в индексе.
Наконец, отправьте пустой ввод:
curl --silent --show-error \
  -o .labex/empty-input.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/search" \
  -H 'content-type: application/json' \
  --data '{"query":""}'
cat .labex/empty-input.json
Ожидаются HTTP 400 и query_required. Валидация выполняется до вызова модели или базы данных, поэтому некорректный ввод не расходует ресурсы инференса и запросов.
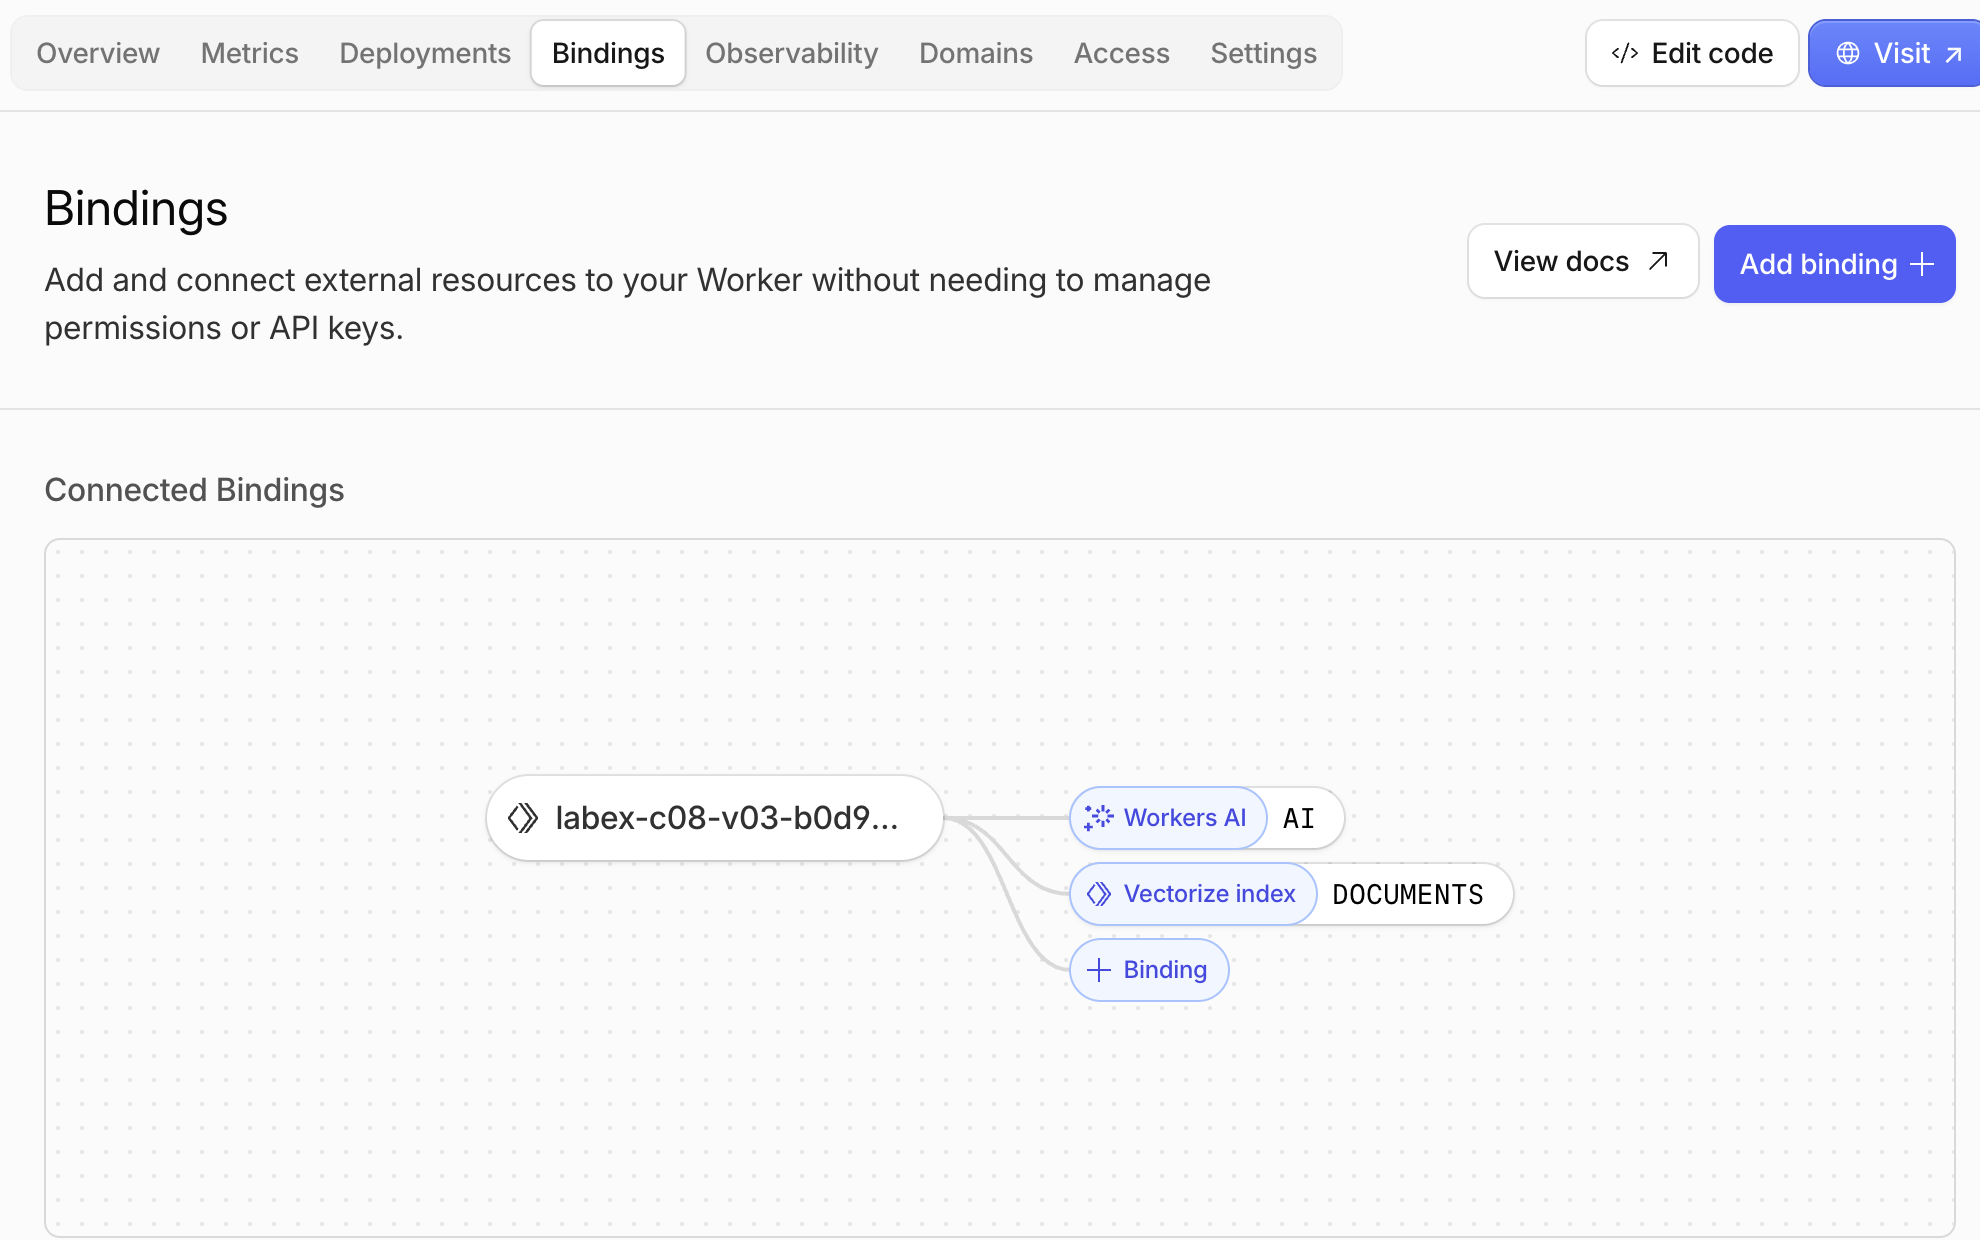
Откройте Workers & Pages → ваш Worker labex-c08-v03-... → Bindings. Привязка предоставляет коду Worker безопасное имя другой службы Cloudflare. Здесь AI — имя, используемое env.AI для запуска модели эмбеддингов, а DOCUMENTS — имя, используемое env.DOCUMENTS для запросов к этому конкретному индексу Vectorize.
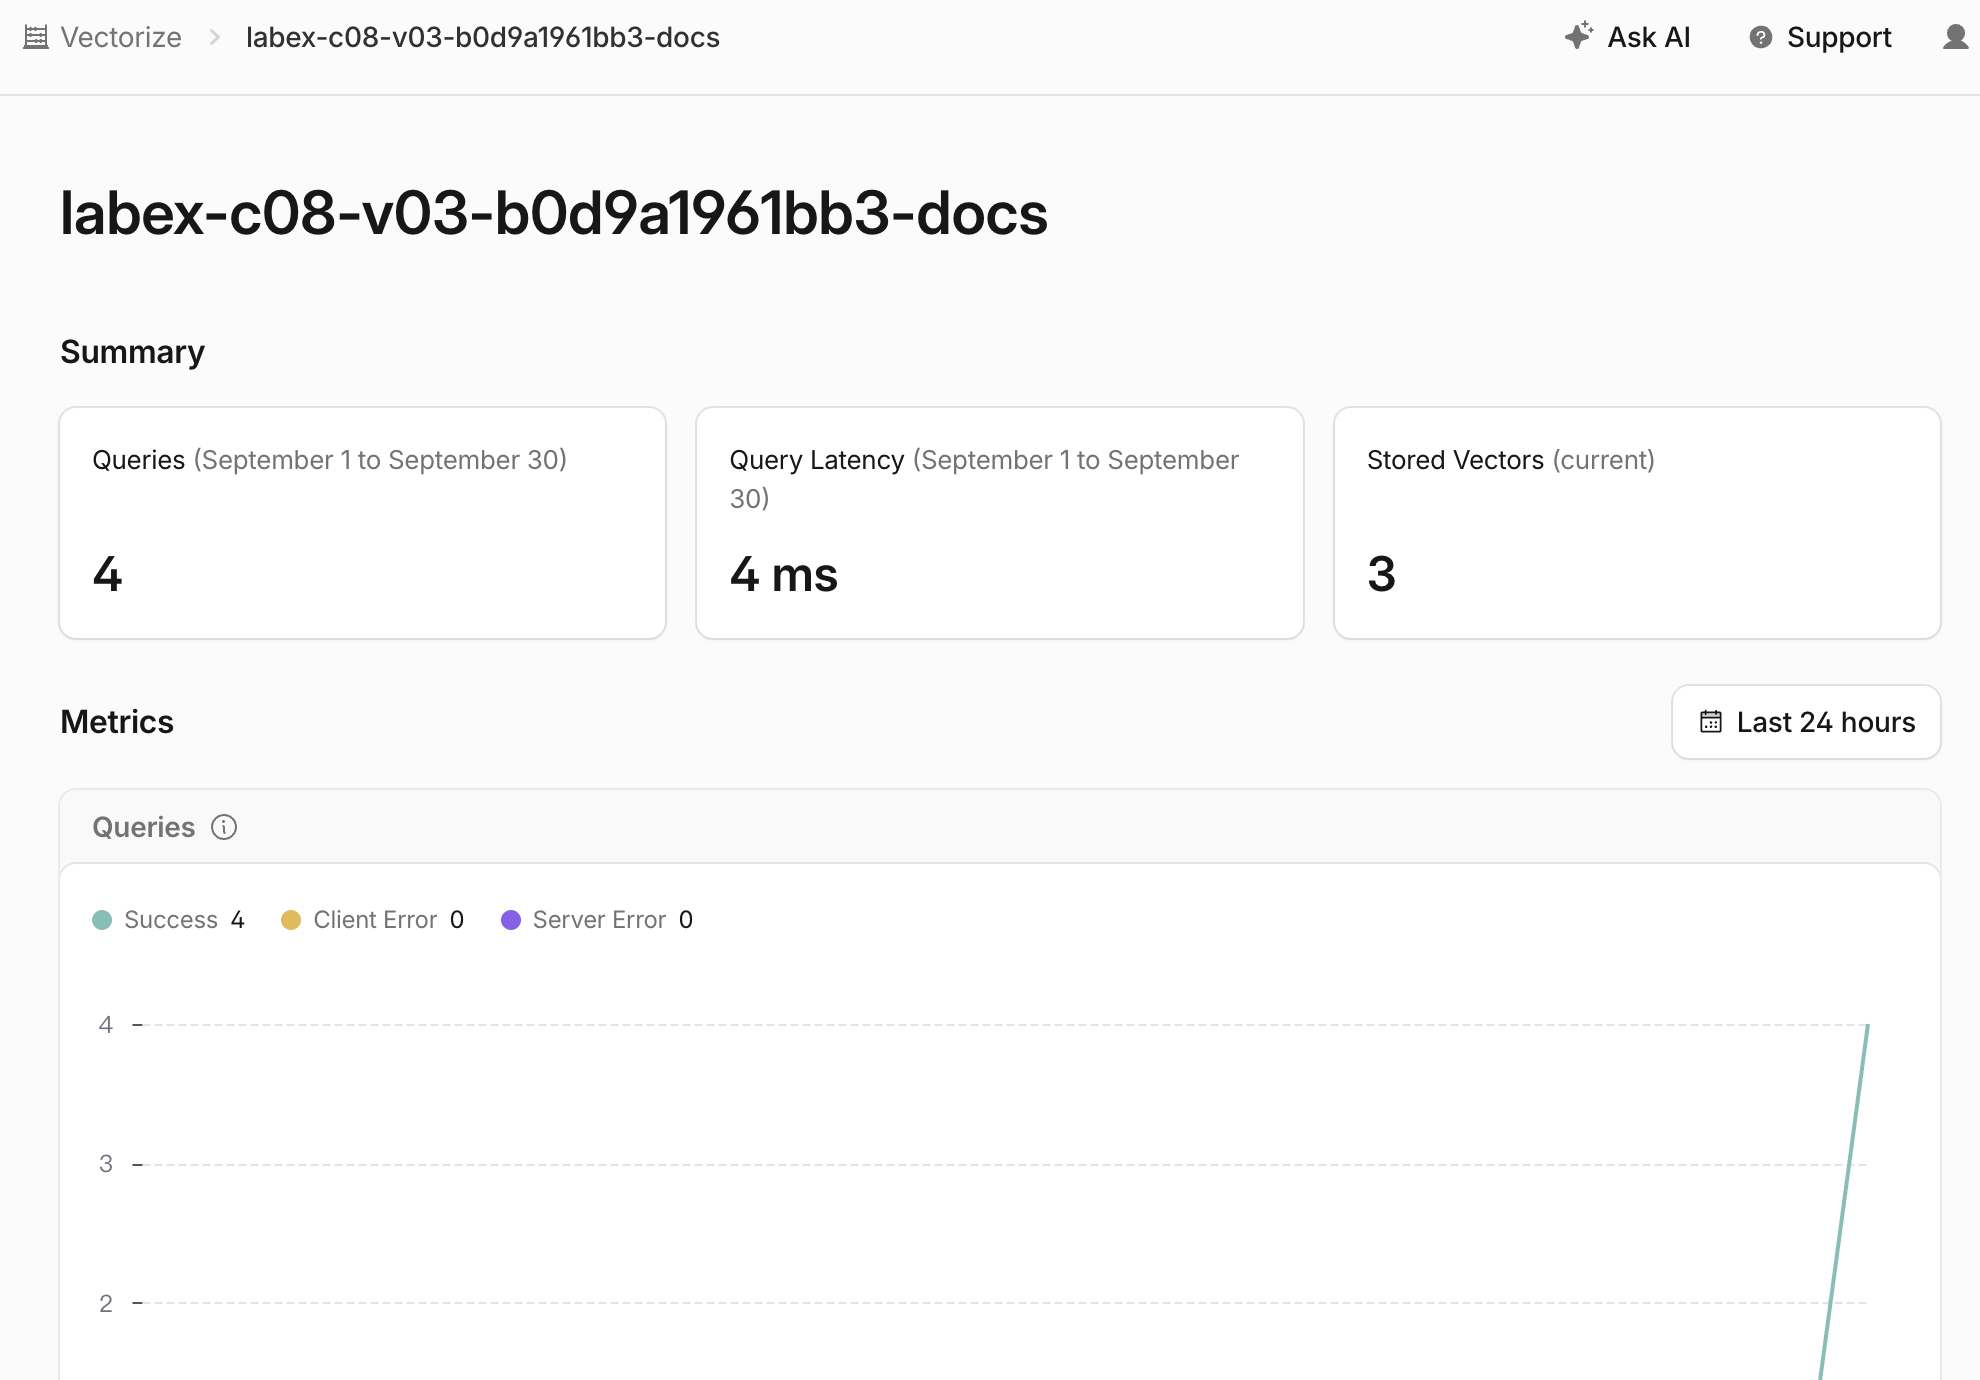
Затем откройте AI → Vectorize → соответствующий индекс -docs. В сводке должны отображаться три текущих вектора — по одному для каждой загруженной справочной статьи. Общее число запросов может отличаться от примера, поскольку каждый успешный поиск, включая повторные проверки, добавляет новый запрос.
Прокрутите страницу до раздела Metrics. P50, P75 и P95 — это перцентили задержки: например, P95 означает, что 95% успешных запросов завершились за это время или быстрее. Эти значения описывают скорость, а не релевантность совпадения. График Stored Vectors должен оставаться на уровне трёх, пока вы только выполняете поиск и не добавляете и не удаляете документы.
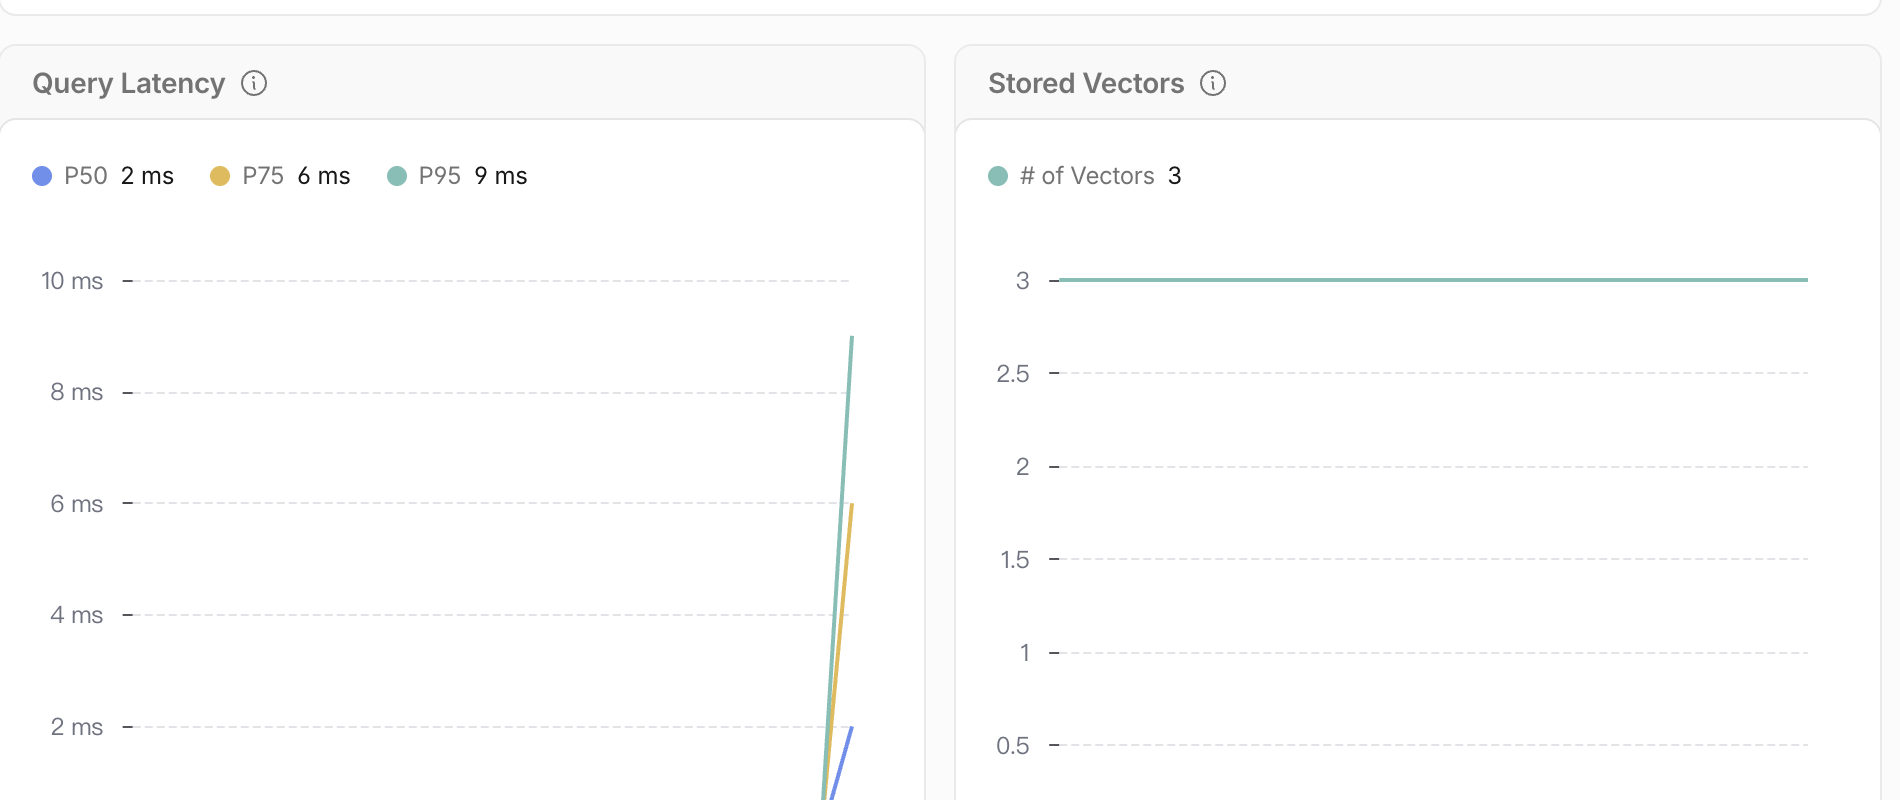
Счётчики на панели могут отставать от терминала на несколько секунд. Считайте ответы API, возвращённые идентификаторы и независимые проверки достоверным результатом; используйте Dashboard, чтобы связать эти результаты с ресурсами, которые вы видите и которыми управляете.
Удаление Worker поиска и индекса
На этом этапе вы удалите оба временных облачных ресурса и подтвердите их отсутствие, пока Wrangler всё ещё авторизован. Выход из аккаунта выполняется отдельно в последнем шаге, поскольку проверке очистки нужен доступ на чтение к Cloudflare.
Сначала получите точные имена из wrangler.jsonc. Это делает очистку безопасной, даже если вы открыли новый терминал и прежние переменные RUN и INDEX больше не существуют:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
До удаления чего-либо убедитесь, что оба значения начинаются с уникального префикса labex-c08-v03-....
Сначала удалите Worker, чтобы ни один развёрнутый код не сохранял привязку к индексу:
npx wrangler delete --name "$RUN" --force
Удалите только связанный с ним индекс, затем сохраните успешно полученный с авторизацией список ресурсов для оценки очистки:
npx wrangler vectorize delete "$INDEX" --force
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Завершите этот шаг сейчас, до выхода из аккаунта. Проверка независимо обращается к Cloudflare и не считает ошибку авторизации или сети доказательством удаления.
Выход из учебной виртуальной машины
На этом этапе вы удалите временную авторизацию Wrangler с этой виртуальной машины. Облачные ресурсы уже удалены, а проверка очистки с авторизацией завершена успешно, поэтому теперь можно безопасно выйти из аккаунта:
npx wrangler logout
npx wrangler whoami --json
Ожидается loggedIn: false. Сеанс браузера в Cloudflare Dashboard не зависит от этого и остаётся доступным для вашего учебного аккаунта.
Итоги
Вы создали Worker, который использует один контракт модели и для сохранённых эмбеддингов документов, и для эмбеддингов живых запросов, загрузили в Vectorize три записи со стабильными идентификаторами и дождались выполнения реальной асинхронной мутации. Вы использовали topK для ограничения числа кандидатов, интерпретировали оценки как относительные сигналы ранжирования, возвращали метаданные вместо необработанных векторов и формировали явный пустой результат после применения порога на уровне приложения. В конце вы подтвердили обе облачные привязки в Dashboard, удалили временные Worker и индекс, пока авторизация ещё действовала, а затем вышли из виртуальной машины.
В V04 появятся пространства имён клиентов, управляемые сервером, и фильтры метаданных, чтобы семантически похожая запись возвращалась только в том случае, если она также относится к разрешённой области поиска.