Введение
В V03 вы преобразовали вопросы в эмбеддинги и извлекли близкие статьи справки. В V04 эти результаты оставались внутри границ клиента и категории, заданных сервером. Извлечение полезно само по себе, но многим приложениям поддержки нужен ещё один шаг: преобразовать одобренные фрагменты в короткий ответ на естественном языке.
Этот подход называется retrieval-augmented generation, или сокращённо RAG. Сначала приложение извлекает доказательства, затем строит небольшой контекст только из этих записей и просит языковую модель ответить на основе этого контекста. Само извлечение не делает модель автоматически достоверной. Приложение по-прежнему должно контролировать, какие источники допустимы, ограничивать объём текста в запросе, сохранять идентификаторы источников и прекращать обработку, если одобренных доказательств нет.
Вы создадите один временный Worker с двумя привязками Cloudflare. DOCUMENTS выполняет поиск в индексе Vectorize, а AI запускает модель эмбеддингов BGE Small и размещённую в Cloudflare модель генерации текста Llama. Worker сопоставляет возвращённые идентификаторы векторов с предоставленным в коде корпусом. Метаданные векторов используются для поиска, но не считаются эталонным текстом статьи.
Эндпоинт будет возвращать управляемый приложением массив sources рядом с сгенерированным ответом. Если поиск не найдёт ничего в выбранных пространстве имён и категории, Worker вернёт фиксированный ответ no_evidence, не вызывая модель генерации текста. Такая явная ветка безопаснее, чем просьба к модели импровизировать.
Если вы начали этот курс напрямую, сначала пройдите Подключение LabEx к вашей учётной записи Cloudflare. V01–V04 являются обязательными предварительными лабораторными работами: в них рассматриваются совместимые индексы, асинхронные мутации, семантический поиск и область действия, задаваемая сервером.
В этой лабораторной работе используется размещённая в Cloudflare модель @cf/meta/llama-3.3-70b-instruct-fp8-fast, поскольку ранее она уже проверялась в Workers Free в предшествующем курсе по Workers AI. DeepSeek V4 Flash также размещается в Cloudflare, но в настоящее время требует платного доступа, поэтому не является обязательной зависимостью для учащихся. Лабораторная работа отправляет только ограниченные запросы на создание эмбеддингов и генерацию; Workers Paid не требуется, пока доступна общая бесплатная квота Workers AI вашей учётной записи.
При настройке устанавливаются Node.js 22.22.0 и локальная версия Wrangler 4.132.0 в /home/labex/project/grounded-answer. Настройка предоставляет детерминированные тесты и независимые проверки только для чтения, но не авторизует Wrangler, не создаёт индекс, не разворачивает Worker, не запускает инференс и не добавляет данные в облако.
Авторизация и именование ресурсов RAG
На этом шаге вы авторизуете новую виртуальную машину, проверите учебную учётную запись и зададите имена для связанной пары Worker и индекса Vectorize, прежде чем что-либо создавать.
Перейдите в подготовленный проект и проверьте зафиксированные версии инструментов:
cd /home/labex/project/grounded-answer
node --version
npx wrangler --version
Ожидаются Node.js v22.22.0 и Wrangler 4.132.0. Вход в Dashboard через браузер не авторизует эту виртуальную машину автоматически, поэтому используйте вход Wrangler через устройство с разрешениями, необходимыми для получения данных об учётной записи, создания временного Worker, работы с Vectorize и Workers AI:
npx wrangler login --device --browser=false --scopes account:read user:read workers:write workers_scripts:write workers_kv:write ai:write
npx wrangler whoami --json
Откройте показанную ссылку авторизации, убедитесь, что код совпадает, и подтвердите нужную учётную запись LabEx Learning. Не сообщайте этот код, пароль или токен другим людям. В результате JSON убедитесь, что указано loggedIn: true, затем запишите имя и идентификатор учётной записи.
Сгенерируйте один случайный суффикс. Оба имени ресурсов будут содержать его, чтобы при очистке можно было определить точную пару:
RUN="labex-c08-v05-$(openssl rand -hex 6)"
INDEX="$RUN-docs"
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Создайте wrangler.jsonc. Here-документ записывает в файл блок между маркерами JSON; $RUN и $INDEX подставляются как уникальные имена этой виртуальной машины. Замените YOUR_ACCOUNT_ID идентификатором, который показала команда whoami:
cat > wrangler.jsonc <<JSON
{
  "\$schema": "./node_modules/wrangler/config-schema.json",
  "name": "$RUN",
  "main": "src/index.js",
  "compatibility_date": "2026-09-16",
  "compatibility_flags": ["nodejs_compat"],
  "account_id": "YOUR_ACCOUNT_ID",
  "workers_dev": true,
  "preview_urls": false,
  "observability": { "enabled": true },
  "ai": { "binding": "AI" },
  "vectorize": [
    { "binding": "DOCUMENTS", "index_name": "$INDEX", "remote": true }
  ]
}
JSON
AI — это одна привязка, хотя код будет обращаться через неё к двум моделям. DOCUMENTS указывает на связанный индекс. Файл задаёт имена предполагаемых ресурсов, но пока ничего не создаёт.
Создание Worker с извлечением и последующей генерацией
На этом шаге вы реализуете полный цикл RAG и проверите его решения с помощью детерминированных привязок в памяти, прежде чем использовать облачную квоту.
Предоставленный CORPUS — это эталонная карта идентификаторов и текстов. Vectorize хранит эмбеддинги и доступные для поиска метаданные; после запроса Worker принимает только те идентификаторы, которые удаётся сопоставить с этой картой. Затем он включает в запрос не более двух фрагментов. Благодаря этому неожиданная запись индекса не попадёт в контекст модели только потому, что получила высокий балл.
Создайте исходный код Worker:
cat > src/index.js <<'JS'
export const EMBEDDING_MODEL = "@cf/baai/bge-small-en-v1.5";
export const ANSWER_MODEL = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
const DIMENSIONS = 384;
const POOLING = "cls";
const ALLOWED_CATEGORIES = new Set(["account", "billing", "files"]);

export const CORPUS = [
  {
    id: "password-reset",
    namespace: "customer-blue",
    category: "account",
    title: "Reset a password",
    url: "https://support.example.test/articles/password-reset",
    text: "If a password expires, open the sign-in page, choose Forgot password, and use the one-time reset link sent to the verified email address."
  },
  {
    id: "mfa-recovery",
    namespace: "customer-blue",
    category: "account",
    title: "Recover multi-factor access",
    url: "https://support.example.test/articles/mfa-recovery",
    text: "If the authenticator device is unavailable, enter a saved recovery code. Contact an administrator only after all recovery codes are exhausted."
  },
  {
    id: "billing-receipt",
    namespace: "customer-blue",
    category: "billing",
    title: "Download a billing receipt",
    url: "https://support.example.test/articles/billing-receipt",
    text: "Open Billing, select a completed payment, and choose Download receipt to save a PDF copy."
  }
];

const CORPUS_BY_ID = new Map(CORPUS.map((item) => [item.id, item]));

function json(value, status = 200) {
  return Response.json(value, { status });
}

export function resolveSession(value) {
  if (value === "blue-session") return { customer: "blue", namespace: "customer-blue" };
  throw new Error("session_invalid");
}

export function parseAnswerInput(value) {
  if (!value || typeof value !== "object" || Array.isArray(value)) throw new Error("invalid_json");
  for (const key of ["customer", "customerId", "namespace", "sources", "context"]) {
    if (Object.prototype.hasOwnProperty.call(value, key)) throw new Error("scope_override_not_allowed");
  }
  const question = typeof value.question === "string" ? value.question.trim() : "";
  const category = typeof value.category === "string" ? value.category.trim() : "";
  if (!question || question.length > 240) throw new Error("question_required");
  if (!ALLOWED_CATEGORIES.has(category)) throw new Error("category_invalid");
  return { question, category };
}

export function validateEmbeddingBatch(result, expectedCount) {
  const vectors = result?.data;
  if (!Array.isArray(vectors) || vectors.length !== expectedCount || result?.shape?.[1] !== DIMENSIONS) {
    throw new Error("incompatible embedding batch");
  }
  for (const vector of vectors) {
    if (!Array.isArray(vector) || vector.length !== DIMENSIONS || !vector.every(Number.isFinite)) {
      throw new Error("invalid embedding vector");
    }
  }
  return vectors;
}

async function embed(env, texts) {
  const result = await env.AI.run(EMBEDDING_MODEL, { text: texts, pooling: POOLING });
  return validateEmbeddingBatch(result, texts.length);
}

async function seed(env) {
  const vectors = await embed(env, CORPUS.map((item) => item.text));
  const records = CORPUS.map((item, index) => ({
    id: item.id,
    namespace: item.namespace,
    values: vectors[index],
    metadata: {
      category: item.category,
      title: item.title,
      model: EMBEDDING_MODEL,
      pooling: POOLING
    }
  }));
  const mutation = await env.DOCUMENTS.upsert(records);
  console.log(JSON.stringify({ event: "grounding_sources_seeded", count: records.length, mutationId: mutation.mutationId }));
  return json({ mutationId: mutation.mutationId, count: records.length, model: EMBEDDING_MODEL, dimensions: DIMENSIONS, pooling: POOLING }, 202);
}

function noEvidence(category, candidateCount) {
  console.log(JSON.stringify({ event: "grounded_no_evidence", category, candidateCount }));
  return json({
    mode: "no_evidence",
    generated: false,
    answer: "I don't have enough approved evidence to answer that question.",
    sources: []
  });
}

async function answer(request, env) {
  let scope;
  try {
    scope = resolveSession(request.headers.get("x-lab-session") ?? "");
  } catch {
    return json({ error: "session_invalid" }, 401);
  }

  let input;
  try {
    input = parseAnswerInput(await request.json());
  } catch (error) {
    return json({ error: error instanceof Error ? error.message : "invalid_json" }, 400);
  }

  const [queryVector] = await embed(env, [input.question]);
  const result = await env.DOCUMENTS.query(queryVector, {
    topK: 2,
    namespace: scope.namespace,
    filter: { category: input.category },
    returnMetadata: "all"
  });

  const sources = result.matches.flatMap((match) => {
    const article = CORPUS_BY_ID.get(match.id);
    if (!article || article.namespace !== scope.namespace || article.category !== input.category) return [];
    return [{
      id: article.id,
      title: article.title,
      url: article.url,
      text: article.text,
      score: match.score
    }];
  });

  if (sources.length === 0) return noEvidence(input.category, result.matches.length);

  const context = sources.map((source) =>
    "[source:" + source.id + "] " + source.title + "\n" + source.text
  ).join("\n\n");
  const generation = await env.AI.run(ANSWER_MODEL, {
    messages: [
      {
        role: "system",
        content: "Answer only from the supplied support context. Keep the answer under 80 words. Cite supporting source IDs in square brackets. If the context is insufficient, say you do not have enough approved evidence."
      },
      {
        role: "user",
        content: "Question: " + input.question + "\n\nApproved context:\n" + context
      }
    ],
    max_tokens: 160,
    temperature: 0
  });
  const generatedAnswer = typeof generation?.response === "string" ? generation.response.trim() : "";
  if (!generatedAnswer) return json({ error: "generation_failed" }, 502);

  const references = sources.map(({ id, title, url, score }) => ({ id, title, url, score }));
  console.log(JSON.stringify({
    event: "grounded_answer",
    customer: scope.customer,
    namespace: scope.namespace,
    category: input.category,
    sourceIds: references.map((source) => source.id),
    sourceCount: references.length
  }));
  return json({
    mode: "grounded",
    generated: true,
    model: ANSWER_MODEL,
    answer: generatedAnswer,
    sources: references
  });
}

export default {
  async fetch(request, env) {
    const url = new URL(request.url);
    if (request.method === "POST" && url.pathname === "/seed") return seed(env);
    if (request.method === "POST" && url.pathname === "/answer") return answer(request, env);
    return json({ error: "not_found" }, 404);
  }
};
JS
Обратите внимание на порядок действий в answer(): сначала проверяется область действия, которой управляет сервер, затем создаётся эмбеддинг вопроса, извлекается не более двух подходящих результатов, каждый идентификатор сопоставляется с CORPUS, формируется ограниченный контекст и только после этого запускается генерация. В публичном ответе не передаются полный текст контекста и значения векторов, но сохраняются ссылки на источники, которые можно проверить.
Запустите детерминированный набор тестов:
node --test test/worker.test.mjs
Ожидаются семь успешно пройденных тестов. Фиктивные привязки подтверждают, что неизвестные идентификаторы и пустой результат поиска не передаются в генерацию текста. Сгенерируйте типы привязок и соберите проект без развёртывания:
npx wrangler types
npx wrangler deploy --dry-run --outdir /tmp/v05-dry-run
В сгенерированных типах должны присутствовать AI: Ai и DOCUMENTS: VectorizeIndex. Пробный запуск подтверждает, что файлы собираются вместе; он не создаёт облачные ресурсы и не запускает ни одну из моделей.
Создание подготовленного индекса и развёртывание
На этом шаге вы создадите совместимый индекс Vectorize, подготовите поле category для фильтрации и развернёте Worker после стабилизации этой подготовки.
Создайте косинусный индекс размерностью 384, который используется BGE Small. Параметр --update-config=false не позволяет Wrangler перезаписать уже проверенную вами явную привязку:
npx wrangler vectorize create "$INDEX" --dimensions=384 --metric=cosine --update-config=false
Создайте строковый индекс метаданных для category и сохраните возвращённый идентификатор мутации. set -o pipefail заставляет конвейер завершаться с ошибкой, если Wrangler завершился с ошибкой, даже если tee также записывает копию вывода:
set -o pipefail
npx wrangler vectorize create-metadata-index "$INDEX" \
  --propertyName=category \
  --type=string 2>&1 | tee .labex/category-index-output.txt
META_MUTATION=$(grep -Eo '[0-9a-fA-F]{8}-[0-9a-fA-F-]{27}' .labex/category-index-output.txt | tail -n 1)
if [ -z "$META_MUTATION" ]; then
  printf '%s\n' 'No metadata mutation ID was returned; fix the command before continuing.' >&2
else
  printf '%s\n' "$META_MUTATION" | tee .labex/category-mutation.txt
fi
Принятая мутация — это поставленная в очередь операция. Создайте ограниченный проверяющий скрипт, доступный только для чтения; он должен получить именно эту мутацию и одинаковое количество векторов в трёх последовательных чтениях:
cat > scripts/wait-for-vectorize.mjs <<'JS'
import { execFileSync } from "node:child_process";
import { readFileSync } from "node:fs";

const [indexName, mutationFile, expectedText] = process.argv.slice(2);
const mutationId = readFileSync(mutationFile, "utf8").trim();
const expectedCount = Number(expectedText);
if (!/^[0-9a-f-]{36}$/i.test(mutationId)) throw new Error("mutation file has no UUID");
if (!Number.isInteger(expectedCount) || expectedCount < 0) throw new Error("expected count is invalid");
const wrangler = "./node_modules/wrangler/bin/wrangler.js";
let consecutiveMatches = 0;

for (let attempt = 1; attempt <= 120; attempt += 1) {
  const output = execFileSync(process.execPath, [wrangler, "vectorize", "info", indexName, "--json"], { encoding: "utf8" });
  const info = JSON.parse(output);
  if (String(info.processedUpToMutation) === mutationId && info.vectorCount === expectedCount) consecutiveMatches += 1;
  else consecutiveMatches = 0;
  if (consecutiveMatches === 3) {
    console.log("mutation " + mutationId + " is consistently readable with " + expectedCount + " vectors");
    console.log(JSON.stringify(info, null, 2));
    process.exit(0);
  }
  await new Promise((resolve) => setTimeout(resolve, 2000));
}
throw new Error("mutation " + mutationId + " was not stable within four minutes");
JS
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/category-mutation.txt 0
Отдельное представление списка может отставать от состояния обработанной мутации, поэтому немного подождите, пока соответствующая строка не появится и там:
for attempt in {1..15}; do
  METADATA_INDEXES=$(npx wrangler vectorize list-metadata-index "$INDEX" 2>&1)
  if grep -Eq 'category.*String' <<<"$METADATA_INDEXES"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$METADATA_INDEXES"
grep -Eq 'category.*String' <<<"$METADATA_INDEXES" || {
  printf '%s\n' 'The category metadata index is processed but not yet visible; rerun this read-only check.' >&2
  exit 1
}
Наконец, разверните Worker и сохраните его общедоступный URL:
set -o pipefail
npx wrangler deploy 2>&1 | tee .labex/deploy-output.txt
DEPLOY_URL=$(sed -nE 's#.*(https://[^[:space:]]+\.workers\.dev).*#\1#p' .labex/deploy-output.txt | tail -n 1)
if [ -z "$DEPLOY_URL" ]; then
  printf '%s\n' 'No workers.dev URL was returned; fix deployment before continuing.' >&2
else
  printf '%s\n' "$DEPLOY_URL" | tee .labex/deploy-url.txt
fi
Индекс пока пуст. Развёртывание подключает привязки, но не создаёт эмбеддинги и записи источников автоматически.
Добавление одобренного корпуса источников
На этом шаге вы создадите рабочие эмбеддинги для трёх предоставленных статей и дождётесь, пока каждый идентификатор источника станет доступен для чтения.
Исходный текст остаётся в CORPUS; записи векторов содержат совместимый эмбеддинг и небольшие метаданные для поиска. Благодаря такому разделению приложение сопоставляет идентификатор с одобренным текстом статьи, а не доверяет произвольному тексту, скопированному из метаданных вектора.
Один раз вызовите фиксированный эндпоинт добавления данных:
DEPLOY_URL=$(cat .labex/deploy-url.txt)
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/seed" \
  -H 'content-type: application/json' \
  --data '{}' | tee .labex/seed-response.json
node -e '
  const value = JSON.parse(require("fs").readFileSync(".labex/seed-response.json", "utf8"));
  if (!/^[0-9a-f-]{36}$/i.test(value.mutationId)) throw new Error("seed mutation is missing");
  require("fs").writeFileSync(".labex/seed-mutation.txt", value.mutationId + "\n");
  console.log("accepted " + value.count + " source vectors in mutation " + value.mutationId);
'
Ожидаются три записи, размерность 384, пулинг cls и UUID мутации. Дождитесь именно этого состояния, затем немного подождите, пока все три идентификатора не появятся в отдельном представлении инвентаризации:
node scripts/wait-for-vectorize.mjs "$INDEX" .labex/seed-mutation.txt 3
for attempt in {1..15}; do
  VECTOR_LIST=$(npx wrangler vectorize list-vectors "$INDEX" --count=10 2>&1)
  if grep -q 'password-reset' <<<"$VECTOR_LIST" &&
     grep -q 'mfa-recovery' <<<"$VECTOR_LIST" &&
     grep -q 'billing-receipt' <<<"$VECTOR_LIST"; then
    break
  fi
  sleep 2
done
printf '%s\n' "$VECTOR_LIST"
for id in password-reset mfa-recovery billing-receipt; do
  grep -q "$id" <<<"$VECTOR_LIST" || {
    printf 'The processed source %s is not visible in the list yet; rerun this read-only check.\n' "$id" >&2
    exit 1
  }
done
Теперь каждый идентификатор связывает результат поиска с одной точной записью корпуса. В индексе намеренно нет статьи категории files, поэтому ветку отсутствия доказательств можно наблюдать без зависимости от порога сходства.
Сравнение обоснованных ответов и ответов без доказательств
На этом шаге вы отправите один вопрос, для которого есть источник, и один вопрос из разрешённой категории без источников. Различие между ними показывает логику работы RAG.
Спросите, как сбросить просроченный пароль в области действия синей учётной записи:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I reset my expired password?","category":"account"}' \
  | tee .labex/grounded-answer.json
Ожидаются mode: grounded, generated: true, непустой ответ и массив sources, первым элементом которого является password-reset. Формулировка ответа модели может отличаться. Надёжным признаком является то, что каждый возвращённый идентификатор, заголовок и URL сопоставляется с предоставленным корпусом, а в запрос попали только одобренные фрагменты категории account.
Теперь спросите о загрузке файла, сохранив ту же область действия клиента, заданную сервером. Категория files разрешена, но в этом корпусе нет подходящей записи о файле:
curl --fail-with-body --silent --show-error \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"How do I upload a PDF?","category":"files"}' \
  | tee .labex/no-evidence-answer.json
Ожидаются mode: no_evidence, generated: false, фиксированное сообщение I don't have enough approved evidence to answer that question. и sources: []. Worker всё равно создал эмбеддинг вопроса для поиска, но пропустил генерацию текста, поскольку одобренного контекста не было.
Попробуйте небезопасный запрос, в котором передаётся собственное пространство имён:
curl --silent --show-error \
  -o .labex/override-response.json \
  -w 'HTTP %{http_code}\n' \
  -X POST "$DEPLOY_URL/answer" \
  -H 'content-type: application/json' \
  -H 'x-lab-session: blue-session' \
  --data '{"question":"Help","category":"account","namespace":"customer-green"}'
cat .labex/override-response.json
Ожидаются HTTP 400 и scope_override_not_allowed. RAG не заменяет границу авторизации, изученную в V04: поиск должен быть безопасным до того, как его текст станет контекстом модели.
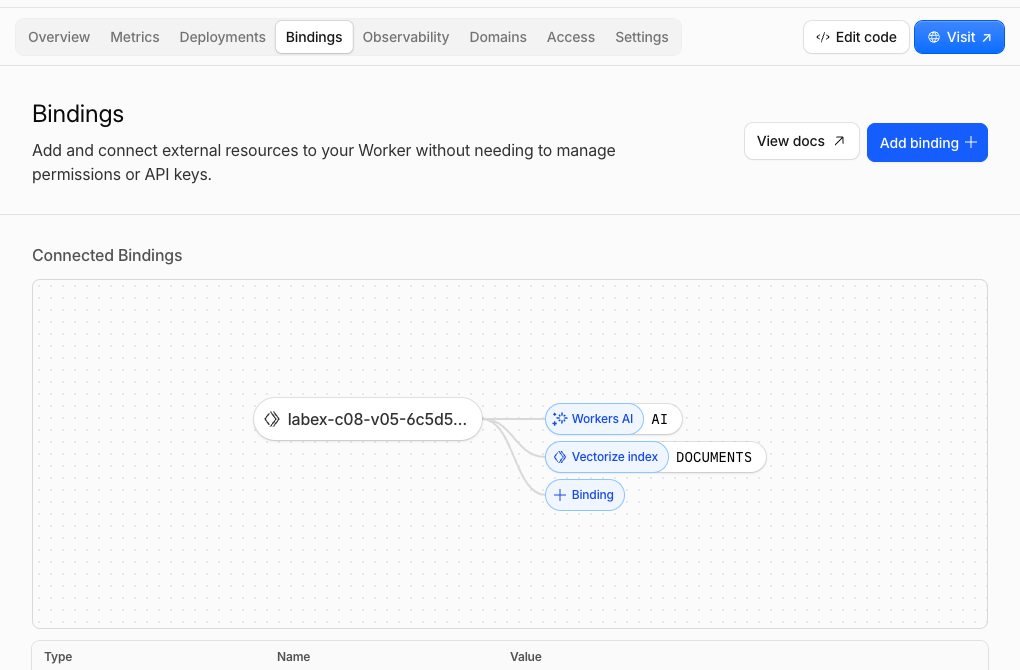
Откройте Workers & Pages → ваш Worker labex-c08-v05-... → Bindings. Убедитесь, что AI указывает на Workers AI, а DOCUMENTS — на связанный индекс Vectorize. В этом представлении имена сервисов в коде связываются с реальными управляемыми ресурсами.
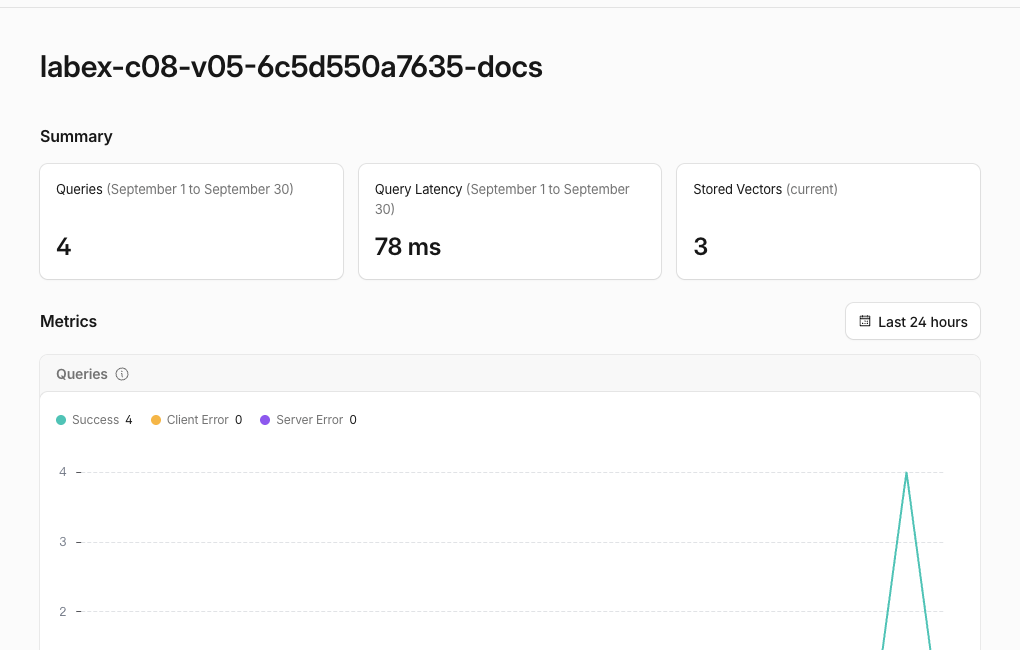
Затем откройте AI → Vectorize → соответствующий индекс -docs. Текущее количество должно со временем достигнуть трёх векторов, а активность запросов должна отражать поиск с обоснованным ответом и поиск без доказательств. Метрики Dashboard могут обновляться с задержкой, поэтому авторизованные чтения идентификаторов и ответы эндпоинта остаются источниками истины.
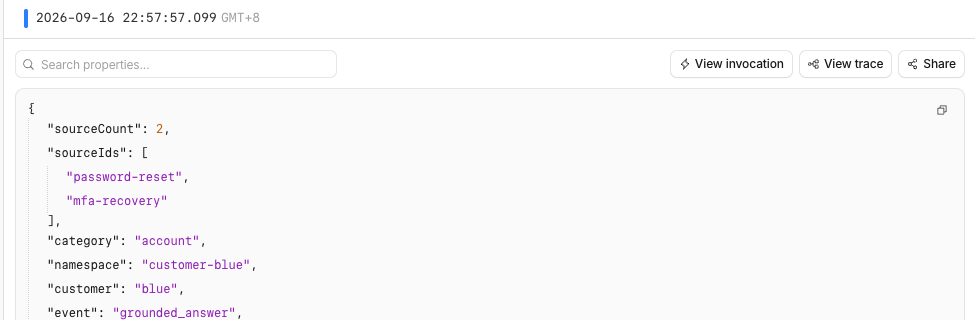
Если доступны Workers Logs, откройте Observability → Logs и найдите записи grounded_answer и grounded_no_evidence. В журналах есть категория, идентификаторы источников и их количество, но отсутствуют вопрос, ответ, текст фрагментов, метка сеанса и значения векторов. Это даёт операторам полезные сведения о ходе выполнения, не копируя запрос в журналы.
Удаление ресурсов обоснованных ответов
На этом шаге вы удалите временные Worker и индекс Vectorize, а затем подтвердите их отсутствие, пока Wrangler всё ещё авторизован.
Получите точные имена из wrangler.jsonc, чтобы очистка не зависела от переменных из предыдущего сеанса терминала:
RUN=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).name')
INDEX=$(node -p 'JSON.parse(require("fs").readFileSync("wrangler.jsonc", "utf8")).vectorize.find((item) => item.binding === "DOCUMENTS").index_name')
printf 'Worker: %s\nIndex: %s\n' "$RUN" "$INDEX"
Убедитесь, что оба значения используют ваш уникальный префикс labex-c08-v05-.... Сначала удалите Worker, чтобы в развёрнутом коде не осталось привязки, затем удалите только связанный с ним индекс:
npx wrangler delete --name "$RUN" --force
npx wrangler vectorize delete "$INDEX" --force
Сохраните успешный авторизованный список индексов и проверьте отсутствие точного имени:
npx wrangler vectorize list --json > .labex/indexes-after-cleanup.json
node -e '
  const rows = JSON.parse(require("fs").readFileSync(process.argv[1], "utf8"));
  if (rows.some((row) => row.name === process.argv[2])) throw new Error("lab index still exists");
  console.log("lab index is absent");
' .labex/indexes-after-cleanup.json "$INDEX"
Выполните эту проверку до выхода из системы. Ошибка сети или авторизации не является убедительным результатом: оценка отдельно требует успешного чтения данных учётной записи и отсутствия точного имени.
Выход из учебной виртуальной машины
На этом шаге вы удалите временную авторизацию Wrangler с этой виртуальной машины. Облачные ресурсы уже удалены, а авторизованная проверка очистки завершена успешно:
npx wrangler logout
npx wrangler whoami --json
Ожидается loggedIn: false. Сеанс Cloudflare Dashboard в браузере отделён от этого сеанса и остаётся доступным для вашей учебной учётной записи.
Итоги
Вы создали небольшой эндпоинт retrieval-augmented generation: область действия, заданная сервером, ограничивала поиск в Vectorize; возвращённые идентификаторы сопоставлялись с одобренным корпусом; в контекст модели попадало не более двух фрагментов; приложение возвращало стабильные ссылки на источники рядом с переменным по формулировке сгенерированным ответом.
Вы также проверили, что допустимый пустой поиск переходит в фиксированную ветку отсутствия доказательств без генерации текста, отклонили подмену области действия клиентом до начала поиска, изучили связи Worker, Vectorize и наблюдаемости с ограничением конфиденциальных данных, удалили оба временных ресурса с действующей авторизацией и вышли из системы. В задании курса вам предложат исправить сломанный эндпоинт, который нарушает ту же границу области действия.