Введение
Обычно модель ИИ генерирует новый ответ при каждом вызове из приложения. Это занимает время и расходует ресурсы модели, даже если запрос полностью совпадает с тем, на который модель только что ответила. Кэш сохраняет ответ, который можно повторно использовать в течение ограниченного времени. Благодаря этому идентичный запрос можно обработать без нового вызова модели.
Кэширование полезно только тогда, когда повторное использование безопасно. Общедоступный фиксированный вопрос из раздела FAQ подходит для кэширования: все пользователи могут получить один и тот же ответ. Персонализированный запрос в службу поддержки для этого не подходит: нельзя объединять запросы двух клиентов под одним ключом кэша только ради ускорения. Стандартный ключ кэша AI Gateway защищает эту лабораторную работу, включая в ключ провайдера, конечную точку, модель, учётные данные провайдера и полное тело запроса. Любое изменение тела создаёт отдельную запись.
Вы создадите один временный шлюз с аутентификацией и временем жизни кэша пять минут. Затем отправите небольшой общедоступный вопрос к Workers AI и увидите MISS, повторите точно такой же запрос и подтвердите HIT, после чего измените вопрос и снова получите MISS. В конце вы обойдёте существующий закэшированный ответ, когда потребуется свежий результат, и по журналам шлюза убедитесь, что запрос дошёл до модели.
Если вы открыли этот курс напрямую, сначала выполните лабораторную работу Connect LabEx to Your Cloudflare Account. В ней объясняется работа с терминалом виртуальной машины LabEx, авторизация устройства Wrangler, подтверждение учебной учётной записи и явное указание идентификатора аккаунта. Также сначала выполните лабораторную работу Route Inference Through a Gateway, поскольку здесь повторно используются созданные в ней отдельные границы шлюза и авторизации вышестоящего сервиса.
В лабораторной работе используется размещённая в Cloudflare модель @cf/meta/llama-3.3-70b-instruct-fp8-fast со стандартной тарификацией Workers AI. Workers Paid, Unified Billing и учётная запись внешнего провайдера не требуются. До модели должны дойти только три запроса; точный повтор должен обслуживаться из кэша. Если общая дневная квота Workers AI недоступна, прекратите выполнение и не повторяйте запросы многократно.
В процессе настройки устанавливаются Node.js 22.22.0 и локальная версия Wrangler 4.132.0 в каталоге /home/labex/project/ai-gateway-cache. Создаются независимые проверки только для чтения, но авторизация Wrangler, создание облачных ресурсов и отправка запросов к модели не выполняются. После завершения лабораторной работы LabEx удалит временную виртуальную машину. Однако перед выходом из системы вы всё равно удалите шлюз и токен, поскольку удаление виртуальной машины само по себе не удаляет облачные ресурсы.
Авторизуйте виртуальную машину и задайте имена для эксперимента с кэшем
На этом шаге вы подключите новую виртуальную машину к учебной учётной записи и создадите имена для одного временного шлюза и токена.
Кэш — это общая инфраструктура, поэтому его область действия нужно задавать осознанно. В этой лабораторной работе используется шлюз с уникальным именем и только синтетические общедоступные вопросы. Случайный суффикс не позволит вашему эксперименту столкнуться с другим шлюзом в той же учебной учётной записи.
Перейдите в подготовленный проект, проверьте зафиксированную версию CLI и авторизуйте эту виртуальную машину:
cd /home/labex/project/ai-gateway-cache
npx wrangler --version
npx wrangler login --device --browser=false --scopes account:read user:read ai:write
Откройте показанную ссылку, введите код и авторизуйте нужную учебную учётную запись. Проверьте структурированную информацию об identity:
npx wrangler whoami --json
Ожидаются Wrangler 4.132.0 и loggedIn: true. В следующей команде замените YOUR_ACCOUNT_ID фактическим 32-символьным идентификатором нужной учётной записи:
GATEWAY_ID="labex-c09-g03-$(openssl rand -hex 6)"
TOKEN_NAME="$GATEWAY_ID-token"
cat > .labex/state.json <<JSON
{
  "accountId": "YOUR_ACCOUNT_ID",
  "gatewayId": "$GATEWAY_ID",
  "tokenName": "$TOKEN_NAME"
}
JSON
cat .labex/state.json
Эти несекретные идентификаторы сохраняются в локальном инвентаре. Поэтому все последующие операции чтения, проверки и очистки будут обращаться только к ресурсам этой лабораторной работы.
Создайте шлюз с аутентификацией и коротким временем жизни кэша
На этом шаге вы создадите шлюз и зададите для закэшированных ответов время жизни пять минут — time to live, или TTL. TTL — это максимальное время, в течение которого запись можно повторно использовать. После его истечения запись становится устаревшей, и её нужно обновить из модели.
Откройте Cloudflare Dashboard и выберите AI → AI Gateway → Create gateway → Custom gateway. В качестве имени шлюза укажите сохранённый gatewayId. Оставьте включёнными журналирование запросов и аутентификацию шлюза, включите Cache responses и установите TTL ровно 300 секунд. Оставьте выключенными ограничения частоты запросов, ограничения расходов и повторы. Для Workers AI оставьте стандартную тарификацию Standard.
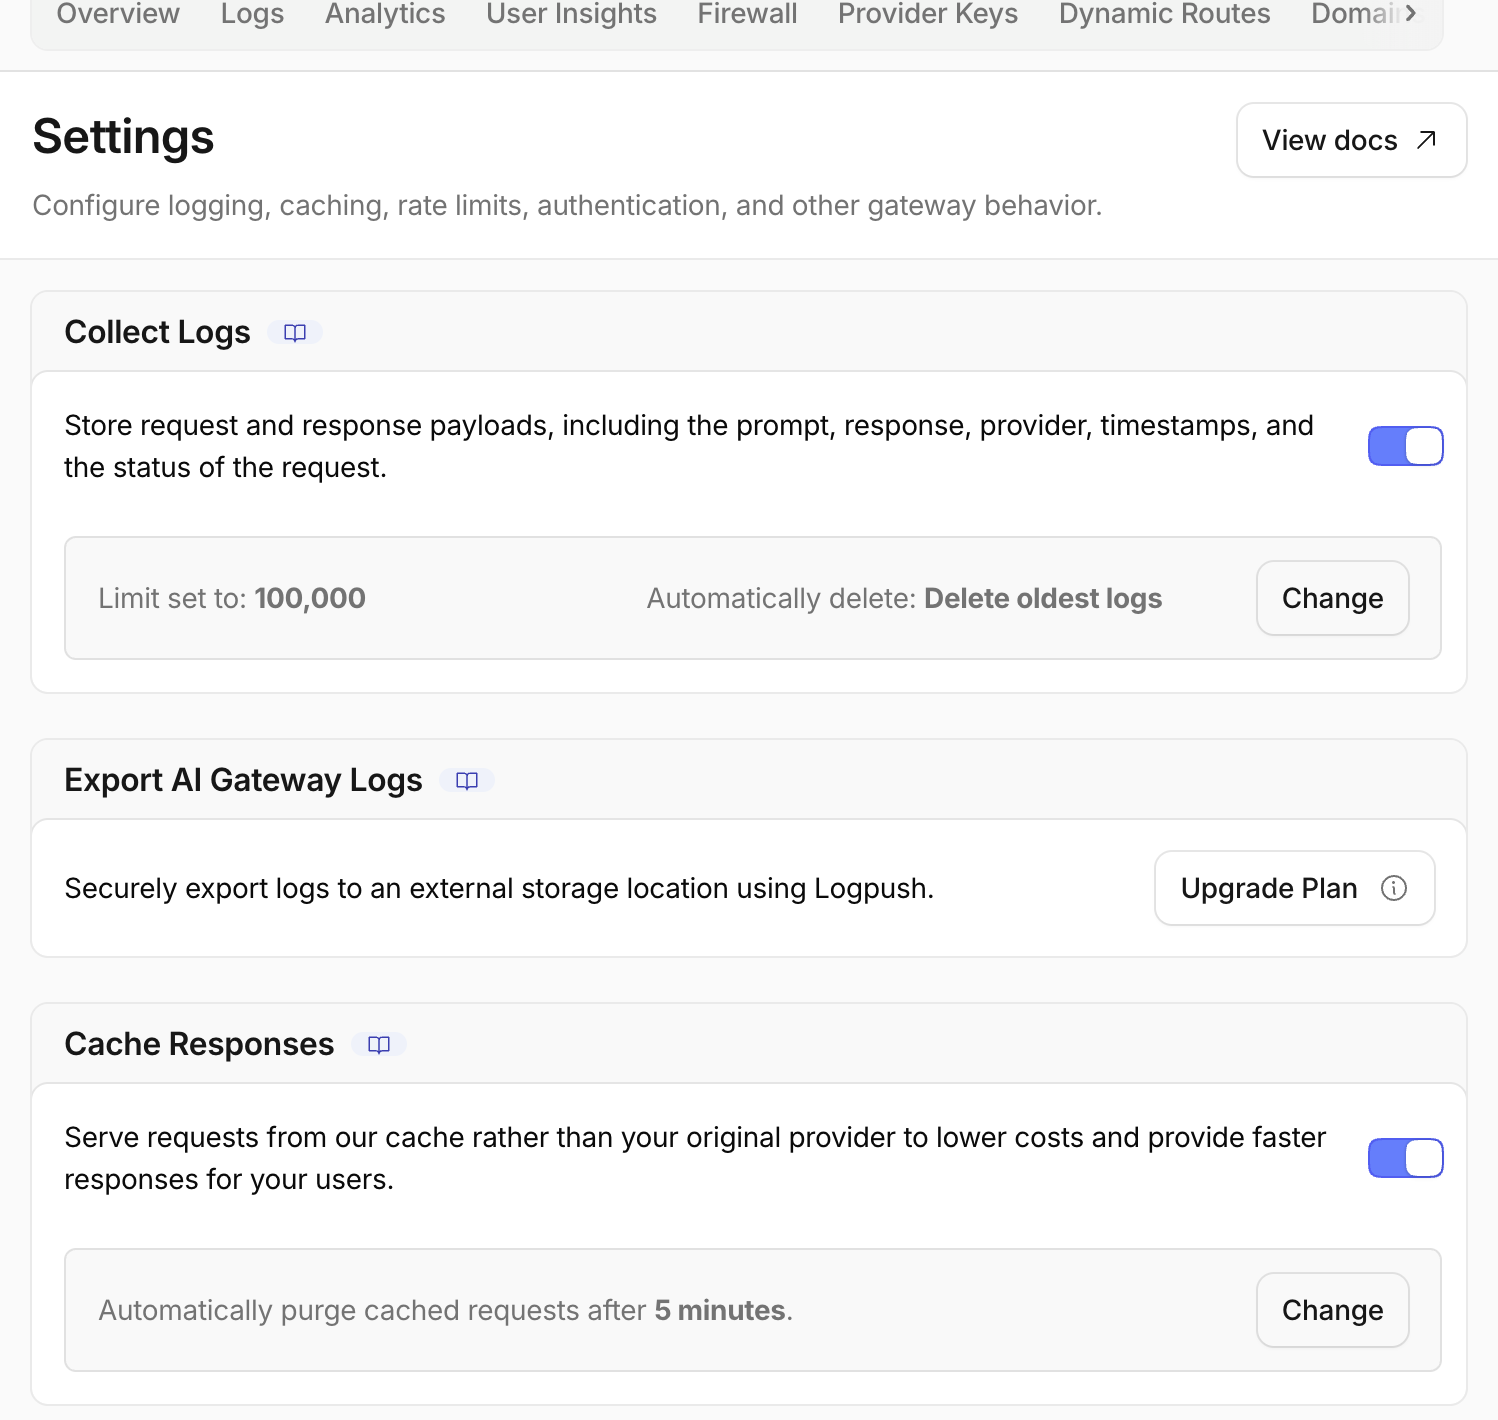
После создания проверьте уникальный идентификатор шлюза в цепочке навигации. Короткого TTL достаточно для повторения эксперимента, но примерный ответ не будет храниться дольше необходимого.
Выберите Create an AI Gateway authentication token. Используйте сохранённое tokenName, укажите только нужную учебную учётную запись и задайте ровно такие разрешения:
- AI Gateway — Run — для входа через шлюз с аутентификацией;
- AI Gateway — Edit — для чтения сведений о кэше и удаления временного шлюза.
Не добавляйте разрешение Workers AI. Wrangler предоставляет отдельные краткоживущие учётные данные для вышестоящего сервиса. Создайте токен после проверки учётной записи и разрешений, затем сохраните его одноразовое значение, не выводя его на экран:
bash -c '
while :; do
  read -ersp "Paste the AI Gateway token: " GATEWAY_TOKEN
  printf "\n"
  [ -n "$GATEWAY_TOKEN" ] && break
  printf "Token cannot be empty; paste it again.\n" >&2
done
umask 077
printf "%s" "$GATEWAY_TOKEN" > .labex/gateway-token
unset GATEWAY_TOKEN
chmod 600 .labex/gateway-token
'
Проверьте точную конфигурацию кэша через API управления с аутентификацией:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s),g=b.result||{};console.log(JSON.stringify({success:b.success,id:g.id,collect_logs:g.collect_logs,authentication:g.authentication,cache_ttl:g.cache_ttl},null,2))})'
unset GATEWAY_TOKEN
Ожидаются сохранённый идентификатор, collect_logs: true, authentication: true и cache_ttl: 300.
Отправьте первый общедоступный запрос FAQ
На этом шаге вы отправите небольшой общедоступный вопрос, который безопасно повторно использовать всем учащимся. Первая подходящая для кэширования заявка ещё не может иметь записи в новом шлюзе, поэтому должна завершиться с MISS. При промахе кэша AI Gateway передаёт запрос в Workers AI, а затем сохраняет успешный ответ.
Стандартный ключ кэша включает учётные данные вышестоящего провайдера. Сохраните текущие учётные данные Wrangler этой виртуальной машины в закрытом файле, чтобы все четыре запроса использовали один контролируемый ключ. Это краткоживущий файл лабораторной работы, а не шаблон для хранения секретов в рабочей среде:
umask 077
npx wrangler auth token --json \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>process.stdout.write(JSON.parse(s).token))' \
  > .labex/upstream-token
chmod 600 .labex/upstream-token
Отправьте первый запрос и сохраните заголовки ответа, тело и HTTP-статус, не выводя ни одни из учётных данных:
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
MODEL='@cf/meta/llama-3.3-70b-instruct-fp8-fast'
METADATA='{"lab":"g03-cache","case":"public-faq","synthetic":true}'
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
STATUS=$(curl --http1.1 -sS -D .labex/first-headers.txt \
  -o .labex/first-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/first-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/first-headers.txt \
  | tail -1 | tee .labex/first-cache-status.txt
node -e 'const b=require("./.labex/first-response.json"); console.log(b.result?.response ?? b.result)'
Ожидаются HTTP 200, статус кэша MISS и короткий сгенерированный ответ. Тело запроса не содержит данных клиентов, поэтому временно повторно использовать этот ответ безопасно.
Повторите точный запрос и подтвердите попадание в кэш
На этом шаге вы отправите абсолютно те же провайдер, конечную точку, модель, учётные данные и тело запроса. Поэтому AI Gateway сможет повторно использовать запись, созданную на предыдущем шаге. HIT означает, что ответ получен из кэша шлюза без новой генерации моделью.
Сохранение в кэше выполняется асинхронно, поэтому после успешного первого ответа подождите несколько секунд и только затем повторите запрос:
sleep 5
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"public-faq","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/repeat-headers.txt \
  -o .labex/repeat-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/repeat-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/repeat-headers.txt \
  | tail -1 | tee .labex/repeat-cache-status.txt
cmp -s .labex/first-response.json .labex/repeat-response.json \
  && echo 'response bytes match the cached source'
Ожидаются HTTP 200 и HIT. Совпадение байтов — полезное дополнительное наблюдение, но авторитетными признаками считаются заголовок ответа HIT и соответствующая запись в журнале Dashboard. Сохранение в кэше AI Gateway выполняется асинхронно, а данные кэша могут исчезать, поэтому не отправляйте два запроса одновременно. Если последовательный повтор всё ещё завершился с MISS, подождите несколько секунд и один раз повторите этот блок без изменений.
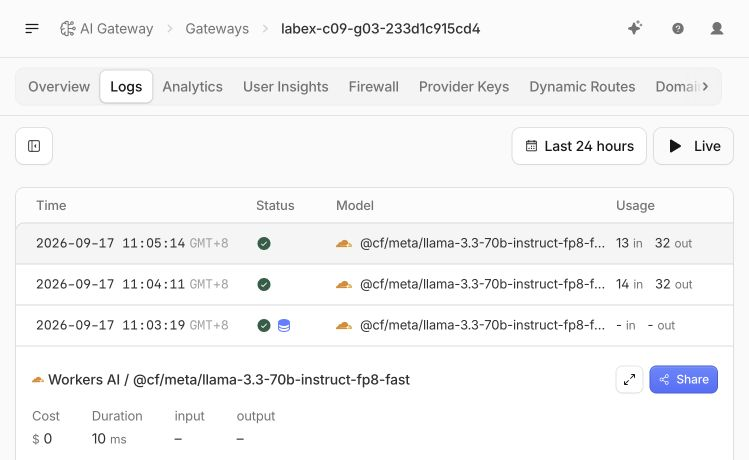
Откройте представление Logs для шлюза в Dashboard. Найдите два запроса public-faq и сравните их индикаторы кэша, длительность и использование токенов. В одной строке должен отображаться промах с обращением к модели, а в другой — попадание в кэш.
Измените вопрос и наблюдайте новый промах кэша
На этом шаге вы измените только текст запроса. Полное тело запроса участвует в формировании стандартного ключа кэша, поэтому новый вопрос не должен получить предыдущий ответ.
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"changed-question","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/changed-headers.txt \
  -o .labex/changed-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, name one benefit of an AI gateway.","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/changed-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/changed-headers.txt \
  | tail -1 | tee .labex/changed-cache-status.txt
node -e 'const b=require("./.labex/changed-response.json"); console.log(b.result?.response ?? b.result)'
Ожидаются HTTP 200 и MISS. Такое поведение при точном совпадении намеренно уже, чем сопоставление по смыслу: даже два похожих вопроса имеют разные тела и разные записи в кэше.
Не заменяйте стандартный ключ одним общим ключом, например support-answer, для персонализированных запросов. Пользовательский ключ безопасен только тогда, когда каждый запрос, объединённый под этим ключом, имеет право получить тот же ответ.
Обойдите кэш, когда требуется свежий результат
На этом шаге вы снова зададите исходный вопрос, но явно пропустите его закэшированный ответ. Bypass означает «запросить ответ у провайдера сейчас», даже если действующая запись уже есть в кэше. Это полезно, когда приложению нужен свежий результат для конкретного запроса.
Заголовок cf-aig-skip-cache: true действует только для этого запроса. Он не отключает кэш шлюза для других пользователей:
GATEWAY_TOKEN=$(cat .labex/gateway-token)
UPSTREAM_TOKEN=$(cat .labex/upstream-token)
METADATA='{"lab":"g03-cache","case":"fresh-bypass","synthetic":true}'
STATUS=$(curl --http1.1 -sS -D .labex/bypass-headers.txt \
  -o .labex/bypass-response.json -w '%{http_code}' \
  -H "cf-aig-authorization: Bearer $GATEWAY_TOKEN" \
  -H "Authorization: Bearer $UPSTREAM_TOKEN" \
  -H "cf-aig-metadata: $METADATA" \
  -H 'cf-aig-skip-cache: true' \
  -H 'Content-Type: application/json' \
  --data '{"prompt":"In one short sentence, what does an AI gateway do?","max_tokens":32}' \
  "https://gateway.ai.cloudflare.com/v1/$ACCOUNT_ID/$GATEWAY_ID/workers-ai/$MODEL")
unset GATEWAY_TOKEN UPSTREAM_TOKEN METADATA
printf '%s\n' "$STATUS" | tee .labex/bypass-status.txt
awk 'BEGIN{IGNORECASE=1} /^cf-aig-cache-status:/ {gsub("\r","",$2); print toupper($2)}' .labex/bypass-headers.txt \
  | tail -1 | tee .labex/bypass-cache-status.txt
node -e 'const b=require("./.labex/bypass-response.json"); console.log(b.result?.response ?? b.result)'
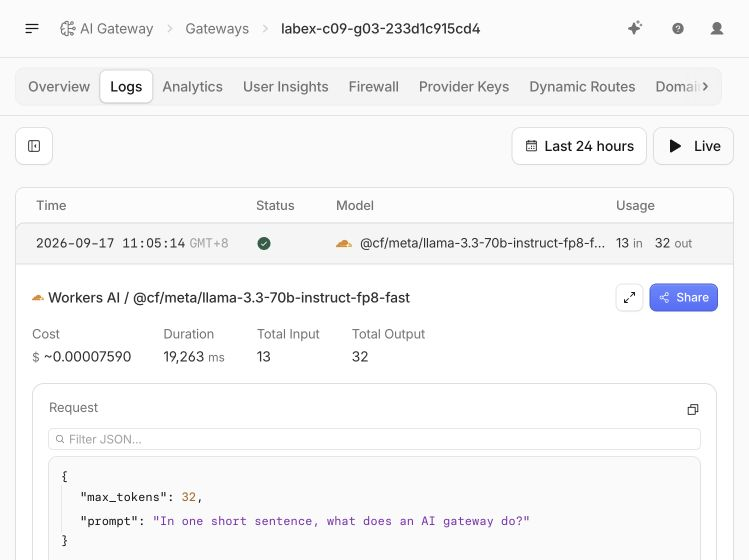
Ожидаются HTTP 200 и отсутствие HIT. В зависимости от текущего ответа шлюза заголовок может описать обход кэша или просто остаться в состоянии, отличном от попадания. Авторитетным доказательством служит запись в журнале шлюза: для fresh-bypass должно быть указано cached: false.
Вернитесь в Dashboard к разделу Logs и откройте запрос fresh-bypass. Сравните его со строкой закэшированного запроса public-faq. Тот же вопрос дошёл до Workers AI, поскольку обход для отдельного запроса переопределил стандартное поведение шлюза.
Удалите временный шлюз
На этом шаге вы удалите шлюз, пока учётные данные управления ещё могут подтвердить его отсутствие. Удаление принадлежащего вам шлюза также удаляет его краткоживущие пространство имён кэша и журналы.
ACCOUNT_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).accountId')
GATEWAY_ID=$(node -p 'JSON.parse(require("fs").readFileSync(".labex/state.json")).gatewayId')
GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS -X DELETE \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways/$GATEWAY_ID" \
  | node -e 'let s="";process.stdin.on("data",d=>s+=d).on("end",()=>{const b=JSON.parse(s);if(!b.success)process.exit(1);console.log("gateway deletion accepted")})'
unset GATEWAY_TOKEN

GATEWAY_TOKEN=$(cat .labex/gateway-token)
curl --http1.1 -fsS \
  -H "Authorization: Bearer $GATEWAY_TOKEN" \
  "https://api.cloudflare.com/client/v4/accounts/$ACCOUNT_ID/ai-gateway/gateways" \
  > .labex/gateways-after-delete.json
unset GATEWAY_TOKEN
node -e 'const b=require("./.labex/gateways-after-delete.json"),id=process.argv[1],found=(b.result||[]).some(g=>g.id===id);console.log("gateway absent:",!found);if(found)process.exit(1)' "$GATEWAY_ID"
Ожидается gateway absent: true. Этот аутентифицированный инвентарь отличает настоящее удаление от отсутствия страницы из-за выхода из системы или сбоя сети.
Удалите токен и выйдите из системы
На этом шаге вы отзовёте оставшиеся облачные учётные данные, удалите обе временные копии токена и отключите виртуальную машину.
В Cloudflare Dashboard откройте My Profile → API Tokens. Найдите точное сохранённое имя tokenName, откройте Actions, выберите Delete, проверьте подтверждение и удалите только этот токен. Теперь его можно безопасно отозвать, поскольку удаление шлюза уже подтверждено.
Удалите файлы токенов шлюза и вышестоящего сервиса, затем завершите отдельную авторизацию Wrangler:
shred -u .labex/gateway-token .labex/upstream-token
npx wrangler logout
npx wrangler whoami --json || true
test ! -e .labex/gateway-token -a ! -e .labex/upstream-token \
  && echo "local token files removed"
Ожидаются loggedIn: false и local token files removed. Сеанс Dashboard отдельный и останется активным. После завершения лабораторной работы LabEx уничтожит эту временную виртуальную машину, не сохраняя её.
Итоги
Вы настроили короткоживущий кэш ответов AI Gateway для одного безопасного общедоступного вопроса. Первый запрос дал MISS, точный повтор — HIT, а изменённый ввод создал отдельную запись. Затем вы использовали обход кэша для запроса, которому требовался свежий результат, и по журналам подтвердили, что его обработала модель, а не закэшированная копия.
В следующей лабораторной работе появятся ограничения трафика. Вы узнаете разницу между ограничением частоты поступления запросов и ограничением объёма ресурсов модели, который шлюз может расходовать, сохраняя объём тестов и стоимость намеренно небольшими.