工作流结果会给出总体状态。要弄清失败原因,先展开失败的作业,再按顺序看各个步骤。如果前面的步骤没有成功完成,后面的步骤可能被跳过。
持续集成 · 第 5 课
工作流日志
找到工作流中失败的步骤,读出第一条能指导排查的日志消息。
找到最早的失败
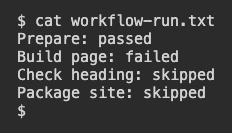
下面是一次模拟的运行,列出了网页检查作业中每个步骤的状态。
Prepare: passed
Build page: failed
Check heading: skipped
Package site: skipped
先看 Build page。跳过的检查没有给出网页结果。修复失败原因后,重新运行工作流,再核对后续步骤。
应该先查看哪个步骤的输出?
根据错误消息排查
失败步骤显示了下面几行。
Run cp index.html dist/index.html
cp: cannot create regular file 'dist/index.html': No such file or directory
Process completed with exit code 1.
错误消息写出了目标路径。如果父目录 dist 不存在,复制命令就无法在里面创建文件。查看复制之前是否有命令创建了该目录。退出码 1 表示命令失败,具体该查哪里则要看错误消息。
已知 dist 不存在,哪项改动能解决报告的问题?
检查重新运行的结果
修复构建问题后,检查新一次运行对应的修订版本及各步骤状态。复制成功说明输出文件已经生成。要确认整个流程通过,还要看测试和打包的结果。报告问题时,把第一条有助于排查的错误与对应的步骤名一起记录下来。
新的运行结果显示 Build page 通过,Check heading 失败。现在有什么变化?
课程已完成
你已完成 工作流日志
现在,你可以结合步骤顺序解读工作流失败。
找出最早实际运行但没有成功的步骤。
用日志内容确定要检查的地方。
修复后检查新版本及后续步骤的结果。